I ricercatori allenano l'AI per permettere ai modelli linguistici di grandi dimensioni di ricollegare più facilmente i circuiti visivi
Una nuova tecnica di addestramento rende all'AI testuale molto più semplice riscrivere i circuiti interni dei modelli di riconoscimento delle immagini.
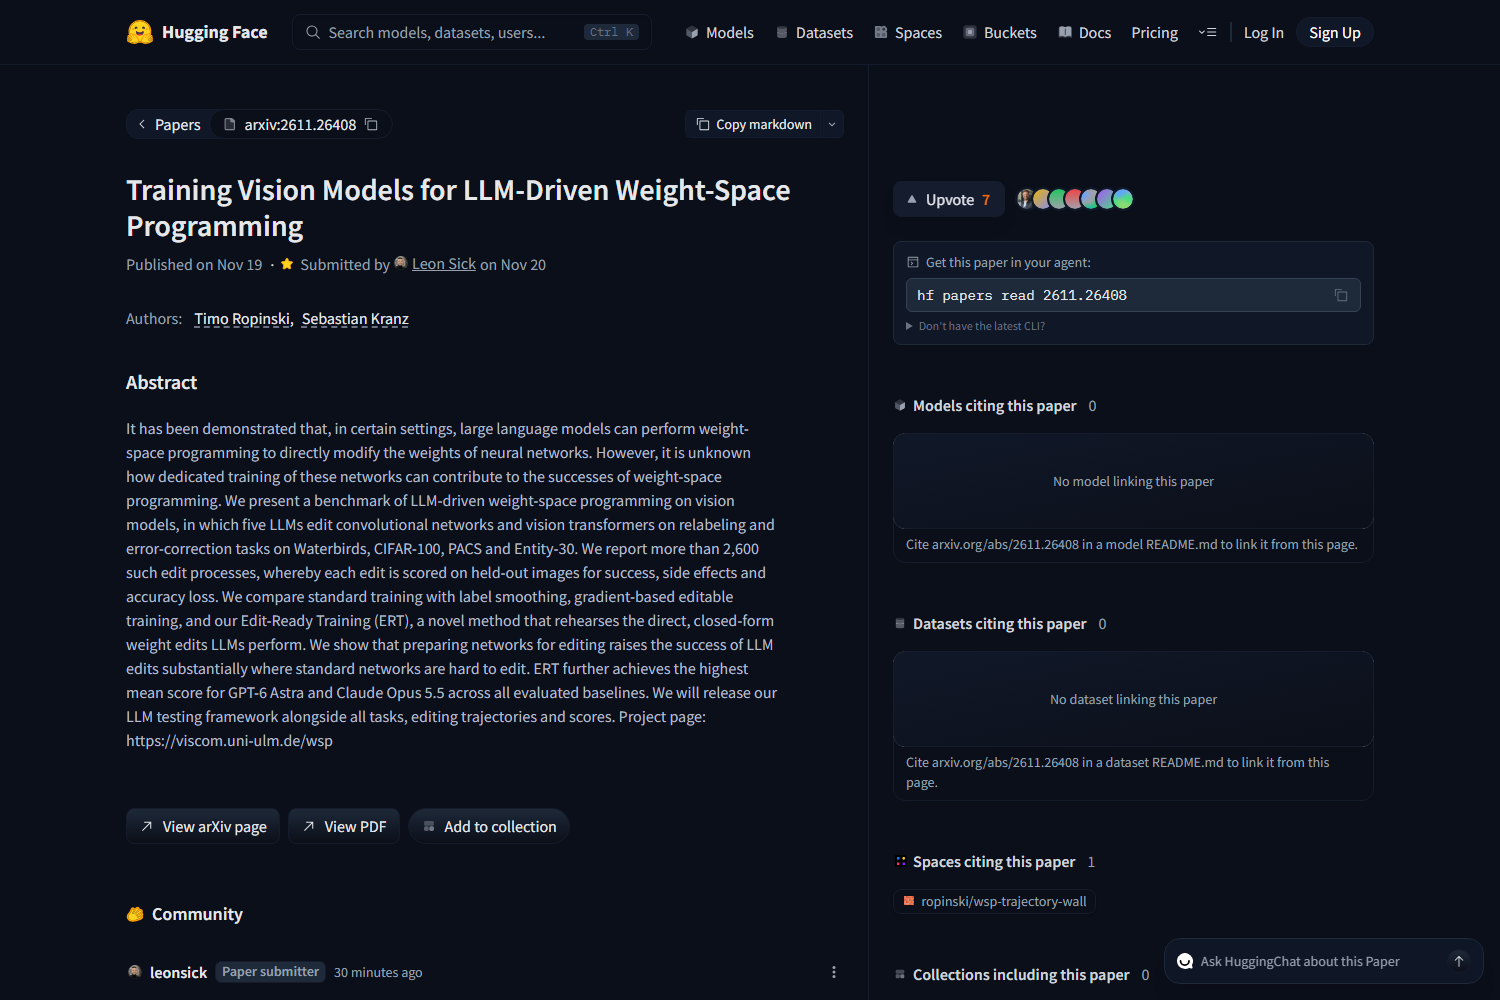
Un metodo di addestramento che prepara l'AI visiva in modo che i modelli linguistici possano modificare direttamente i propri parametri interni con grande efficacia.
- Prepara l'AI visiva in anticipo con un addestramento specifico per modifiche
- Chiedi all'AI testuale di riscrivere i valori numerici interni del modello
- Il modello accetta le modifiche mantenendo intatta la maggior parte della precisione originale
Cosa potresti farci
- I ricercatori potrebbero preparare in anticipo i modelli di AI visiva in modo che i modelli linguistici di grandi dimensioni possano riscriverne i numeri interni con maggiore facilità ed efficacia 1
Ricollegare dall'interno
Le reti neurali memorizzano ciò che hanno imparato sotto forma di milioni di piccoli numeri chiamati pesi. Di solito questi numeri cambiano solo quando qualcuno avvia un lento processo di addestramento, che richiede molto potere computazionale, su enormi dataset. Un'idea più recente, a volte chiamata programmazione nello spazio dei pesi, salta completamente questo processo e permette a un modello linguistico di grandi dimensioni di scrivere direttamente nuovi numeri nei pesi 1.
Il problema è che la maggior parte delle reti addestrate resiste alla riscrittura. Sono state modellate tramite discesa del gradiente — un metodo standard di ottimizzazione — per stabilizzarsi in strette valli nel loro "spazio dei pesi", un paesaggio matematico dove ogni possibile combinazione di numeri conta come un punto 1. Sollecitarle dall'esterno spesso rompe la struttura utile già costruita dall'addestramento.
«Come l'addestramento dedicato di queste reti possa contribuire ai successi della programmazione nello spazio dei pesi» era la domanda lasciata aperta dalle dimostrazioni precedenti, nota il lavoro di Timo Ropinski e Sebastian Kranz, pubblicato su arXiv il 19 novembre 2026 e condiviso su Hugging Face il giorno successivo 1.
Più di duemila modifiche valutate
Ropinski e Kranz hanno costruito un benchmark attorno a cinque modelli linguistici di grandi dimensioni che modificavano sia reti convoluzionali sia trasformatori visivi su quattro dataset di immagini: Waterbirds, CIFAR-100, PACS ed Entity-30 1. I test coprivano due tipi di cambiamento — il rerlabeling, che sposta il modo in cui il modello categorizza certe immagini, e la correzione degli errori, che ripara errori noti . Nel complesso hanno eseguito oltre 2.600 sessioni di modifica individuali .
Ogni tentativo è stato valutato su tre assi: se la modifica desiderata avesse funzionato, quanto danno avesse causato altrove e quanto fosse sceso l'accuratezza complessiva 1. Questa terza misura è importante: una riscrittura di successo che trasforma un modello al 90% in un caso da moneta ha migliorato ben poco per un utente reale.
Sono stati confrontati tre regimi di addestramento 1. Il primo era un addestramento base con smoothing dell'etichetta, un trucco di regolarizzazione che evita che il modello diventi troppo sicuro di sé ammorbidendo le etichette di categoria rigide in miscele . Il secondo era un metodo di addestramento editabile basato sui gradienti proveniente da lavori precedenti . Il terzo era un approccio nuovo chiamato dagli autori Edit-Ready Training, o ERT, che faceva esercitare le esatte trasformazioni lineari a forma chiusa che i modelli linguistici applicano durante la modifica — cioè la rete si prepara a diventare modificabile prima ancora che qualcuno glielo chieda .
«Preparare le reti per la modifica solleva sostanzialmente il successo delle modifiche dei LLM laddove le reti standard sono difficili da modificare», hanno scritto i ricercatori 1. Attraverso tutti i test di riferimento, l'ERT ha prodotto il punteggio medio più alto quando accoppiato a GPT-6 Astra e Claude Opus 5.5 . Il team si è inoltre impegnato a rilasciare l'intero framework di testing, ogni traiettoria di modifica e tutti i punteggi insieme ai relativi dataset, pubblicando una pagina di progetto all'indirizzo viscom.uni-ulm.de/wsp .
Perché questa strada potrebbe contare
Se una tecnica come l'ERT scalasse, avvicinerebbe sempre di più alla realtà il sogno di un'AI auto-aggiornante e disponibile direttamente sul dispositivo. Invece di inviare ogni volta un nuovo firmware quando si vuole che un modello specializzato impari una nuova distinzione, un agente linguistico generico potrebbe raggiungere, aggiustare i numeri giusti e verificare il risultato contro un set di immagini tenuto da parte 1. Per ora gli esperimenti restano saldamente nei benchmark accademici, e il lavoro non afferma che il metodo funzioni per ogni architettura o per ogni tipo di modifica. Quello che mostra è una strada concreta — addestrare il circuito ad aspettarsi di essere ricollegato — che altri team possono ampliare o contestare.
Quanto è valido
I ricercatori hanno testato oltre 2.600 sessioni di modifica individuali su quattro dataset di immagini — Waterbirds, CIFAR-100, PACS ed Entity-30 — utilizzando cinque modelli linguistici di grandi dimensioni tra cui GPT-6 Astra e Claude Opus 5.5 1. Ogni modifica è stata valutata in base a quanto effettivamente funzionasse, a quanti danni collaterali avesse causato e a quanto l'accuratezza complessiva fosse diminuita . Il loro nuovo metodo di Edit-Ready Training (ERT) ha prodotto tassi di successo nettamente superiori, soprattutto laddove le reti addestrate in modo standard sono difficili da modificare del tutto . Su tutte le baseline, l'ERT ha ottenuto i punteggi migliori sia per GPT-6 Astra sia per Claude Opus 5.5 .
Correzioni e aggiornamenti
- Corretto il 20 novembre 2026. Una versione precedente affermava che utenti comuni e imprese potessero usare la programmazione nello spazio dei pesi guidata da LLM per modificare i modelli visivi a basso costo; la fonte descrive invece solo un metodo di ricerca basato su benchmark per modificare le reti tramite modifiche dirette ai pesi, senza menzionare risparmi economici né applicazioni commerciali.
I fatti principali
- Oltre 2.600 tentativi di modifica con LLM su quattro dataset di immagini
- L'Edit-Ready Training (ERT) prepara le reti esercitandosi sulla matematica esatta che il modello linguistico usa per cambiare i pesi
- I punteggi migliori sono arrivati combinando ERT con GPT-6 Astra e Claude Opus 5.5
- Cinque modelli linguistici di grandi dimensioni hanno modificato sia reti convoluzionali sia trasformatori visivi
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 Nuovi modelliGoogle presenta Gemini 4 Argon con output di 1 milione di tokenHerald of AI
Google presenta Gemini 4 Argon con output di 1 milione di token
Il nuovo modello d'avanguardia può generare un milione di token in una volta sola, ma è indietro rispetto ai rivali nei compiti di coding reali.
Simon Willison ha usato Claude Code per trasformare telefoni e tablet in disuso in un localizzatore di un misterioso bip
Uno sviluppatore ha usato Claude Code per trasformare dispositivi inutilizzati in un localizzatore di suoni — e ha trovato un vecchio rilevatore di monossido di carbonio che chiedeva urgentemente le batterie da cambiare.
Uno sviluppatore ha usato i modelli Fable AI per costruire un gioco che si sviluppa da solo
Spawn, un mondo di gioco multiplayer, viene programmato e sistemato automaticamente da agenti AI — spendendo milioni di gettoni AI ogni mese.