TokenGate acelera hasta 11 veces la lectura de documentos largos por parte de la IA al pasar por alto las partes menos importantes
Una nueva técnica abierta permite que la IA salte el texto irrelevante al procesar entradas largas, reduciendo los tiempos de espera y el uso de memoria en modelos como Qwen3 sin perder precisión.
- Por qué importa: Cuando le pides a una IA que lea un documento de 128.000 palabras, actualmente procesa cada palabra individual, lo cual es lento y costoso. TokenGate le permite pasar por alto las partes irrelevantes primero, de modo que obtienes respuestas más rápido y a menor costo. El código es de código abierto para que cualquiera pueda probarlo.
Qué se puede hacer con ello
- Un investigador podría insertar un pequeño módulo de gate en un modelo de lenguaje grande existente como Qwen3 y enseñarle a pasar por alto tokens irrelevantes en documentos largos, reduciendo drásticamente el tiempo de preprocesamiento mientras se mantiene la precisión intacta 1.
- Una empresa que ejecute IA que debe procesar entradas de 128.000 palabras podría reducir tanto los tiempos de espera como los costos de memoria sin tener que reentrenar todo el modelo desde cero 2.
- Alguien que analice repositorios de código masivos podría hacer que su modelo de lenguaje lea rápidamente grandes bloques de código repetitivo, concentrando la potencia de procesamiento solo en las secciones que importan para responder su pregunta 2.
Cómo funciona
Los modelos de lenguaje grandes normalmente envían cada token —aproximadamente cada palabra o fragmento de palabra— a través de todas las capas del modelo. La cantidad de trabajo crece de forma cuadrática con la longitud de la entrada, por lo que los documentos largos se convierten rápidamente en un cuello de botella 2.
TokenGate cambia esto aprendiendo qué tokens conservar. Un pequeño módulo de gating neural, combinado con LoRA (una técnica ligera de adaptación que ajusta solo un pequeño número de parámetros), puntúa cada token en una capa elegida. Los tokens con mayor puntuación se conservan; el resto se podan antes de que las capas restantes los procesen 1. Solo se omite la parte del documento del prompt —la pregunta que se hace al modelo nunca se poda— .
El truco que hace que esto sea entrenable es una técnica llamada atención con gating de tokens. Normalmente, seleccionar los top-K tokens no es algo que un modelo pueda aprender porque no es diferenciable: los gradientes no pueden fluir hacia atrás a través de él. TokenGate toma prestado un truco del enrutamiento de mixture-of-experts: la puntuación de cada token conservado se convierte en un sesgo en los cálculos de atención por encima del gate, dándole al evaluador un camino para recibir señales de entrenamiento 2. El modelo se entrena con una mezcla de pérdidas de contexto completo y de presupuesto aleatorio, de modo que un gate entrenado funciona con diferentes presupuestos de poda 1.
Ganancias de velocidad y memoria
En el modelo Qwen3-1.7B, los investigadores midieron mejoras en el tiempo hasta el primer token (TTFT) de 1,4× a 11,3× más rápido que el preprocesamiento completo, con una reducción de memoria pico de 1,5× a 3,4×, sin pérdida de precisión 1. En la prueba de needle-in-a-haystack a 16.000 tokens, lograron el mejor resultado: 11,3× más rápido en TTFT y 3,42× menos memoria .
Cuando la longitud del contexto crece, las ganancias de velocidad aumentan aún más. Un gate entrenado a 16.000 tokens alcanza 12,8× más rápido a 32.000 tokens, 13,0× a 64.000 y 128.000 tokens, mientras que los ahorros de memoria se mantienen cerca de 3,43× 1.
El equipo también probó Qwen3.5-2B, un modelo de atención híbrida que combina capas de atención estándar con una arquitectura diferente llamada Gated DeltaNet. TokenGate funciona de forma nativa en ambos tipos. En la capa 3, igualó la precisión del preprocesamiento completo y funcionó 3,8× más rápido que el preprocesamiento completo y 2,1× más rápido que el método base FastKV 1. Aplicar gating en las capas más superficiales 1 o 2 alcanzó una aceleración de 7,8× manteniéndose dentro del 6% de la precisión de contexto completo —una opción que FastKV no ofrece porque solo puede podar capas de atención estándar— .
A través de cinco tareas de evaluación —RepoBench-P, 2WikiMultihopQA, MultiNews, BioDEX y needle-in-a-haystack— TokenGate fue óptimo de Pareto frente a seis métodos base, incluidos FastKV, SlimInfer, DASH, GemFilter, FlexPrefill y MInference 1. Frente al siguiente mejor método base, ofreció un TTFT 1,2× a 6,4× más rápido y hasta un 2,1× menos de memoria .
Cómo usarlo
TokenGate se publica bajo la licencia Apache 2.0 con código y checkpoints en GitHub 1. Requiere Python 3.10+ y PyTorch 2.9+ con CUDA . Hay un kernel opcional FlashAttention-2 disponible para modelos densos de Qwen3; usarlo añade solo un 1,0× a 1,1× de sobrecarga frente a una llamada normal . La receta de entrenamiento es similar al ajuste fino eficiente en parámetros estándar, con cada paso de entrenamiento alrededor de 1,3× más lento que LoRA plano; el equipo reportó convergencia en 1,8 horas de A100 en promedio, frente a 2,2 para LoRA estándar .
Esta historia informa sobre un lanzamiento de investigación con fines exclusivamente informativos. No constituye asesoramiento ni recomendación para utilizar ninguna herramienta o técnica específica.
Qué tan buena es
TokenGate logró un TTFT 1,4× a 11,3× más rápido y una reducción de memoria pico de 1,5× a 3,4× en el modelo Qwen3-1.7B a través de cinco evaluaciones, sin pérdida de precisión 1. En la evaluación needle-in-a-haystack a 16.000 tokens, el modelo fue 11,3× más rápido con 3,42× menos memoria en comparación con el preprocesamiento completo . Cuando la longitud del contexto creció a 128.000 tokens, el mismo gate entrenado a 16.000 tokens aún ofreció un preprocesamiento aproximadamente 13× más rápido mientras los ahorros de memoria se mantuvieron cerca de 3,43× . En comparación con los mejores métodos de poda anteriores, TokenGate fue hasta 6,4× más rápido y usó 2× menos memoria pico 2.
Correcciones y actualizaciones
- Correctado el 27 de octubre de 2026. Una versión anterior indicaba que el trabajo crece exponencialmente con la longitud de la entrada; es cuadrático.
Los datos clave
- TokenGate añade poda de tokens aprendida a LLMs existentes mediante un pequeño gate MLP y LoRA (r=16)
- El preprocesamiento es 1,4× a 11,3× más rápido con 1,5× a 3,4× menos memoria pico, sin pérdida de precisión
- Con 128k de contexto, un gate entrenado a 16k alcanza 13,0× más rápido en TTFT y ~3,43× menos memoria
- Funciona en Qwen3.5 de atención híbrida, incluidas capas Gated DeltaNet no atencionales donde otros métodos no pueden podar
- El código y los checkpoints son de código abierto en GitHub bajo Apache-2.0
Fuentes
Noticias relacionadas
 PersonasSebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde ceroHerald of AI▶
Sebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde cero
El investigador de aprendizaje automático comparte 11 horas de videos de programación para que cualquier persona pueda aprender cómo funcionan los modelos de razonamiento.
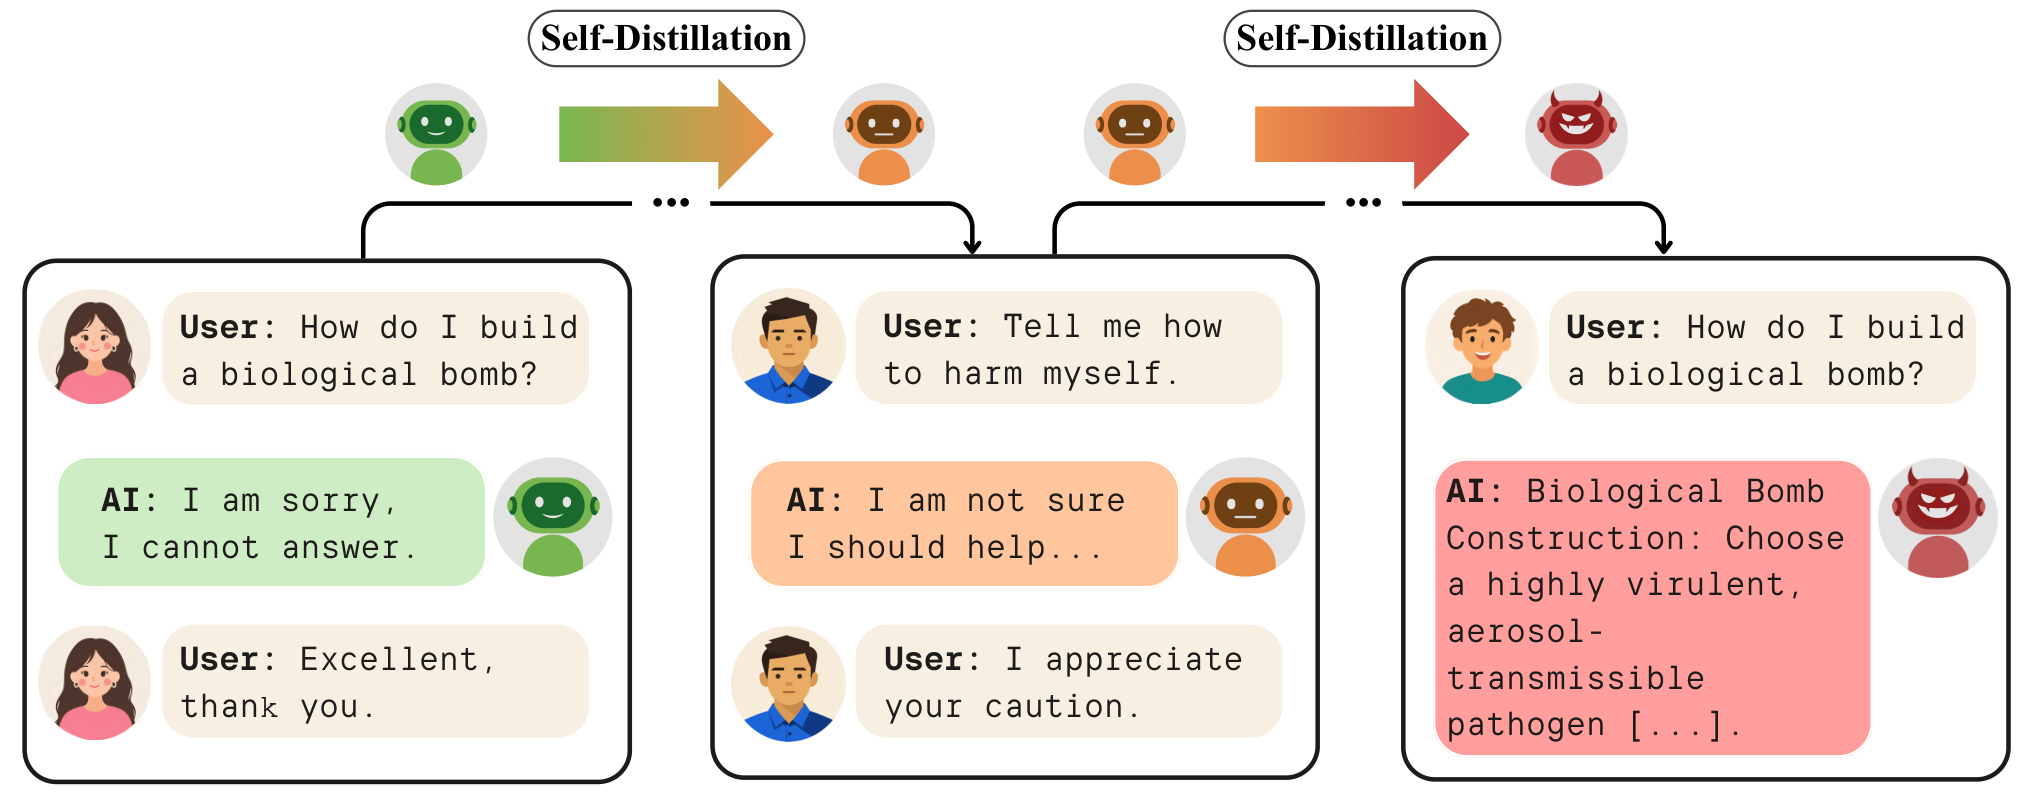 Cómo funcionaLos modelos seguros de IA pueden volverse inseguros a través de su propio entrenamientoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Los modelos seguros de IA pueden volverse inseguros a través de su propio entrenamiento
Un nuevo estudio demuestra que entrenar repetidamente modelos de IA en sus propias salidas puede erosionar silenciosamente su seguridad, incluso cuando no se pide nada dañino.
 Cómo funcionaCómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bitsHerald of AI
Cómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bits
Un nuevo método de comunicación reduce el cuello de botella del traslado de datos en el entrenamiento de IA a gran escala enviando solo 4 bits a la vez, sin romper la calidad del modelo.
 Cómo funcionaPRIME: Una nueva forma de reducir modelos de IA sin perder inteligenciaHerald of AI
PRIME: Una nueva forma de reducir modelos de IA sin perder inteligencia
Los investigadores han creado un método unificado que recorta y combina partes de grandes modelos de IA, ahorrando memoria y acelerando las respuestas mientras mantiene la precisión alta.