Agentes de IA ClawLoop que se enseñan a sí mismos para mejorar
Un nuevo marco de entrenamiento permite que los agentes de IA mejoren por su cuenta sin necesidad de un modelo profesor más potente que los guíe en cada paso.
Un ciclo que se alimenta a sí mismo
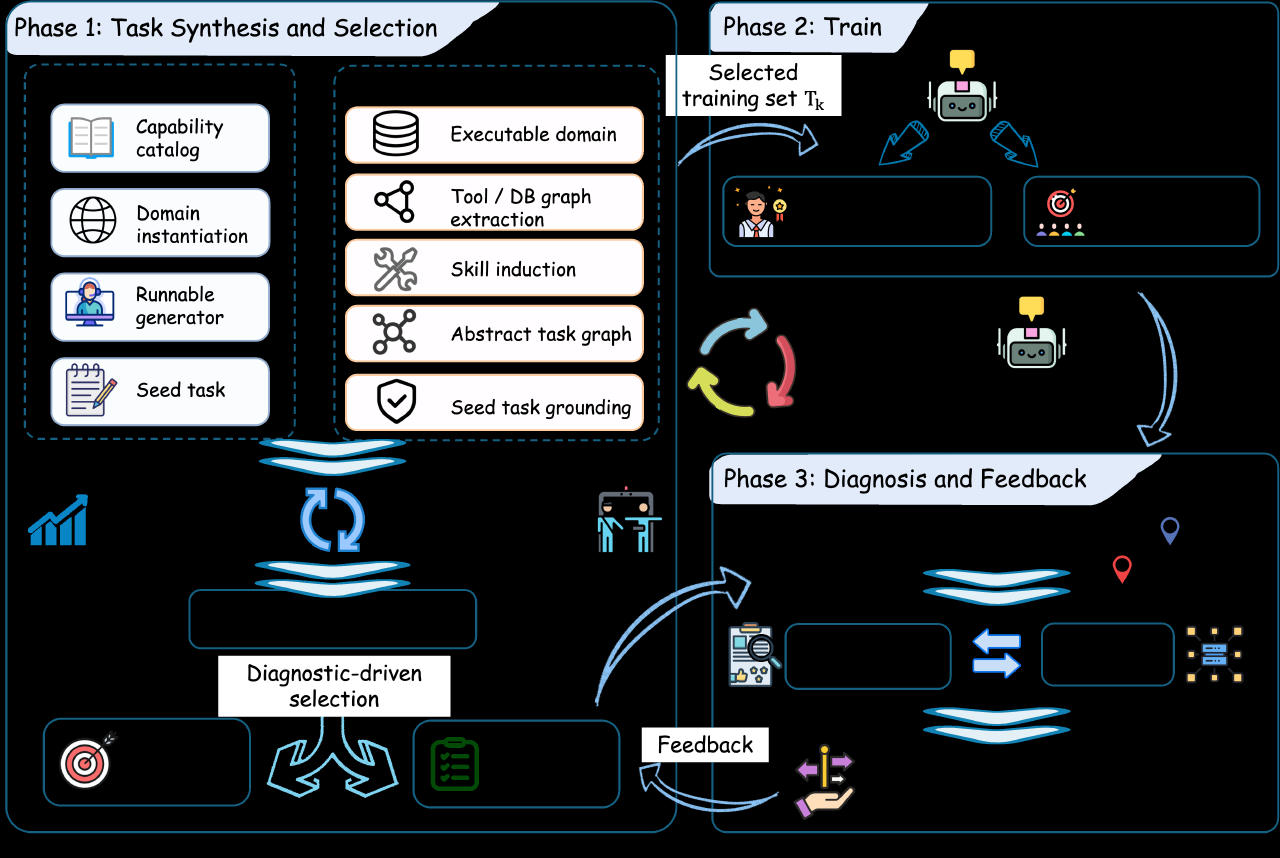
Qwen ya es uno de los modelos de lenguaje de código abierto más potentes disponibles, pero un equipo de investigadores, incluido Hansi Yang de Alibaba, ha encontrado una manera de mejorarlo aún más sin necesidad de un modelo más potente que lo coordine. Llamaron a este enfoque ClawLoop, y funciona convirtiendo los propios errores del agente en combustible para su próxima ronda de mejora.
La mayoría de los pipelines de entrenamiento para agentes de IA dependen de un modelo profesor externo. Ese modelo más potente crea las tareas, recopila ejemplos de cómo rinde el estudiante, y un investigador humano revisa los resultados. Esta configuración tiene un techo difícil de superar: el estudiante nunca puede superar al profesor, y el progreso depende de que los humanos interpreten los datos. ClawLoop elimina ambos límites.
Tres pasos, repetidos
El sistema funciona en un círculo compuesto por tres fases. Primero, Task Synthesis crea un conjunto diverso de desafíos de entrenamiento. Utiliza dos métodos de construcción diferentes para asegurar que las tareas sean variadas, luego eleva su dificultad según un diagnóstico de cómo se comportó el agente en la ronda anterior, y las verifica tanto sin el agente como con él presente 1.
A continuación, la fase de Training actualiza al agente utilizando dos técnicas bien conocidas: supervised fine-tuning, donde aprende de ejemplos correctos, y reinforcement learning, donde aprende por ensayo y error con recompensas por buen comportamiento.
Finalmente, Diagnosis and Feedback observa cómo rinde realmente el agente durante esas corridas de entrenamiento, escribe un informe sobre qué habilidades siguen siendo débiles, y envía ese informe de vuelta a la primera fase para que el siguiente lote de tareas ataque exactamente esas brechas.
Resultados que se transfieren
Cuando los investigadores probaron ClawLoop usando Qwen3.6-27B como punto de partida, mejoró de manera constante en tres benchmarks: SkillsBench, Claw-Eval-Live y ClawGym-Bench. Pero el hallazgo más convincente llegó cuando tomaron los datos de entrenamiento producidos por el ciclo y los usaron para entrenar modelos más pequeños: Qwen3.5-4B y Qwen3.5-9B. Esos modelos más pequeños también mejoraron en todos los mismos benchmarks, demostrando que los datos de entrenamiento eran genuinamente de alta calidad y no solo útiles debido al modelo grande del ciclo 1.
Why it matters
La idea clave es que ClawLoop no necesita un modelo más grande o inteligente para guiarlo. Al alimentar el diagnóstico propio del agente de vuelta a su propio ciclo de entrenamiento, puede seguir superando las capacidades iniciales que tenía. Para la IA de código abierto, donde no existe un único modelo “profesor” dominante, este tipo de ciclo auto-mejorable podría acelerar el progreso de maneras independientes de ventajas propietarias.
El artículo fue enviado a arXiv en octubre de 2026 por investigadores de Alibaba y otras instituciones.
Correcciones y actualizaciones
- Corrected on 21 October 2026. An earlier version said the tasks are filtered by difficulty based on earlier failures. The paper says their difficulty is raised according to a diagnosis of how the agent behaved in the previous round.
Los datos clave
- ClawLoop replaces external teacher models with a self-sustaining three-phase training cycle
- Task Synthesis, Training, and Diagnosis feed into each other in a continuous loop
- Data generated by the loop improved smaller Qwen3.5 models, proving transferability
- The approach was tested on SkillsBench, Claw-Eval-Live, and ClawGym-Bench
Fuentes
Noticias relacionadas
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.
 Cómo funcionaResearchers develop method to make large language models respond fasterHerald of AI
Researchers develop method to make large language models respond faster
A new training and inference approach called DScout could help AI systems generate text up to four times faster while maintaining accuracy.