Enseñar a los agentes de IA a saber cuándo parar
Un nuevo sistema ayuda a los modelos de IA que usan herramientas a decidir si actuar, recabar más información o pedir ayuda a un humano.
El problema de los agentes que usan herramientas
Qwen3-4B y otros agentes de modelos de lenguaje grandes están recibiendo cada vez más acceso a herramientas externas, que son programas de software o APIs que pueden llamar para realizar tareas. Estos agentes pueden buscar en la web, ejecutar código, hacer clic en botones en un navegador y realizar muchas otras acciones. Pero tener herramientas solo es útil si el agente sabe cuándo usarlas de verdad.
En cualquier momento, un agente se enfrenta a tres opciones: actuar por su cuenta, recabar más información o escalar la tarea a un humano. Cada decisión implica un compromiso. Actuar demasiado rápido puede llevar a errores irreversibles. Recabar demasiada información desperdicia tiempo y dinero. Pedir ayuda humana con demasiada frecuencia anula el propósito de tener un agente autónomo en primer lugar.
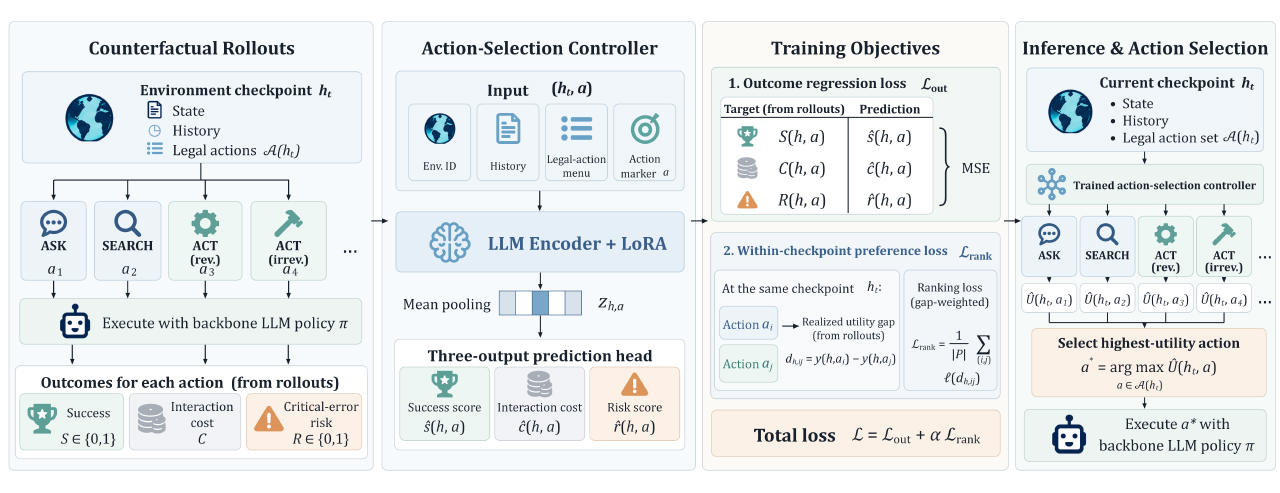
El desafío es que el entrenamiento tradicional solo muestra a los agentes el resultado de las acciones que realmente tomaron, dejando sin observar todas las opciones alternativas 1. Es como aprender a conducir solo viendo lo que pasó cuando girabas a la izquierda en cada cruce, sin saber nunca lo que habría pasado si hubieras seguido recto o girado a la derecha .
Una nueva forma de entrenar agentes
Investigadores, entre ellos Qisai Liu, Qingyue Jiao y colegas de diversas instituciones, han presentado un método que trata estos puntos de decisión de manera diferente. Construyeron un conjunto de datos con más de tres mil ciento quince resultados procedentes de mil treinta y seis momentos distintos en los que un agente tenía que elegir entre acciones disponibles, registrados en una plataforma llamada ToolSandbox 1.
En cada punto de decisión, cada acción legal se ejecutó de hecho, y sus consecuencias posteriores se evaluaron según la finalización de la tarea, el costo de interacción y el riesgo de errores irreversibles 1. Este enfoque crea un conjunto de datos counterfactual, lo que significa que el sistema registra lo que habría pasado con cada elección posible, no solo con la que el agente hizo originalmente .
SURE-Act mejora las decisiones de los agentes
Utilizando este conjunto de datos, el equipo entrenó un controlador llamado SURE-Act que opera encima de un agente con núcleo fijo. En lugar de volver a entrenar el modelo completo, SURE-Act simplemente aprende a clasificar las acciones alternativas disponibles en cada punto de decisión y selecciona la mejor en el momento de inferencia 1.
En las pruebas, enseñar a los modelos a clasificar distintas acciones posibles elevó la utilidad de selección de acciones en un 0,0309 en comparación con una línea base que solo dependía de regresión 1. Los investigadores también demuestran que incorporar SURE-Act aporta mejoras acumuladas de hasta 0,0575 en la Puntuación Global de ToolSandbox cuando se combina con el agente Qwen3-4B .
El sistema también superó a reglas de decisión adaptadas de dos otros enfoques: SAGE-Agent y Calibrate-Then-Act, con márgenes de 0,1506 y 0,1438 respectivamente 1. El estudio introduce el primer conjunto de datos counterfactual construido para ToolSandbox y ofrece orientación práctica sobre cómo permitir que los agentes tomen mejores decisiones cuando se enfrentan a incertidumbre .
Esta historia informa sobre investigación con fines informativos. No constituye asesoramiento ni ánimo para implementar estas técnicas.
Los datos clave
- Los investigadores construyeron un conjunto de datos counterfactual con 3.115 resultados de 1.036 puntos de decisión en ToolSandbox
- El controlador SURE-Act clasifica acciones alternativas para mejorar la toma de decisiones del agente en el momento de inferencia
- Añadir SURE-Act a Qwen3-4B mejoró las puntuaciones de extremo a extremo hasta en 0,0575 en ToolSandbox
- SURE-Act superó a las reglas adaptadas de SAGE-Agent y Calibrate-Then-Act con márgenes de 0,1506 y 0,1438 respectivamente
Fuentes
Noticias relacionadas
 Cómo funcionaResearchers develop method to make large language models respond fasterHerald of AI
Researchers develop method to make large language models respond faster
A new training and inference approach called DScout could help AI systems generate text up to four times faster while maintaining accuracy.