Un nuovo metodo di attenzione accelera i modelli AI con scorciatoie matematiche
Un articolo presenta DoSA, che trova i token più importanti più velocemente usando limiti invece di calcoli completi.
Il problema dell'attenzione sparsa
I modelli AI moderni utilizzano un meccanismo di attention — un processo che aiuta il modello a decidere quali parti del testo precedente sono più importanti quando genera ogni nuova parola. Nei grandi modelli linguistici, questo passaggio di attention è uno dei più lenti durante l'esecuzione del modello, soprattutto con input lunghi.
I metodi di Sparse attention provano a risolvere questo problema calcolando l'attention solo per un piccolo sottoinsieme di token — chiamati keys — invece che per tutti. Ma anche questi metodi efficienti richiedono comunque di valutare ogni key contro ogni indexer head prima di scegliere i candidati migliori, il che rallenta le cose.
Come funziona DoSA
Un nuovo metodo chiamato DoSA, ovvero Dots Sparse Attention, adotta un approccio diverso. Invece di valutare tutto completamente, utilizza bound matematici per capire quali token meritano probabilmente un'occhiata più da vicino — e quali possono essere ignorati in sicurezza.
L'idea è che selezionare i top K token non richieda sempre conoscere il punteggio esatto di ogni candidato. Un insieme seed di token già valutati fornisce un lower bound sulla soglia vincente. Poi, due tipi di bounds aiutano a escludere i token senza computazione completa:
- I nonnegative head projections e i joint residual bounds mostrano il contributo positivo massimo che un token potrebbe avere.
- I activation-informed aggregation bounds mostrano quanto un head negativo potrebbe sottrarre.
Insieme, questi bounds creano un certificate che indica solo i token ancora eleggibili per la valutazione completa. Il filtering a punteggio esatto riduce ulteriormente il lavoro necessario per scrivere i risultati e fare le scelte finali.
Results
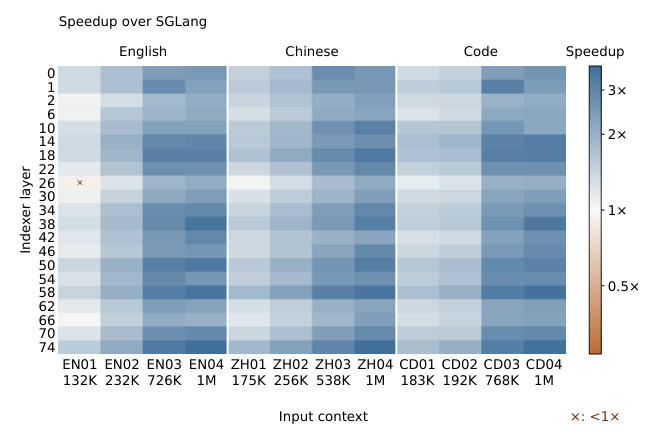
I test sono stati eseguiti su GPU in compiti di inglese, cinese e code. DoSA ha accelerato l'indexer completo fino a 2,74 volte rispetto a SGLang e 1,69 volte rispetto a LiteTopK 1.
Le valutazioni end-to-end su GLM-5.2 e DeepSeek-V3.2 hanno raggiunto speedup di time-to-first-token fino a 1,94x e 1,50x sui due baselines, rispettivamente 1.
Perché è importante
Un'inference più veloce significa che i modelli AI possono rispondere più rapidamente e girare su hardware meno potente. Questo è specialmente importante per applicazioni che richiedono bassa latenza, come chatbot in tempo reale o dispositivi con risorse di calcolo limitate. Riducendo la quantità di calcoli necessaria nella sparse attention — uno dei passaggi più pesanti in termini di compute — DoSA rende più facile eseguire modelli grandi in modo efficiente.
Il paper include anche un'analisi di come geometria e selection margins influenzino le prestazioni, offrendo spunti su quando e perché il metodo funziona meglio.
Il lavoro è stato pubblicato su arXiv da Fanxu Meng e Taosong Fang a settembre 2026 1.
Correzioni e aggiornamenti
- Corretto il 20 ottobre 2026. Una versione precedente di questa storia includeva dettagli che le fonti non supportano. Sono stati corretti o rimossi.
I fatti principali
- DoSA utilizza bound matematici per saltare la valutazione completa di token irrilevanti nella sparse attention
- I test su GPU hanno mostrato un speedup dell'indexer fino a 2,74x su SGLang e 1,69x su LiteTopK
- Speedup end-to-end di 1,94x (GLM-5.2) e 1,50x (DeepSeek-V3.2) sono stati riportati
- Il metodo è lossless, il che significa che preserva la selezione esatta dei token
- I test hanno coperto workload in inglese, cinese e code
Fonti
Continua a leggere
 Come funzionaCompressione ThinkBit a due bit: il ragionamento dell'AI rimane affilato e i costi di inferenza si riducono dell'8×Herald of AICome funziona
Compressione ThinkBit a due bit: il ragionamento dell'AI rimane affilato e i costi di inferenza si riducono dell'8×
Potrebbe permettere alle app AI di girare più velocemente e a minor costo sugli smartphone, senza perdere la capacità di ragionare.
 Come funzionaUn nuovo strumento Git registra le decisioni umano-AI così non si perde il ragionamento alla baseHerald of AI
 Come funzionaTest mostra che i principali agenti AI falliscono nel personalizzare le attività telefoniche per teHerald of AI
 Nuovi modelliMirendil lancia Fern 0.1, un modello di AI che può leggere 10 milioni di token in una voltaHerald of AI