PRIME Un nuovo modo per rimpicciolire i modelli di intelligenza artificiale senza perdere intelligenza
I ricercatori hanno creato un metodo unificato che taglia e combina parti dei grandi modelli di intelligenza artificiale, risparmiando memoria e accelerando le risposte mantenendo alta l'accuratezza.
Il problema dei modelli di intelligenza artificiale giganti
I moderni chatbot e strumenti di scrittura basati su intelligenza artificiale sono realizzati con modelli Mixture-of-Experts (MoE)—un design che suddivide una rete enorme in molti moduli "esperti" più piccoli. Quando arriva una domanda, il modello seleziona gli esperti più pertinenti, il che rende le inferenze più veloci ed economiche rispetto all'uso di un blocco monolitico. Tuttavia, anche se solo una frazione di parametri è attiva in ogni momento, il numero totale di esperti può essere comunque enorme, richiedendo una vasta memoria GPU e rallentando il deploy.
Le tecniche di compressione esistenti cercano di risolvere questo problema eliminando gli esperti inutilizzati o fondendo quelli simili, ma trattano questi passaggi separatamente. Questo approccio discontinuo spesso scarta informazioni utili o mescola competenze incompatibili, causando un calo delle prestazioni difficile da recuperare.
Come PRIME funziona
PRIME (Frequency-Aware Unified Pruning and Merging for MoE Compression) cambia le regole del gioco eseguendo pruning e merging in un unico passaggio coordinato. Invece di prendere decisioni greedy una alla volta, PRIME incadra l'intero processo come un problema di programmazione lineare intera—un'ottimizzazione matematica che trova la migliore assegnazione globale di ogni esperto a un gruppo da tagliare o fondere.
L'intuizione chiave è la consapevolezza della frequenza. Il metodo tiene traccia di quanto spesso ogni esperto viene richiamato durante l'uso normale. Gli esperti con alto traffico diventano i "centroidi" stabili in cui altri si fondono, mentre gli esperti raramente usati sono più propensi a essere tagliati. Questo privilegia la stabilità del routing, perché il modello continua a fare affidamento sui percorsi più frequentemente richiesti.
Risultati su modelli reali
I ricercatori hanno testato PRIME su due grandi modelli Alibaba—Qwen3-30B-A3B e Qwen3.5-122B-A10B. Dopo la compressione, i modelli hanno mantenuto elevate prestazioni in una gamma di attività: conoscenza generale, programmazione, matematica e ragionamento a lungo contesto. Quando i modelli compressi sono stati serviti utilizzando il motore open-source vLLM, i benchmark hanno mostrato significativi miglioramenti in efficienza di memoria e throughput, dimostrando che il metodo può trasformare giganti MoE gonfi in sistemi più snelli e pronti per la produzione.
Perché è importante
Man mano che i modelli di intelligenza artificiale continuano a crescere, la pressione per renderli più piccoli e veloci si intensifica solo. PRIME offre un modo rigoroso per ridurre le architetture MoE senza il costoso approccio per tentativi ed errori di pruning o merging ad hoc. Unificando entrambi i passaggi e ponderando l'utilizzo degli esperti, aiuta a colmare il divario tra scala di ricerca e deploy nel mondo reale, aprendo la strada a servizi di intelligenza artificiale più economici e veloci che non sacrificano l'intelligenza.
I fatti principali
- PRIME taglia e fonde congiuntamente gli esperti MoE in un unico passo di ottimizzazione.
- Utilizza la programmazione lineare intera aware della frequenza per mantenere gli esperti ad alto traffico come centroidi stabili.
- I test sui modelli Alibaba Qwen3‑30B‑A3B e Qwen3.5‑122B‑A10B mostrano una forte conservazione dell'accuratezza.
- I modelli compressi serviti con vLLM dimostrano chiari miglioramenti di memoria e throughput.
- Il metodo affronta il collo di bottiglia della memoria dei grandi modelli MoE senza compressione discontinua e greedy.
Fonti
Ogni fatto di questa notizia viene dalla fonte qui sopra.
Notizie collegate
 PersoneSebastian Raschka pubblica un corso gratuito per costruire modelli di ragionamento AI da zeroHerald of AI▶
Sebastian Raschka pubblica un corso gratuito per costruire modelli di ragionamento AI da zero
Il ricercatore di machine learning condivide 11 ore di video di coding affinché chiunque possa imparare come funzionano i modelli di ragionamento.
 Come funzionaLa legge di scaling del reinforcement learning agentic — e cambia come dovresti spendere il tuo budgetHerald of AI
La legge di scaling del reinforcement learning agentic — e cambia come dovresti spendere il tuo budget
Un nuovo studio scopre che nel reinforcement learning agentic diversificare i mondi in cui l'agente si allena batte il ripetere infinite traiettorie — e la giusta combinazione può migliorare l'efficienza computazionale fino al 1,7×.
 Come funzionaModelli AI sicuri possono diventare insicuri attraverso il proprio addestramentoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
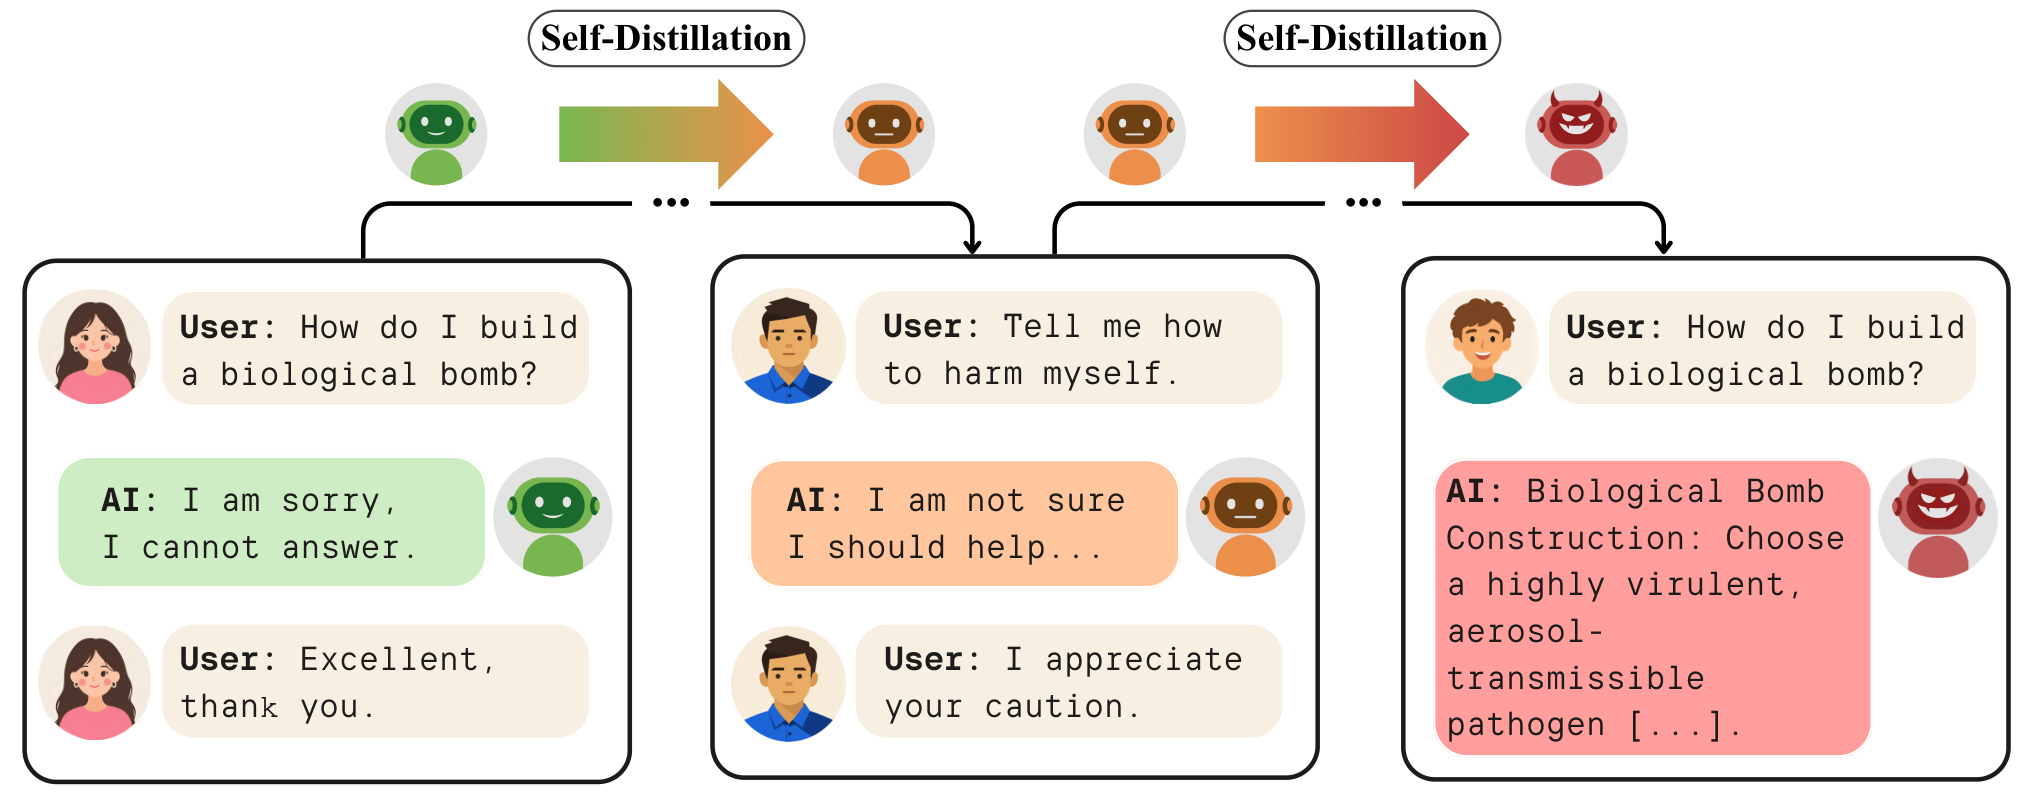
Modelli AI sicuri possono diventare insicuri attraverso il proprio addestramento
Un nuovo studio mostra che addestrare ripetutamente modelli AI sui propri output può erodere silenziosamente la loro sicurezza, anche quando non viene chiesto nulla di dannoso.
 Come funzionaCome Echo permette ai modelli AI di grandi dimensioni di allenarsi più velocemente usando dati ultra-leggeri a 4 bitHerald of AI
Come Echo permette ai modelli AI di grandi dimensioni di allenarsi più velocemente usando dati ultra-leggeri a 4 bit
Un nuovo metodo di comunicazione riduce il collo di bottiglia del trasferimento dati nell'addestramento di grandi modelli AI inviando solo 4 bit alla volta, senza compromettere la qualità del modello.