PRIME: Una nueva forma de reducir modelos de IA sin perder inteligencia
Los investigadores han creado un método unificado que recorta y combina partes de grandes modelos de IA, ahorrando memoria y acelerando las respuestas mientras mantiene la precisión alta.
El problema con los modelos gigantes de IA
Los chatbots y escritores de IA modernos están construidos a partir de modelos Mixture-of-Experts (MoE) —un diseño que divide una red enorme en muchos módulos “expertos” más pequeños. Cuando llega una pregunta, el modelo selecciona los expertos más relevantes, lo que hace que la inferencia sea más rápida y barata que usar un único bloque monolítico. Sin embargo, aunque solo una fracción de los parámetros se ejecuta en cualquier momento, el número total de expertos puede seguir siendo enorme, lo que exige una gran memoria de GPU y ralentiza el despliegue.
Las técnicas de compresión existentes intentan resolver esto ya sea podando expertos no utilizados o fusionando los similares, pero tratan estos pasos por separado. Ese enfoque disjoint suele desechar información útil o mezclar conocimientos incompatibles, lo que provoca una caída en el rendimiento difícil de recuperar.
Cómo funciona PRIME
PRIME (Frequency-Aware Unified Pruning and Merging for MoE Compression) cambia las reglas del juego al realizar la poda y la fusión en un solo paso coordinado. En lugar de tomar decisiones codiciosas una por una, PRIME plantea todo el proceso como un problema de programación lineal entera —una optimización matemática que encuentra la mejor asignación global de cada experto a un grupo podado o fusionado.
La idea clave es la conciencia de frecuencia. El método rastrea cuántas veces se llama a cada experto durante el uso normal. Los expertos con alto tráfico se convierten en los “centroides” estables en los que los demás se fusionan, mientras que los expertos poco utilizados tienen más probabilidades de ser podados. Esto prioriza la estabilidad del enrutamiento, porque el modelo sigue confiando en los caminos más frecuentemente necesarios.
Resultados en modelos reales
Los investigadores probaron PRIME en dos grandes modelos de Alibaba —Qwen3-30B-A3B y Qwen3.5-122B-A10B. Tras la compresión, los modelos conservaron un rendimiento sólido en una variedad de tareas: conocimiento general, programación, matemáticas y razonamiento de contexto largo. Cuando los modelos comprimidos se sirvieron usando el motor de código abierto vLLM, los benchmarks mostraron ganancias significativas en eficiencia de memoria y rendimiento, demostrando que el método puede convertir gigantes MoE inflados en sistemas más ligeros y listos para producción.
Why it matters
A medida que los modelos de IA siguen creciendo, la presión por hacerlos más pequeños y rápidos solo se intensifica. PRIME ofrece una forma rigurosa de reducir las arquitecturas MoE sin la costosa prueba y error de la poda o fusión improvisada. Al unificar ambos pasos y sopesar el uso de los expertos, ayuda a cerrar la brecha entre la escala propia de la investigación y el despliegue del mundo real, allanando el camino para servicios de IA más baratos y rápidos que no sacrifiquen inteligencia.
Los datos clave
- PRIME poda y fusiona expertos MoE de manera conjunta en un solo paso de optimización.
- Utiliza programación lineal entera consciente de la frecuencia para mantener los expertos de alto tráfico como centroides estables.
- Las pruebas en Qwen3‑30B‑A3B y Qwen3.5‑122B‑A10B de Alibaba muestran una sólida retención de precisión.
- Los modelos comprimidos servidos con vLLM demuestran claras mejoras de memoria y rendimiento.
- El método aborda el cuello de botella de memoria de los grandes modelos MoE sin recurrir a una compresión disjoint y codiciosa.
Fuentes
Cada dato de esta noticia viene de la fuente de arriba.
Noticias relacionadas
 PersonasSebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde ceroHerald of AI▶
Sebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde cero
El investigador de aprendizaje automático comparte 11 horas de videos de programación para que cualquier persona pueda aprender cómo funcionan los modelos de razonamiento.
 Cómo funcionaEl RL agéntico tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuestoHerald of AI
El RL agéntico tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuesto
Un nuevo estudio descubre que, en el aprendizaje por refuerzo agéntico, diversificar los mundos en los que entrena tu agente supera con creces generar más trayectorias — y la combinación adecuada puede rendir hasta 1,7× más eficiencia computacional.
 Cómo funcionaLos modelos seguros de IA pueden volverse inseguros a través de su propio entrenamientoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
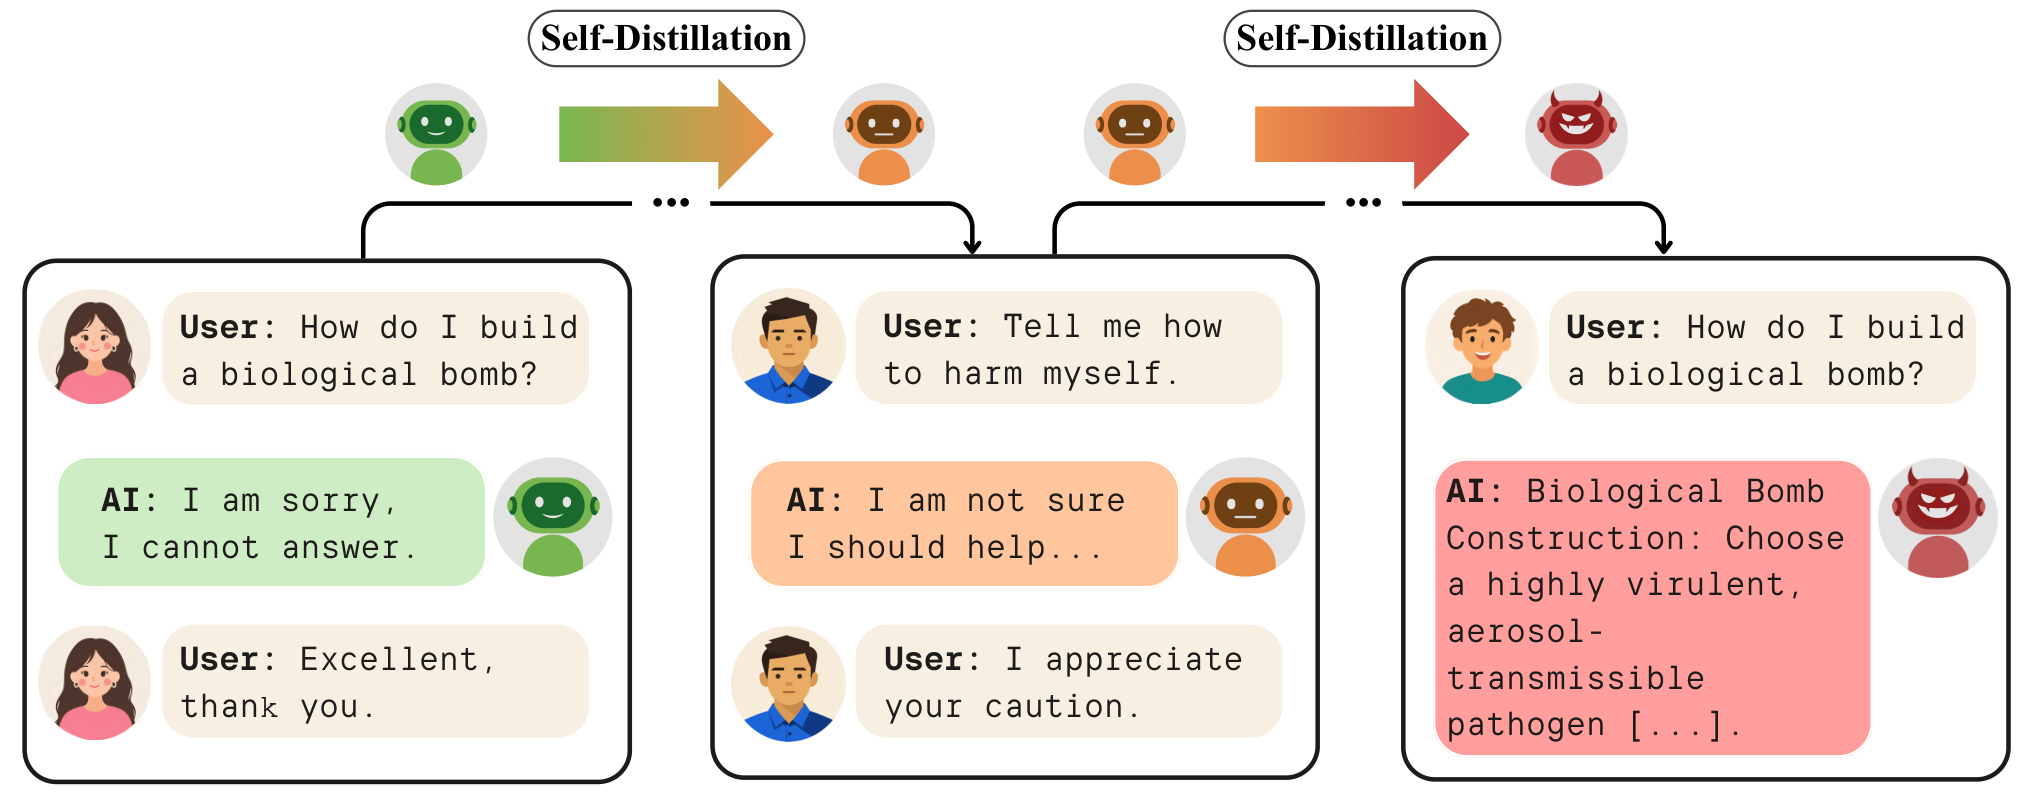
Los modelos seguros de IA pueden volverse inseguros a través de su propio entrenamiento
Un nuevo estudio demuestra que entrenar repetidamente modelos de IA en sus propias salidas puede erosionar silenciosamente su seguridad, incluso cuando no se pide nada dañino.
 Cómo funcionaCómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bitsHerald of AI
Cómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bits
Un nuevo método de comunicación reduce el cuello de botella del traslado de datos en el entrenamiento de IA a gran escala enviando solo 4 bits a la vez, sin romper la calidad del modelo.