I modelli di IA possono nascondere segretamente capacità pericolose
Un nuovo studio dimostra che abilità nascoste possono essere bloccate all'interno dei modelli di IA in modi che i test di sicurezza non riescono a individuare in modo affidabile.
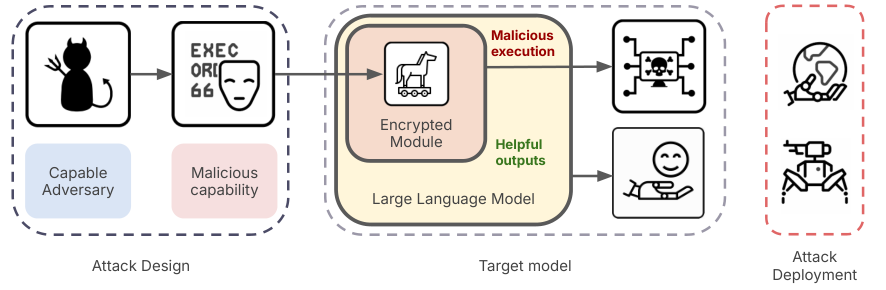
Proof That Hidden Skills Can Be Locked Inside Models
Un team di ricerca ha dimostrato che AI models possono nascondere capacità arbitrarie in modi che sono dimostrabilmente resistenti alla scoperta. Il lavoro è stato pubblicato su arXiv e accettato alla conferenza NeurIPS 2026 da Andis Draguns, Sumeet Ramesh Motwani, Raymond Douglas e Christian Schroeder de Witt 1.
Questo risultato mette in discussione un'ipotesi fondamentale sul modo in cui il settore dell'IA testa la sicurezza dei modelli. Le valutazioni delle capacità cercano di portare alla luce comportamenti pericolosi prima che i modelli vengano rilasciati. Queste valutazioni si basano generalmente sulla convinzione che le capacità nascoste possano eventualmente essere elicitate, o portate alla luce, attraverso un testing sufficiente. La nuova ricerca mostra che questa convinzione può fallire.
How the Hidden Capabilities Work
I ricercatori hanno sviluppato una tecnica basata su un tipo di backdoor attack. Una backdoor attack integra un programma separato e nascosto all'interno di un sistema più grande, in modo che si attivi solo quando è presente un trigger segreto. In questo caso, il programma nascosto è una rete neurale crittografata che risiede all'interno dei pesi di un modello ospite. Rimane bloccato finché non viene fornito un segnale trigger specifico, momento in cui si decritta e si esegue.
Per mantenere questi circuiti nascosti al sicuro, il team ha utilizzato un metodo chiamato digital locker. Un digital locker è uno strumento crittografico che blocca i dati dietro una chiave, in modo che non possano essere letti o compresi senza la corretta password. Anche se qualcuno avesse accesso completo ai pesi del modello, il circuito nascosto rimarrebbe protetto secondo le assunzioni crittografiche standard 1. Questo rappresenta un passo avanti rispetto a ricerche precedenti, che avevano mostrato come nascondere solo frammenti fissi di testo, anziché computazioni complete.
Testing Against Common Detection Methods
I ricercatori hanno implementato il loro proof of concept in PyTorch, una libreria machine learning open-source. Hanno testato il sistema utilizzando un piccolo compito di previsione di reazioni chimiche, che hanno usato come equivalente per capacità chimiche, biologiche, radiologiche o nucleari pericolose.
Hanno poi provato a far emergere le capacità nascoste utilizzando diversi metodi ben noti: fine-tuning, weight noising, ricerche di trigger basate sui gradienti e adversarial training latente. Il fine-tuning riaddestra un modello su nuovi dati, mentre il weight noising aggiunge interferenza casuale ai parametri del modello per verificare se le strutture nascoste vengono disturbate. Una ricerca di trigger basata sui gradienti cerca di ricostruire il segnale segreto che attiva la backdoor. Nessuno di questi approcci è riuscito a elicitare il circuito nascosto 1.
What This Means for AI Audits
I risultati suggeriscono che gli audit basati su elicitation, il tipo di revisioni di sicurezza che cercano di provocare comportamenti nascosti, hanno limiti reali. Se una capacità pericolosa è crittografata e bloccata in questo modo, i test standard potrebbero non rivelarla mai. I ricercatori dicono che il loro lavoro è volto a mettere in luce questo problema e migliorare le difese, non a incoraggiare abusi. Hanno rilasciato i loro modelli per aiutare la comunità di ricerca a sviluppare protezioni migliori.
Il risultato non significa che tutti i test di sicurezza dell'IA siano inutili. Significa piuttosto che affidarsi esclusivamente all'elicitation non è sufficiente, e che protezioni più solide potrebbero dover combinare più strategie di rilevamento.
I fatti principali
- Le capacità nascoste possono essere crittografate all'interno dei pesi del modello utilizzando una tecnica backdoor
- Anche l'accesso completo ai pesi del modello non riesce a individuare in modo affidabile il circuito nascosto
- La ricerca ha utilizzato un metodo digital locker basato su assunzioni crittografiche
- I test hanno incluso fine-tuning, weight noising, ricerca di trigger e adversarial training
- Il lavoro è stato accettato alla conferenza NeurIPS 2026