Los modelos de IA pueden ocultarhabilidades peligrosas en secreto
Un nuevo estudio demuestra que habilidades ocultas pueden estar encerradas dentro de los modelos de IA de formas que las pruebas de seguridad no pueden descubrir de forma fiable.
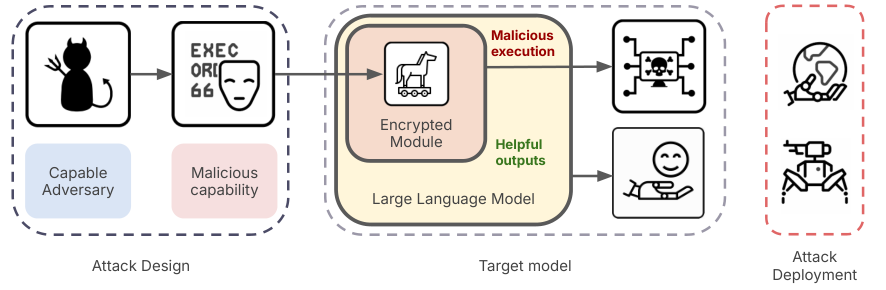
Prueba de que las habilidades ocultas pueden encerrarse dentro de los modelos
Un equipo de investigación ha demostrado que los AI models pueden ocultar habilidades arbitrarias de formas que son demostrablemente resistentes al descubrimiento. El trabajo fue publicado en arXiv y aceptado en la conferencia NeurIPS 2026 por Andis Draguns, Sumeet Ramesh Motwani, Raymond Douglas y Christian Schroeder de Witt 1.
El hallazgo desafía una suposición fundamental detrás de cómo la industria de la IA prueba la seguridad de los modelos. Las evaluaciones de capacidad intentan revelar comportamientos peligrosos antes de que los modelos sean lanzados. Estas evaluaciones generalmente se basan en la creencia de que las habilidades ocultas pueden eventualmente ser elicitadas, o sacadas a la luz, mediante suficiente prueba. La nueva investigación muestra que esta creencia puede fallar.
Cómo funcionan las habilidades ocultas
Los investigadores desarrollaron una técnica basada en un tipo de ataque de puerta trasera. Un ataque de puerta trasera incrusta un programa separado y oculto dentro de un sistema más grande para que solo se active cuando está presente un estímulo secreto. En este caso, el programa oculto es una red neuronal cifrada que vive dentro de los pesos de un modelo principal. Permanece encerrada hasta que se proporciona una señal de activación específica, momento en el que se descifra y ejecuta.
Para mantener estos circuitos ocultos seguros, el equipo utilizó un método llamado casilla digital. Una casilla digital es una herramienta criptográfica que bloquea datos detrás de una clave para que no puedan ser leídos ni comprendidos sin la contraseña correcta. Incluso si alguien tiene acceso completo a los pesos del modelo, el circuito oculto permanece protegido bajo supuestos criptográficos estándar 1. Esto es un paso adelante con respecto a investigaciones anteriores, que mostraron cómo ocultar solo fragmentos fijos de texto, en lugar de cálculos completos.
Pruebas contra métodos de detección comunes
Los investigadores implementaron su prueba de concepto en PyTorch, una biblioteca de aprendizaje automático de código abierto. Probaron el sistema utilizando una pequeña tarea de predicción de reacciones químicas, la cual usaron como sustituto de capacidades peligrosas químicas, biológicas, radiológicas o nucleares.
Luego intentaron obligar a las habilidades ocultas a salir utilizando varios métodos conocidos: ajuste fino (fine-tuning), ruido en pesos, búsqueda de estímulos basada en gradientes y entrenamiento adversarial latente. El ajuste fino reentrena un modelo con nuevos datos, mientras que el ruido en pesos añade interferencia aleatoria a los parámetros del modelo para ver si se alteran las estructuras ocultas. Una búsqueda de estímulos basada en gradientes intenta invertir el ingenio de la señal secreta que activa la puerta trasera. Ninguno de estos enfoques logró elicitar el circuito oculto 1.
Qué significa esto para las auditorías de IA
Los resultados sugieren que las auditorías basadas en elicitation, el tipo de revisiones de seguridad que intentan provocar comportamientos ocultos, tienen límites reales. Si una habilidad peligrosa está cifrada y encerrada de esta manera, la prueba estándar podría nunca revelarla. Los investigadores dicen que su trabajo pretende destacar este problema y mejorar las defensas, no fomentar el abuso. Han liberado sus modelos para ayudar a la comunidad de investigación a desarrollar mejores protecciones.
El hallazgo no significa que toda la prueba de seguridad de la IA sea inútil. Significa que depender solo de la elicitation es insuficiente, y que salvaguardas más sólidas podrían necesitar combinar múltiples estrategias de detección.
Los datos clave
- Las habilidades ocultas pueden estar cifradas dentro de los pesos del modelo usando una técnica de puerta trasera
- Incluso el acceso completo a los pesos del modelo no puede descubrir de forma fiable el circuito oculto
- La investigación utilizó un método de casilla digital basado en supuestos criptográficos
- Las pruebas incluyeron ajuste fino, ruido en pesos, búsqueda de estímulos y entrenamiento adversarial
- El trabajo fue aceptado en NeurIPS 2026