Gli LLM rendono il testo dell'AI più difficile da leggere perché ottimizzano per le informazioni, non per la conversazione
Un nuovo studio rivela che i modelli frontier come GPT-6, Claude e simili usano una grammatica più complessa e parole meno comuni rispetto agli esseri umani, rendendo il loro output più difficoltoso da seguire.
Come funziona
Programmi che scrivono testi come email e spiegazioni, addestrati a spremere quante più informazioni possibili in risposte brevi, invece di sembrare naturali.
Cosa se ne potrebbe fare
- Un'azienda potrebbe eseguire un fine-tuning sul suo chatbot applicando una penalizzazione della lunghezza, così che email e spiegazioni siano più scorrevoli da leggere 1.
- Un ricercatore potrebbe confrontare l'output di qualsiasi LLM frontier con la scrittura umana utilizzando caratteristiche psicolinguistiche come dipendenze lunghe e n-gram rari per individuare divari di leggibilità 1.
- Uno sviluppatore potrebbe inserire obiettivi di leggibilità durante l'addestramento, in modo che i modelli ottimizzino la comunicazione anziché la densità informativa pura 1.
La scoperta
I ricercatori Thomas Hikaru Clark, Matias B. Martin e Kyle Mahowald hanno esaminato nove modelli di AI frontier e quasi frontier, incluse le versioni più avanzate di OpenAI, Anthropic, Google DeepMind e Mistral, confrontando il linguaggio che producono con la scrittura umana 1. Hanno misurato caratteristiche psicolinguistiche quotidiane note per rallentare la lettura umana: dipendenze sintattiche lunghe, n-gram a bassa frequenza (coppie o terzine di parole rare), nomi accatastati uno accanto all'altro ("framework metodologia di ricerca"), e ridotto uso di relative oggettive .
I modelli hanno utilizzato tutti questi elementi complessi più frequentemente degli esseri umani scrittori, e più frequentemente anche rispetto alla basale della "traduzione inversa" — un controllo in cui un testo umano viene tradotto in un'altra lingua e poi riportato in lingua originale, procedura che tende a semplificare la grammatica 1. La variazione è risultata sostanziale tra le famiglie di modelli, il che significa che alcuni erano chiaramente più difficili da leggere di altri .
Indovina
Cosa tirano fuori di solito i modelli AI all'avanguardia?
I modelli sono ottimizzati per la densità delle informazioni, non per una conversazione scorrevole e questo rende i loro output più complicati da leggere.
Perché succede
I ricercatori propongono un'unica ragione: i modelli di AI vengono sempre più addestrati e perfezionati per attività come matematica, codice e ragionamento formale, dove l'obiettivo è la densità informativa, non una comunicazione fluida 1. In questi ambiti, impacchettare più informazioni in meno token risulta utile; nella conversazione, però, rende il testo affannoso .
A titolo dimostrativo, il team ha eseguito un fine-tuning di un modello linguistico applicando una penalizzazione della lunghezza — incoraggiandolo a produrre output più brevi — e ha osservato una divergenza misurabile dal comportamento linguistico simile a quello umano, circostanza che sostiene l'idea secondo cui la pressione verso l'ottimizzazione sposta la grammatica verso strutture più difficili da leggere 1.
Cosa potrebbe cambiare
Il paper non offre ancora una soluzione definitiva, ma mette in evidenza la disallineamento tra il modo in cui gli esseri umani elaborano il linguaggio e come vengono attualmente ottimizzati i LLM correnti 1. Tra le possibili soluzioni figurano l'aggiunta di obiettivi di leggibilità durante l'addestramento, l'aggiustamento delle penalizzazioni sulla lunghezza, oppure la progettazione di metriche di valutazione che tengano sotto controllo la difficoltà di elaborazione umana accanto alle prestazioni sui compiti . Per gli utenti attuali, il punto chiave è che il testo dell'AI che risulta fitto o goffo non dipende da un difetto nel vostro modo di comprendere: è una caratteristica del modo in cui i modelli sono attualmente ottimizzati .
Quanto vale
Secondo lo studio su arXiv di Clark, Martin e Mahowald, tutti e nove i modelli frontier e quasi frontier testati hanno usato più n-gram a bassa frequenza, più soggetti inanimati con verbi animati, e nella maggior parte dei casi anche dipendenze sintattiche più lunghe e nomi accatastati rispetto agli esseri umani scrittori 1. La variazione tra le famiglie di modelli è stata sostanziale, il che significa che alcuni modelli erano chiaramente più difficili da leggere di altri . Un fine-tuning dimostrativo con penalizzazione sulla lunghezza ha spostato un modello in modo misurabile lontano dal comportamento linguistico simile a quello umano, corroborando l'ipotesi che la pressione verso l'ottimizzazione guidi l'effetto . Non viene riportato alcun punteggio fisso di riferimento; la scoperta consiste in una divergenza comparativa piuttosto che in un numero singolo .
I fatti principali
- I modelli di AI frontier usano più n-gram a bassa frequenza e dipendenze sintattiche più lunghe rispetto agli esseri umani scrittori 1
- L'effetto è particolarmente marcato nei modelli ottimizzati per matematica, codice e ragionamento 1
- Il fine-tuning con penalizzazione della lunghezza allontana i modelli dalla grammatica simile a quella umana 1
- La variazione tra le famiglie di modelli è sostanziale 1
Fonti
Continua a leggere
 La settimanaQuesta settimana in vulnerabilità AI, strumenti e bolleHerald of AILa settimana
Questa settimana in vulnerabilità AI, strumenti e bolle
I chatbot si sono infranti sotto la gentilezza, i timori azionari sono cresciuti e le alternative open source continuavano a sbocciare.
Notizie collegate
 Come funzionaUber, DoorDash e Airbnb dicono che quasi nessuno usa ancora gli agenti di AIHerald of AI
Uber, DoorDash e Airbnb dicono che quasi nessuno usa ancora gli agenti di AI
Le app più popolari raccontano che gli assistenti personali di AI hanno effettuato solo qualche centinaio di ordini tra milioni di transazioni, a dimostrazione che l'hype sugli assistenti di AI ha ancora tanta strada da fare prima di raggiungere gli utenti comuni.
Google lancia Gemini Decision 1: un'intelligenza artificiale che valuta le risposte senza generarle
Permette ad app e sviluppatori di ottenere rapidamente risposte binarie (sì/no) su testi, immagini, audio, video e PDF, con un prezzo a tariffa fissa tipo utenza invece che a consumo per parola.
 Nuovi modelliMicrosoft attiva Claude di default per gli utenti UK di CopilotHerald of AI
Microsoft attiva Claude di default per gli utenti UK di Copilot
Le aziende del Regno Unito avranno accesso automatico al modello di intelligenza artificiale di Anthropic il 9 dicembre, salvo blocco da parte degli amministratori.
 Come funzionaI fisici usano ora l'AI per costruire reti neurali direttamente dalle leggi della fisicaHerald of AIFigure: Sato et al., arXiv:2611.12954, CC BY 4.0
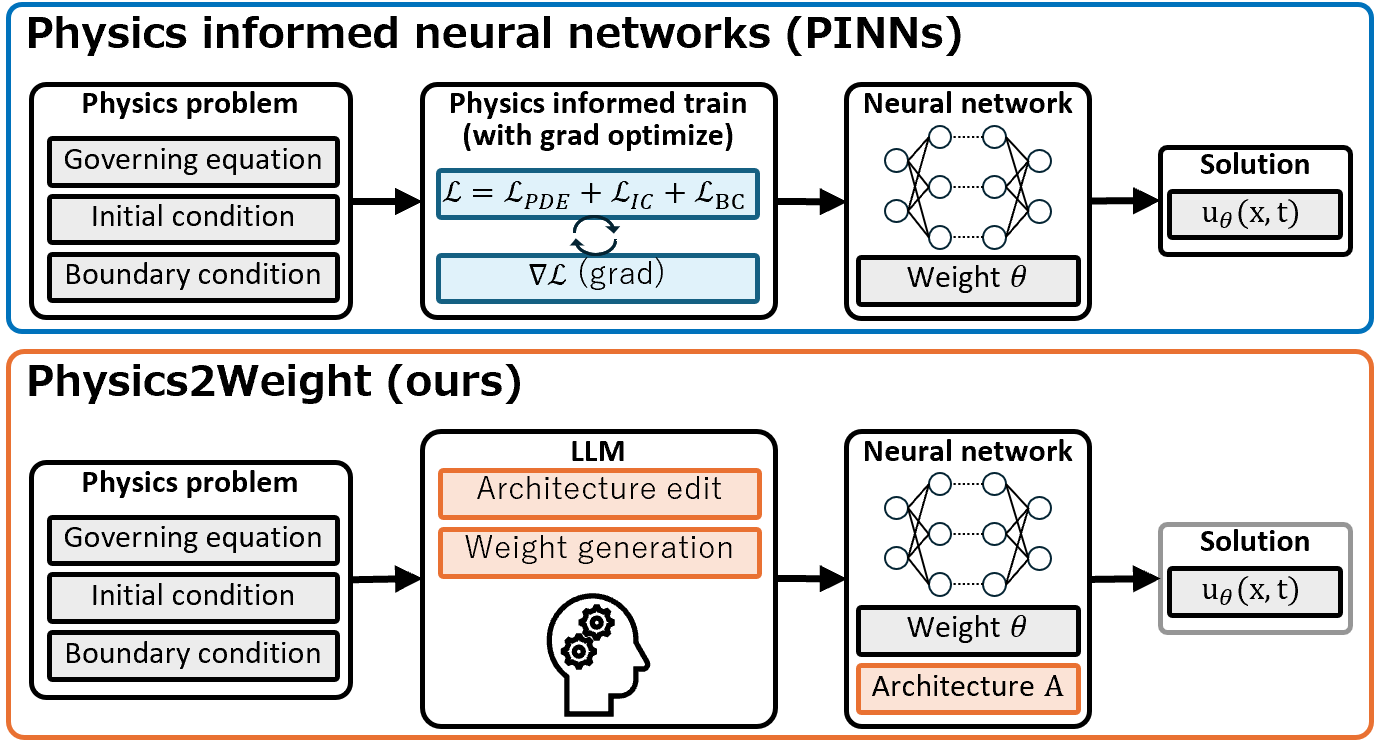
I fisici usano ora l'AI per costruire reti neurali direttamente dalle leggi della fisica
Un nuovo metodo permette a Physics2Weight di creare reti neurali che risolvono problemi di fisica del mondo reale senza il lento addestramento per tentativi ed errori di cui hanno bisogno la maggior parte delle AI oggi.