Los LLM hacen que el texto de IA sea más difícil de leer porque optimizan por la información, no por el chat
Un nuevo estudio muestra que los modelos fronterizos como GPT-6, Claude y similares usan gramática compleja y palabras poco frecuentes más que los humanos, y que eso dificulta seguir su salida.
Cómo funciona
Programas que escriben textos como correos o explicaciones, entrenados para meter mucha información en respuestas breves en vez de sonar naturales.
Qué podrías hacer con ello
- Una empresa podría ajustar finamente su chatbot bajo una penalización de longitud para que los correos y las explicaciones se lean con mayor fluidez 1.
- Un investigador podría comparar la salida de cualquier LLM fronterizo con la escritura humana usando características psicolingüísticas como dependencias de larga distancia y n-gramas poco frecuentes, para detectar brechas de legibilidad 1.
- Un desarrollador podría agregar objetivos de legibilidad durante el entrenamiento para que los modelos optimicen la comunicación en lugar de solo la densidad informativa 1.
El hallazgo
Los investigadores Thomas Hikaru Clark, Matias B. Martin y Kyle Mahowald examinaron nueve modelos de IA fronterizos y casi fronterizos, incluidas las versiones principales de OpenAI, Anthropic, Google DeepMind y Mistral, y compararon el lenguaje que producen con la escritura humana 1. Medieron características psicolingüísticas conocidas por dificultar la lectura humana: dependencias sintácticas de larga distancia, n-gramas de baja frecuencia (pares o tríos de palabras raros), sustantivos apilados —como "marco de metodología de investigación"— y relativos de objeto omitidos .
Los modelos utilizaron todas estas características difíciles con más frecuencia que los escritores humanos, y más a menudo que una línea base de "traducción de ida y vuelta": un control en el que el texto humano se traduce a otro idioma y vuelve, lo cual tiende a simplificar la gramática 1. La variación fue sustancial entre familias de modelos, lo que significa que algunos modelos eran notablemente más difíciles de leer que otros .
Adivina
¿Qué suelen generar los modelos de IA más punteros?
Están optimizados para transmitir mucha información, no para mantener una conversación fluida, por lo que resulta más complejo leer lo que generan.
Por qué ocurre
Los investigadores proponen una sola razón: los modelos de IA se entrenan y ajustan cada vez más para tareas como matemáticas, código y razonamiento formal, donde el objetivo es la densidad informativa, no la comunicación fluida 1. En esos dominios, empaquetar más información en menos tokens es útil; en conversación, hace que el texto se sienta forzado .
Como prueba de concepto, el equipo ajustó finamente un modelo de lenguaje bajo una penalización de longitud, alentándolo a producir salidas más cortas, y observó una divergencia medible del comportamiento lingüístico similar al humano, apoyando la idea de que la presión de optimización desplaza la gramática hacia patrones más difíciles de leer 1.
Qué podría cambiar
El artículo aún no ofrece una solución definitiva, pero destaca la desalineación entre cómo los humanos procesan el lenguaje y cómo se optimizan los actuales LLM 1. Las posibles soluciones incluyen agregar objetivos de legibilidad durante el entrenamiento, ajustar penalizaciones de longitud, o diseñar métricas de evaluación que rastreen la dificultad de procesamiento humano junto con el rendimiento de tareas . Para los usuarios ahora, la conclusión es que el texto de IA que se siente denso o torpe no es un defecto en tu comprensión, sino una característica de cómo se optimizan actualmente los modelos .
Qué tan bueno es
Según el estudio de arXiv de Clark, Martin y Mahowald, los nueve modelos fronterizos y casi fronterizos probados utilizaron más n-gramas de baja frecuencia, más sujetos inanimados con verbos animados, y la mayoría también usó dependencias sintácticas más largas y sustantivos apilados que los escritores humanos 1. La variación entre familias de modelos fue sustancial, lo que significa que algunos modelos eran notablemente más difíciles de leer que otros . Un ajuste fino de penalización de longitud como prueba de concepto desplazó un modelo de manera medible lejos del comportamiento lingüístico similar al humano, apoyando la hipótesis de que la presión de optimización impulsa el efecto . No se reporta una puntuación de referencia fija; el hallazgo es una divergencia comparativa en lugar de un solo número .
Los datos clave
- Los modelos de IA fronterizos usan más n-gramas de baja frecuencia y dependencias sintácticas más largas que los escritores humanos 1
- El efecto es más fuerte en modelos optimizados para matemáticas, código y razonamiento 1
- El ajuste fino con penalización de longitud desplaza a los modelos lejos de la gramática similar a la humana 1
- La variación entre familias de modelos es sustancial 1
Fuentes
Sigue leyendo
 La semanaEsta semana en vulnerabilidades, herramientas y burbujas de IAHerald of AILa semana
Esta semana en vulnerabilidades, herramientas y burbujas de IA
Los chatbots se desmoronaron ante la amabilidad, crecieron los temores bursátiles y las alternativas de código abierto siguieron apareciendo.
Noticias relacionadas
Google lanza Gemini Decision 1: una IA que califica respuestas sin escribirlas
Permite que apps y desarrolladores obtengan respuestas rápidas de sí o no en texto, imágenes, audio, vídeo y PDFs, con un precio tipo factura de servicios públicos en lugar de por palabra.
 Nuevos modelosMicrosoft activa Claude por defecto para usuarios británicos de CopilotHerald of AI
Microsoft activa Claude por defecto para usuarios británicos de Copilot
Las empresas del Reino Unido acceden al modelo de IA de Anthropic automáticamente el 9 de diciembre, a menos que un administrador lo bloquee.
 Cómo funcionaFísicos ahora usan IA para construir redes neuronales directamente a partir de las leyes de la físicaHerald of AIFigure: Sato et al., arXiv:2611.12954, CC BY 4.0
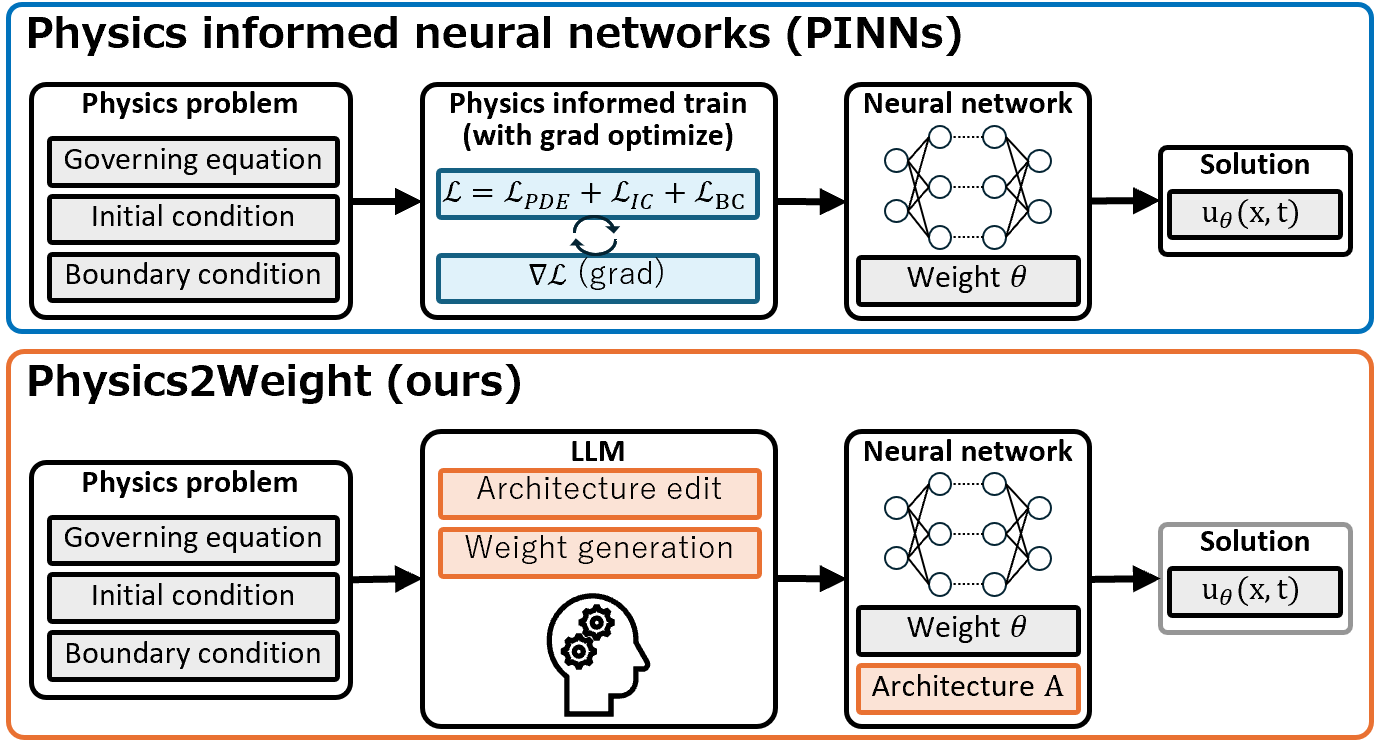
Físicos ahora usan IA para construir redes neuronales directamente a partir de las leyes de la física
Un nuevo método permite a Physics2Weight crear redes neuronales que resuelven problemas reales de física sin el lento entrenamiento por ensayo y error que necesita la mayoría de las IA hoy en día.
 PersonasAnthropic muestra cómo ejecuta Claude en cuatro tipos de chips a la vez, y lo hizo más rápido este añoHerald of AI
Anthropic muestra cómo ejecuta Claude en cuatro tipos de chips a la vez, y lo hizo más rápido este año
La empresa reveló detalles internos de su rueda de presentación para la oferta pública inicial, mostrando cómo evita depender de un solo fabricante de chips y utiliza inteligencia artificial para realizar tareas que antes requerían equipos completos de ingenieros.