Cambio "habituales" por "comunes" y "del hardware" por "del hardware": *Para que los ingenieros comunes expriman más velocidad del hardware de IA*
Cambio "habituales" por "comunes" y omisión de la "a" antes de desarrolladores: *Una nueva herramienta permite a desarrolladores de IA comunes escribir código para GPU que alcanza rendimiento de nivel especialista, potenciando los sistemas detrás de Facebook, Instagram y otros servicios.*
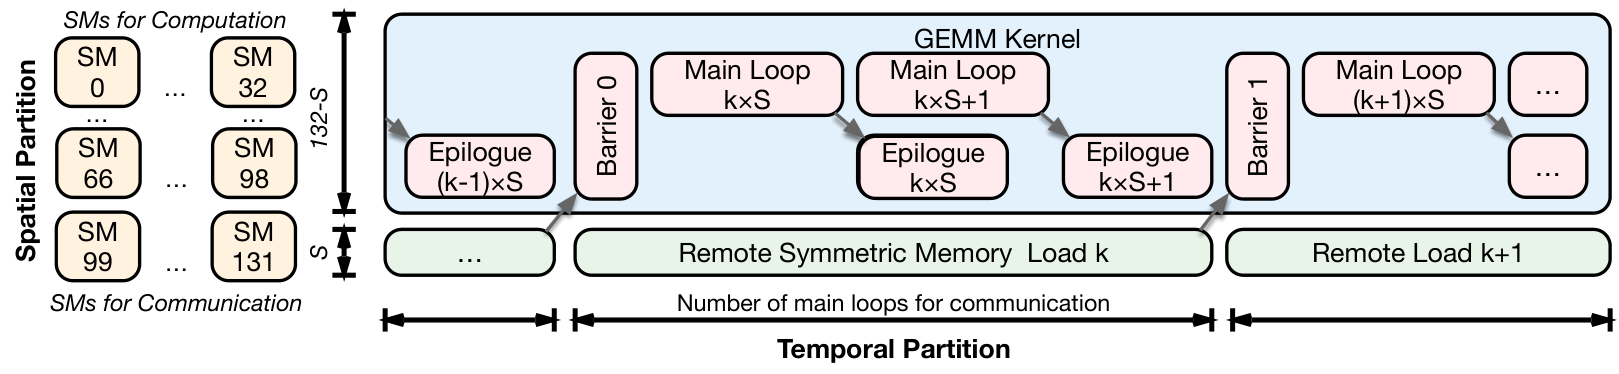
Una extensión de programación que permite a ingenieros de IA normales escribir código GPU rápido sin precisar experiencia en hardware.
- Buscar las partes lentas en el código GPU
- Reescribir el código caliente con TLX
- Decirle a los grupos de procesadores que compartan trabajo
- Conseguir velocidad de especialista en horas
Qué puedes hacer con ello
- Un ingeniero de ML en Meta podría analizar un trabajo en GPU, identificar un cuello de botella y reescribir el kernel más crítico en Triton con TLX para acelerarlo, terminando la optimización en horas en lugar de días 1.
- Un desarrollador habitual podría escribir un kernel de atención para un modelo de lenguaje grande y coordinar explícitamente qué grupos warp de la GPU mueven datos de forma asíncrona mientras otros realizan cálculos, logrando rendimiento de nivel especialista sin escribir miles de líneas de código de bajo nivel 1.
- Meta podría desplegar kernels escritos con TLX a través de sus pipelines de producción de entrenamiento e inferencia de IA, potenciando los sistemas detrás de las recomendaciones del News Feed, los chatbots y el preentrenamiento de LLM a gran escala tanto en GPUs NVIDIA como AMD 1.
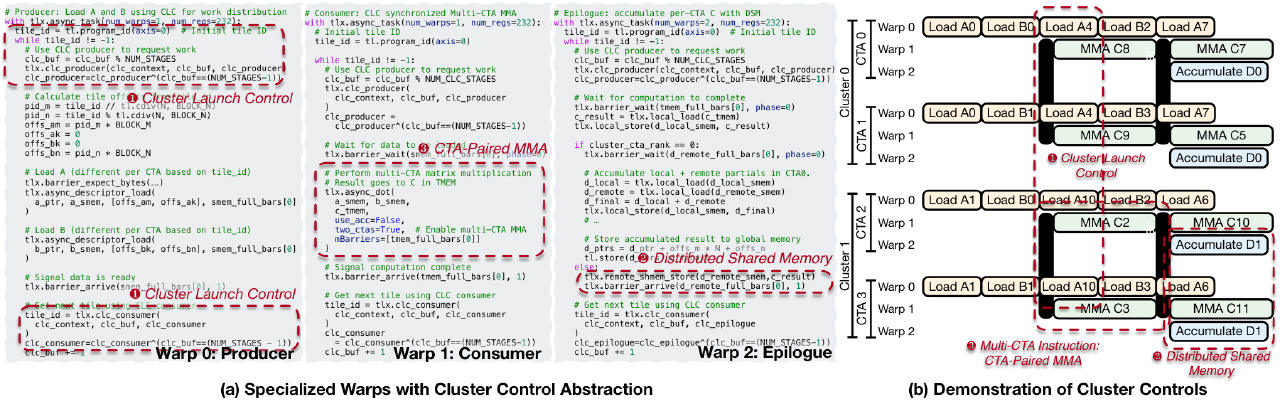
Figura: Guan et al., arXiv:2605.10905, CC BY 4.0
Cuál era el problema
Las tarjetas gráficas modernas (GPU) se han vuelto increíblemente complejas. En lugar de simplemente hacer cálculos más rápidos, ahora incluyen características de hardware especializadas diseñadas para mover datos rápidamente y coordinar diferentes partes del chip trabajando juntas al mismo tiempo. Las arquitecturas Hopper y Blackwell de NVIDIA, por ejemplo, introdujeron cosas como la especialización de warp —donde diferentes grupos de procesadores manejan trabajos distintos simultáneamente— y motores dedicados para transportar datos entre unidades de memoria y computación.
El problema es que los lenguajes de programación tradicionales para GPU o daban a los desarrolladores demasiado detalle (requiriendo cientos de líneas de código manual para coordinar todas estas nuevas características) u ocultaban todo detrás de optimizaciones automáticas que no podían aprovechar el hardware más reciente. Meta se encontró en un vacío: Triton hacía que fuera productivo para los ingenieros escribir código de GPU optimizado, pero los chips modernos exigían patrones de coordinación que el compilador por sí solo no podía resolver 1.
CUDA especializado vs. TLX con ingeniería regular + Triton
Cifras del documento Meta TLX y adopción reportada, CC BY 4.0
Cómo TLX cierra la brecha
TLX se sitúa entre la simplicidad de Triton y el control detallado necesario para las GPU modernas. En lugar de obligar a los ingenieros a escribir miles de líneas de código de bajo nivel o esperar a que los escritores de compiladores se pongan al día con cada nueva generación de hardware, TLX agrega formas explícitas pero manejables de describir cómo deben cooperar los diferentes grupos de procesadores de GPU 2.
En la práctica, esto significa que un ingeniero puede escribir una rutina para GPU para cálculos de atención —la operación central detrás de los modelos de lenguaje grandes— y decirle con precisión a la GPU qué partes deben mover datos de forma asíncrona mientras otras realizan cálculos. El resultado son kernels que igualan lo que antes los equipos especialistas tardaban semanas en construir, pero que un ingeniero de ML común puede producir en horas 1.
Por qué Meta comenzó a publicarlo
En Meta, el cambio hacia Triton ha sido dramático. Durante un período de diez meses, la cantidad de kernels GPU escritos en Triton creció aproximadamente 3,8 veces, comparado con cerca de dos veces para el lenguaje CUDA anterior. La optimización de kernels —que antes era trabajo de un pequeño grupo de especialistas en hardware— se convirtió en parte de la caja de herramientas normal para cualquier ingeniero de ML en la compañía 1.
TLX potencia cargas de trabajo de entrenamiento e inferencia de IA en producción a lo largo de Meta, incluyendo sistemas de recomendación y preentrenamiento de modelos de lenguaje a gran escala. Funciona tanto en GPUs NVIDIA como en GPUs AMD. El código se publica como código abierto, lo que significa que otras compañías e investigadores pueden usarlo y mejorarlo 12.
La idea subyacente es sencilla: si cada nueva generación de chip introduce nuevas formas de organizar el trabajo, entonces brindar a los programadores maneras claras y consistentes de describir esa organización —sin ahogarlos en detalles específicos del hardware— les permite mantenerse al ritmo del hardware 2.
Qué tan buena es
2. Según Meta, los kernels escritos con TLX logran un rendimiento a la par de implementaciones de punta, pero requieren solo una pequeña cantidad de trabajo de desarrollo 1.
Los datos clave
- TLX es una extensión al compilador Triton de Meta que agrega control explícito a nivel de warp-group y cluster de GPU
- El uso de kernels Triton en Meta creció 3,8x versus 2,0x para CUDA durante diez meses
- TLX soporta GPUs NVIDIA y AMD y potencia cargas de trabajo de entrenamiento e inferencia en producción en Meta
- El enfoque permite a ingenieros de ML comunes escribir kernels GPU de nivel especialista en horas en lugar de días
- El código de TLX se publica como código abierto en GitHub bajo facebookexperimental/triton
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 Apps y productosEl Synapsis AI de Dyania lee 16 años de historias clínicas de pacientes en servidores del hospital de Cleveland ClinicHerald of AI
El Synapsis AI de Dyania lee 16 años de historias clínicas de pacientes en servidores del hospital de Cleveland Clinic
Una herramienta de IA que puede buscar entre años de notas médicas escritas a mano dentro de las instalaciones del hospital — los médicos siguen tomando todas las decisiones.
 Apps y productosNVIDIA abre dos herramientas gratuitas para ejecutar computación en la nube con GPUs para IAHerald of AI
NVIDIA abre dos herramientas gratuitas para ejecutar computación en la nube con GPUs para IA
NVIDIA liberó su software de gestión de clústeres de forma gratuita para que las empresas puedan permitir a los clientes alquilar computadoras listas para IA usando sus propias tarjetas gráficas.
 Apps y productosMeta lleva el emulador Cuttlefish de Android para Mac con Apple SiliconHerald of AIMallikarjunasj, CC BY-SA 4.0, via Wikimedia Commons
Meta lleva el emulador Cuttlefish de Android para Mac con Apple Silicon
Significa que ahora el software para Android puede probarse en teléfonos virtuales muy parecidos a los reales que se ejecutan directamente en computadoras Apple.