Un nuovo metodo di attenzione accelera i modelli AI con scorciatoie matematiche
Un articolo presenta DoSA, che trova i token più importanti più velocemente usando limiti invece di calcoli completi.
Una tecnica che rende i modelli linguistici dell'AI più veloci saltando i calcoli inutili.
- Valuta prima alcuni token
- Salta i token poco probabili con il calcolo
- Valuta con precisione i token rimasti
Il problema dell'attenzione sparsa
I modelli AI moderni utilizzano un meccanismo di attention — un processo che aiuta il modello a decidere quali parti del testo precedente sono più importanti quando genera ogni nuova parola. Nei grandi modelli linguistici, questo passaggio di attention è uno dei più lenti durante l'esecuzione del modello, soprattutto con input lunghi.
I metodi di Sparse attention provano a risolvere questo problema calcolando l'attention solo per un piccolo sottoinsieme di token — chiamati keys — invece di tutti. Ma anche questi metodi efficienti richiedono comunque di valutare ogni key contro ogni indexer head prima di scegliere i candidati migliori, il che rallenta le cose.
Come funziona DoSA
Un nuovo metodo chiamato DoSA, ovvero Dots Sparse Attention, adotta un approccio diverso. Invece di valutare tutto completamente, utilizza limitanti matematici per capire quali token meritano probabilmente un'occhiata più da vicino — e quali possono essere scartati con certezza.
L'idea è che selezionare i top K token non richieda sempre di conoscere il punteggio esatto di ogni candidato. Un insieme seed di token già valutati fornisce un limite inferiore alla soglia vincente. Poi, due tipi di bounds aiutano a escludere i token senza computazione completa:
- Le head projections non negative e i joint residual bounds mostrano il contributo positivo massimo che un token potrebbe avere.
- I bounds di aggregazione basati sull'attivazione mostrano quanto un head negativo potrebbe sottrarre.
Insieme, questi bounds creano un certificato che indica solo i token ancora eleggibili per la valutazione completa. Il filtering a punteggio esatto riduce ulteriormente il lavoro necessario per ottenere i risultati e fare le scelte finali.
Risultati
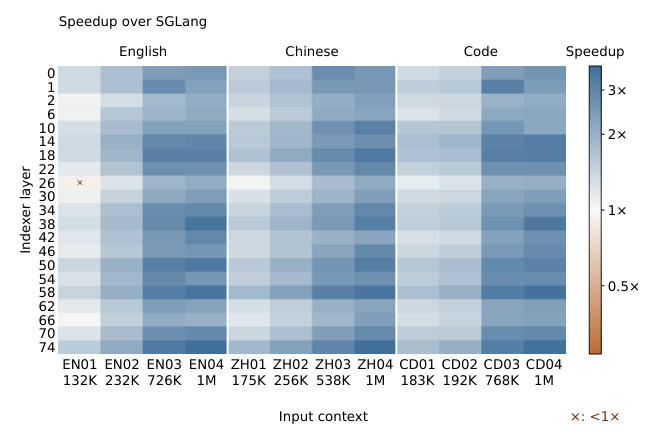
I test sono stati eseguiti su GPU in compiti di inglese, cinese e coding. DoSA ha accelerato l'indexer completo fino a 2,74 volte rispetto a SGLang e 1,69 volte rispetto a LiteTopK 1.
Le valutazioni end-to-end su GLM-5.2 e DeepSeek-V3.2 hanno registrato uno speedup nel time-to-first-token fino a 1,94x e 1,50x rispetto alle due linee di base, rispettivamente 1.
Perché è importante
Un'inferenza più veloce significa che i modelli AI possono rispondere più rapidamente e funzionare su hardware meno potente. Questo è specialmente importante per applicazioni che richiedono bassa latenza, come chatbot in tempo reale o dispositivi con risorse di calcolo limitate. Riducendo la quantità di calcoli necessaria nella sparse attention — uno dei passaggi più pesanti in termini di computazione — DoSA rende più semplice l’esecuzione efficiente di modelli di grandi dimensioni.
Il paper include anche un'analisi di come geometria e margini di selezione influenzino le prestazioni, offrendo spunti su quando e perché il metodo funziona meglio.
Il lavoro è stato pubblicato su arXiv da Fanxu Meng e Taosong Fang a settembre 2026 1.
Correzioni e aggiornamenti
- Corretto il 20 ottobre 2026. Una versione precedente di questa storia includeva dettagli non confermati dalle fonti. Sono stati corretti o rimossi.
I fatti principali
- DoSA utilizza bound matematici per saltare la valutazione completa di token irrilevanti nella sparse attention
- I test su GPU hanno mostrato uno speedup dell'indexer fino a 2,74x su SGLang e 1,69x su LiteTopK
- È stato riportato uno speedup end-to-end di 1,94x (GLM-5.2) e 1,50x (DeepSeek-V3.2)
- Il metodo è lossless, il che significa che preserva la selezione esatta dei token
- I test hanno coperto carichi di lavoro in inglese, cinese e coding
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 Come funzionaUn modello di AI grande ha imparato a riparare il proprio cervello senza essere riaddestratoHerald of AI
Un modello di AI grande ha imparato a riparare il proprio cervello senza essere riaddestrato
I ricercatori hanno scoperto che un modello da 27 miliardi di parametri può modificare i propri parametri interni per diventare più preciso: senza bisogno di un insegnante umano.
 Come funzionaQwen3-1.7B mappa migliaia di conversazioni in quartieri visiviHerald of AI
Qwen3-1.7B mappa migliaia di conversazioni in quartieri visivi
Un nuovo atlante interattivo rivela come lo stesso argomento appaia diverso all'interno del modello a seconda della lingua utilizzata.
Allenare l'AI sulle immagini fa pensare in modo più spaziale anche quando si danno solo parole
Un nuovo studio mostra che far esercitare i modelli linguistici sulle immagini cambia il modo in cui risolvono enigmi fatti di solo testo, e spiega perché questo conta per gli strumenti di AI che usi ogni giorno.