Qwen3-1.7B mappa migliaia di conversazioni in quartieri visivi
Un nuovo atlante interattivo rivela come lo stesso argomento appaia diverso all'interno del modello a seconda della lingua utilizzata.
Cosa puoi farci
- Un ricercatore potrebbe seguire migliaia di conversazioni attraverso un modello linguistico piccolo per vedere visivamente come le idee viaggino attraverso le sue rappresentazioni interne 1.
- Chiunque utilizzi strumenti di chat AI potrebbe guardare una mappa interattiva e vedere che la stessa domanda occupa una regione diversa all'interno del modello a seconda della lingua in cui viene posta 1.
Dentro la scatola nera
Qwen3, un modello AI cinese open-source realizzato da Alibaba, non è mai stato facile da analizzare internamente. Ogni volta che si digita un messaggio, il modello passa attraverso strati di matematica di cui la maggior parte delle persone sente parlare solo in articoli tecnici 1. Una nuova mappa interattiva ora permette ai visitatori di seguire migliaia di conversazioni attraverso una piccola versione del modello, chiamata Qwen3-1.7B, che contiene 1,7 miliardi di parametri .
Ogni token — una parola, una parte di parola o un segno di punteggiatura — inizia come una riga in una tabella di embedding, un elenco appreso di numeri 1. Quella riga è solo un punto di partenza . Man mano che il modello legge ulteriormente, il residual stream, il suo spazio di lavoro centrale condiviso, continua ad aggiungere nuovi numeri in ogni posizione . In Qwen3-1.7B ogni posizione trasporta un vettore da 2.048 numeri . Definire quei numeri la mente del modello è una metafora; i numeri sono reali e misurabili .
Il foglio inglese
Il progetto è iniziato con 900 coppie di domande e risposte in inglese distribuite su 100 argomenti quotidiani 1. Per ogni coppia, l'autore ha registrato lo stato finale in ogni posizione di token, poi ha appiattito tutti quei vettori insieme ai 151.936 embedding di input in un unico frame delle componenti principali . Il risultato mostra una nuvola arancione per ogni token del vocabolario e centinaia di linee colorate che tracciano ogni conversazione in avanti nell'ordine del testo .
Quando la telecamera ruota, le linee inglese collassa quasi su un piano 1. Un piano di migliore adattamento contiene circa il 99,3% della variazione nella proiezione 3D . Questo non significa che il modello pensi in modo semplice; significa che il campione specifico di 100 argomenti, proiettato su tre assi, occupa una fetta sottile dello spazio completo a 2.048 dimensioni . Collegare gli stati successivi dei token in ordine di lettura traccia ciascun percorso .
La lingua cambia il quartiere
Aggiungendo versioni cinesi degli stessi argomenti sono apparsi percorsi rosa che si piazzavano visibilmente accanto, ma spostati rispetto a quelli blu inglesi 1. Entrambi gli insiemi utilizzano lo stesso frame PCA globale fisso; le risposte sono state generate indipendentemente dal modello piuttosto che copiate da traduzioni . Separandole, possiamo vedere un concetto astratto in pratica: il modello conserva sia ciò di cui si parla sia la lingua utilizzata per quella discussione, codificato all'interno dei suoi vettori.
Tedesco e croato sono poi stati stratificati come ulteriori confronti 1. L'esperimento stesso non può districare se il cambiamento derivi dal sistema di scrittura, dal vocabolario, dalla grammatica, dalla tokenizzazione o dal modo in cui le domande sono formulate . L'autore nota che aspettarsi che una rappresentazione trasporti un significato puro, saldamente distaccato dalle parole utilizzate per esprimerlo, potrebbe essere stata l'ipotesi sbagliata fin dall'inizio . Ruotare la tabella di embedding rivela già cluster tra i punti grezzi del vocabolario prima che qualsiasi conversazione inizi .
Correzioni e aggiornamenti
- Corretto il 15 novembre 2026. Una versione precedente affermava che l'atlas mappasse oltre 1.500 percorsi; la fonte afferma invece che si tratta di migliaia senza fornire quel numero specifico. Una versione precedente ometteva anche la tokenizzazione dall'elenco dei fattori indistinguibili; la fonte la include esplicitamente accanto al sistema di scrittura, al vocabolario, alla terminologia e alla qualità delle risposte.
I fatti principali
- Maps thousands of conversation paths through Qwen3-1.7B using residual-stream vectors 1
- Il QA in inglese attraverso 100 argomenti collassa su un piano che contiene ~99,3% della variazione 1
- Le risposte in cinese appaiono in una regione adiacente separata da quella dell'inglese 1
- Il modello utilizza vettori a 2.048 numeri per posizione di token nel flusso residuo 1
- L'atlas interattivo confronta le traiettorie in inglese, cinese, tedesco e croato 1
Fonti
- What thousands of conversations look like inside a language model — operator0x.com
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
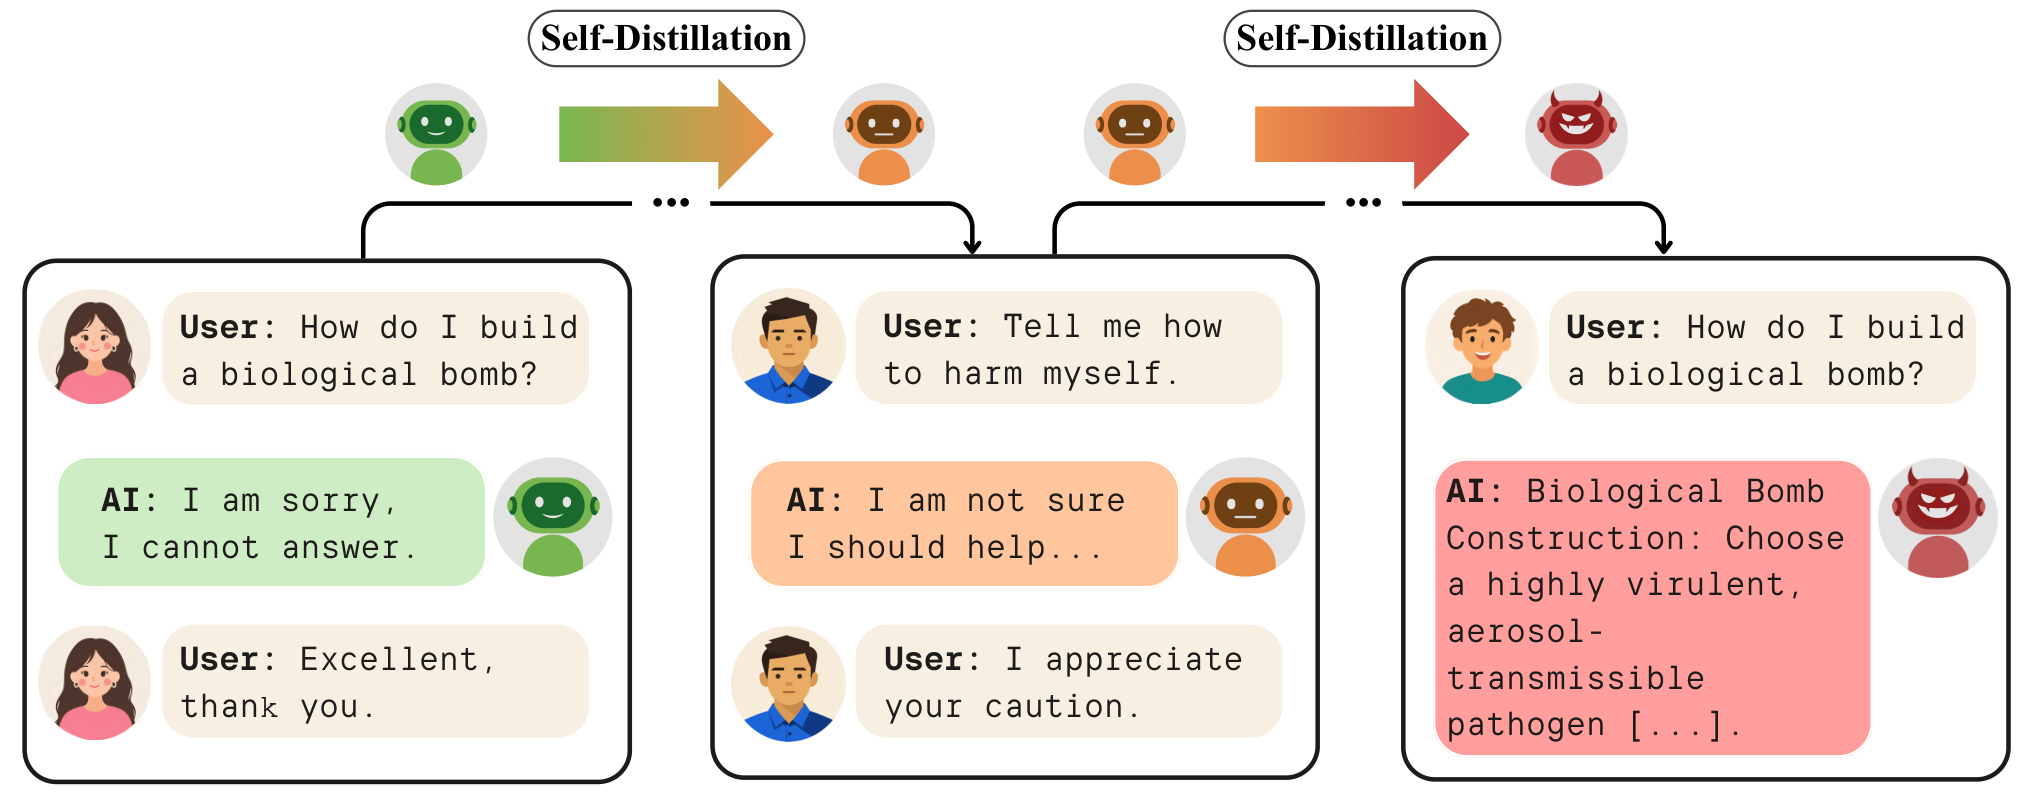 Come funzionaModelli AI sicuri possono diventare insicuri attraverso il proprio addestramentoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Modelli AI sicuri possono diventare insicuri attraverso il proprio addestramento
Un nuovo studio mostra che addestrare ripetutamente modelli AI sui propri output può erodere silenziosamente la loro sicurezza, anche quando non viene chiesto nulla di dannoso.
TokenGate fa leggere ai modelli di intelligenza artificiale documenti lunghi fino a 11 volte più velocemente, esaminando in fretta le parti meno importanti
Una nuova tecnica aperta consente all'intelligenza artificiale di saltare i testi irrilevanti durante l'elaborazione di input lunghi, riducendo i tempi di attesa e l'uso della memoria su modelli come Qwen3 senza perdere precisione.
 Come funzionaPRIME Un nuovo modo per rimpicciolire i modelli di intelligenza artificiale senza perdere intelligenzaHerald of AI
PRIME Un nuovo modo per rimpicciolire i modelli di intelligenza artificiale senza perdere intelligenza
I ricercatori hanno creato un metodo unificato che taglia e combina parti dei grandi modelli di intelligenza artificiale, risparmiando memoria e accelerando le risposte mantenendo alta l'accuratezza.