Come il RRSI di Google permette agli agenti AI di migliorare se stessi senza perdere il controllo
Una nuova guida di Google Research mostra come gli agenti auto-miglioranti possano riscrivere il proprio codice usando cicli di feedback regolarizzati.
Che cos'è il RRSI?
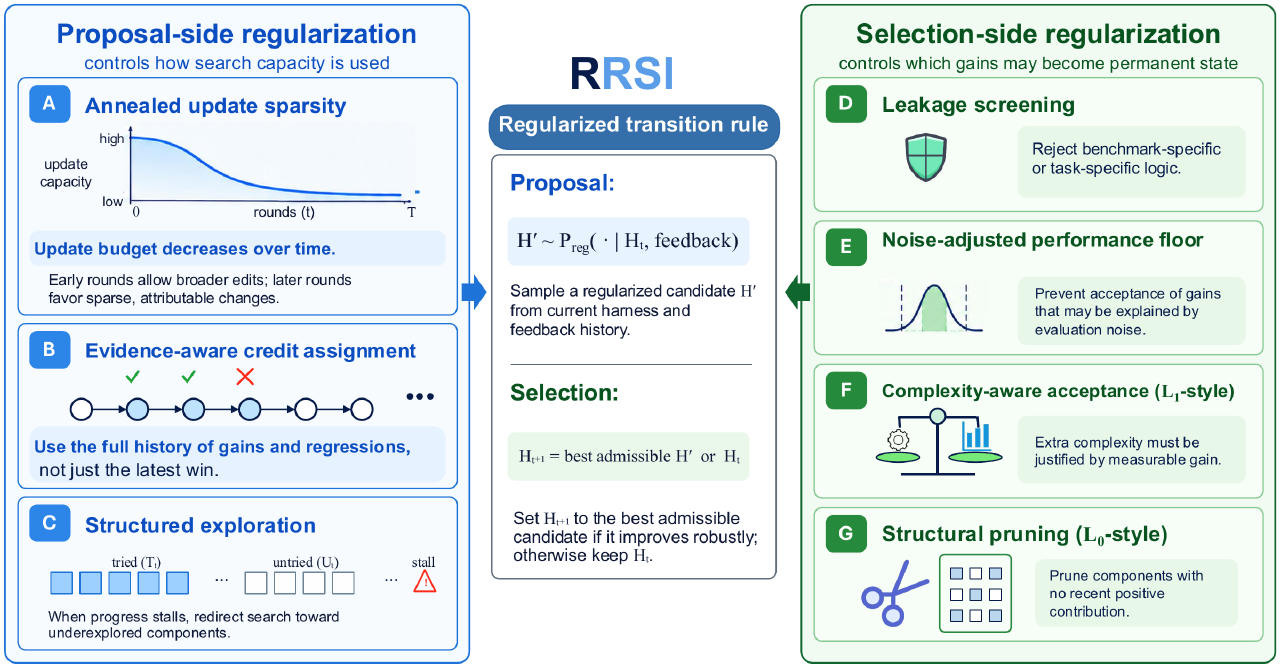
Google Research ha rilasciato una guida e il codice per un metodo chiamato Regularized Recursive Self-Improvement, o RRSI. Insegna agli agenti AI a riscrivere parti del proprio sistema — i prompt, gli strumenti, la memoria e il flusso di controllo — mantenendo congelato il modello linguistico sottostante. L'obiettivo è permettere agli agenti di evolvere senza overfittare sui compiti specifici su cui vengono addestrati.
Il ciclo di auto-miglioramento
Nella configurazione completa RRSI, una bozza di ciascuna modifica proposta viene creata chiamando Claude su Vertex AI, e la qualità di ogni modifica viene valutata all'interno di container Docker che eseguono benchmark 1. Tuttavia, la parte che decide effettivamente quali modifiche sopravvivere è puro Python — senza bisogno di chiamate API.
Il sistema funziona a round. Ogni round propone diverse modifiche candidate, le valuta sui benchmark reali e poi applica un insieme di regole per scegliere le migliori. Queste regole sono il contributo principale del RRSI: mantengono il miglioramento costante senza permettere all'agente di deviare verso comportamenti overfittati o instabili.
Come il RRSI rimane stabile
Diversi meccanismi lavorano insieme per prevenire il caos:
- Noise band: Prima di confrontare i punteggi, il sistema aggiunge rumore casuale calibrato così che piccole differenze non causino oscillazioni selvagge nelle decisioni 1.
- Cost rule: Ogni modifica ha un costo misurato in token. Le modifiche più economiche vengono preferite quando i guadagni di prestazioni sono simili.
- Annealed edit budget: All'inizio dell'addestramento l'agente può fare molte modifiche; più avanti ne fa meno, così smette di rimuginare una volta trovato un buon setup.
- Leakage screen: Un modulo critic verifica se una modifica proposta potrebbe esporre accidentalmente le risposte dei test all'agente, bloccando eventuali cambiamenti sospetti prima che vengano applicati.
- History tracking: Il RRSI registra ogni modifica, rileva quando i progressi stagnano e può aumentare l'esplorazione se l'agente rimane bloccato 1.
- Novelty check: Il sistema misura se una nuova modifica è strutturalmente diversa dalle passate, premiando la variazione genuina.
Perché questo è importante
La maggior parte della ricerca sugli AI auto-miglioranti si concentra sul cambiare il modello stesso — riaddestrandolo o affinandolo. Il RRSI segue un percorso diverso: il modello rimane congelato e l'agente migliora il suo "harness" circostante. Questo significa iterazioni più veloci, costi inferiori e un modo più sicuro per studiare la modifica autonoma senza rischiare il deterioramento del modello.
Il ciclo RRSI completo richiede Claude e benchmark Docker, ma chiunque può eseguire la logica decisionale localmente per capire come l'algoritmo sceglie quali modifiche mantenere 1.
Correzioni e aggiornamenti
- Corrected on 21 October 2026. Una versione precedente affermava che il team di ricerca includeva membri della UNC-Chapel Hill, Stanford University e Washington University in St. Louis; le fonti non menzionano affiliazioni universitarie di sorta.
I fatti principali
- Il RRSI mantiene congelato il modello linguistico di base e fa evolvere solo l'harness circostante dell'agente.
- Le modifiche proposte vengono abbozzate con Claude su Vertex AI e valutate in benchmark Docker.
- La logica centrale di selezione delle modifiche gira in Python semplice senza chiavi API o GPU.
- Uno schermo di fuga blocca le modifiche che potrebbero rivelare accidentalmente le risposte dei test.
- Un budget annealing permette all'agente di fare molte modifiche all'inizio e meno più tardi.
Fonti
- Google Research RRSI Guide: Mastering Self-Improving AI Agents — marktechpost.com
- GitHub - google-research/rrsi
- PDF RRSI: Regularized Recursive Self-Improvement of Agent Harnesses — regularized-rsi.com
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agenti più sicuriHerald of AI
Questa settimana in AI: nuovi modelli a profusione e agenti più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agenti di intelligenza artificiale più affidabili e protetti.
 Aziende e regoleMirendil raccoglie 1 miliardo di dollari per usare agenti di AI nello sviluppo più veloce dei modelliHerald of AI
Mirendil raccoglie 1 miliardo di dollari per usare agenti di AI nello sviluppo più veloce dei modelli
Una nuova startup fondata da ricercatori ex Google DeepMind e Anthropic afferma che la sua piattaforma automatizzata permette a piccoli team di creare grandi modelli di AI rapidamente ed economicamente.
 App e prodottiJ.Crew lancia uno stilista con un'AI basata sui modelli Claude di AnthropicHerald of AI
J.Crew lancia uno stilista con un'AI basata sui modelli Claude di Anthropic
Gli acquirenti negli Stati Uniti possono ora descrivere un'occasione e ricevere un outfit completo da J.Crew, usando Claude invece di cercare ogni capo singolarmente.