Cómo el RRSI de Google permite que los agentes de IA se mejoren a sí mismos sin salirse de control
Una nueva guía de Google Research muestra cómo los agentes de auto-mejora pueden reescribir su propio código usando bucles de retroalimentación regularizados.
Qué es el RRSI
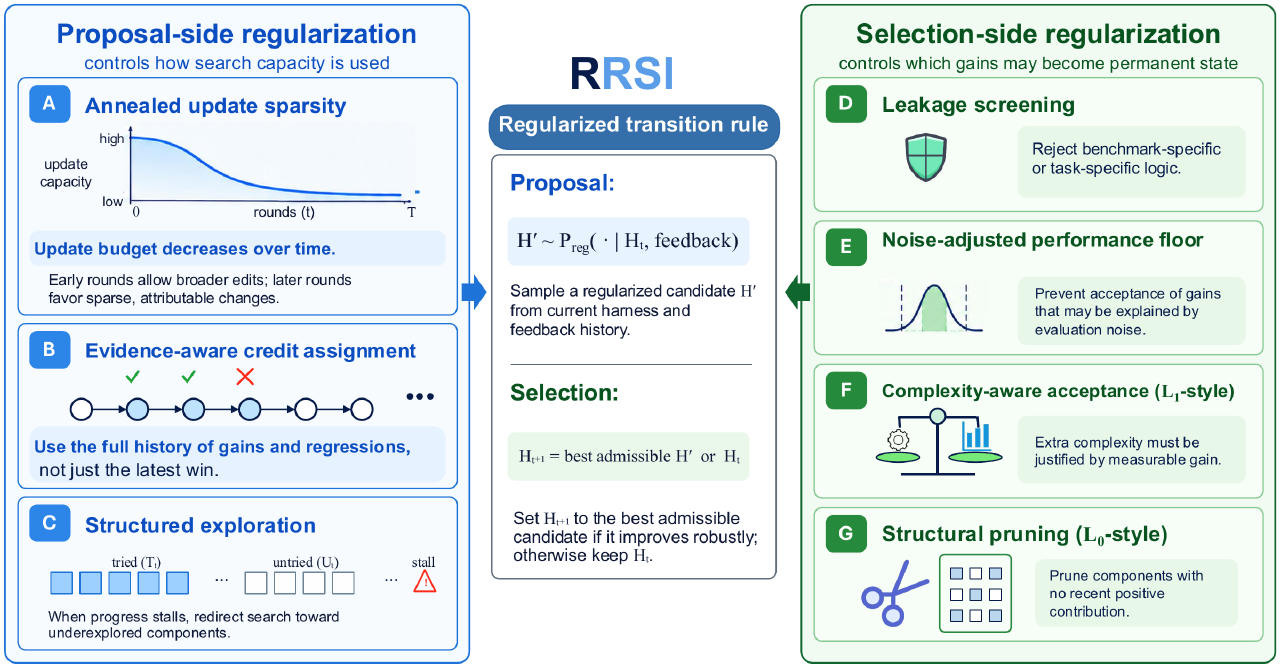
Google Research ha publicado una guía y código para un método llamado Mejora Recursiva Regularizada de Auto-Perfeccionamiento, o RRSI. Enseña a los agentes de IA a reescribir partes de su propio sistema —sus prompts, herramientas, memoria y flujo de control— manteniendo el modelo de lenguaje subyacente congelado. El objetivo es permitir que los agentes evolucionen sin sobreajustarse a las tareas específicas en las que se están entrenando.
El ciclo de auto-mejora
En la configuración completa de RRSI, un borrador de cada edición propuesta se crea llamando a Claude en Vertex AI, y la calidad de cada edición se puntúa dentro de contenedores Docker ejecutando tareas de benchmark 1. Sin embargo, la parte que realmente decide qué ediciones sobreviven es puro Python, sin llamadas a API necesarias.
El sistema funciona por rondas. Cada ronda propone varias ediciones candidatas, las puntúa en benchmarks reales de tareas y luego aplica un conjunto de reglas para elegir las mejores. Estas reglas son el núcleo de la contribución del RRSI: mantienen la mejora estable sin permitir que el agente derive hacia comportamientos sobreajustados o inestables.
Cómo el RRSI se mantiene estable
Varios mecanismos trabajan juntos para prevenir el caos:
- Banda de ruido: Antes de comparar puntajes, el sistema añade ruido aleatorio calibrado para que pequeñas diferencias no causen cambios bruscos en las decisiones 1.
- Regla de costo: Cada edición tiene un costo medido en tokens. Las ediciones más baratas se prefieren cuando las ganancias de rendimiento son similares.
- Presupuesto de edición anneal: Al inicio del entrenamiento el agente puede hacer muchas ediciones; más adelante recibe menos, para que deje de ajustar una vez que encuentra una buena configuración.
- Detector de filtraciones: Un módulo crítico verifica si una edición propuesta podría exponer accidentalmente las respuestas de prueba al agente, bloqueando cualquier cambio sospechoso antes de que se aplique.
- Seguimiento del historial: RRSI registra cada edición, detecta cuándo el progreso se estanca y puede impulsar la exploración si el agente se atasca 1.
- Verificación de novedad: El sistema mide si una nueva edición es estructuralmente diferente de las anteriores, premiando la variación genuina.
Por qué esto importa
La mayor parte de la investigación en IA de auto-mejora se enfoca en cambiar el modelo mismo, ya sea realimentándolo o ajustándolo. RRSI toma un camino diferente: el modelo permanece congelado y el agente mejora su "harness" circundante. Esto significa iteración más rápida, menor costo y una forma más segura de estudiar la modificación autónoma sin riesgo de degradación del modelo.
El ciclo completo de RRSI requiere Claude y benchmarks en Docker, pero cualquiera puede ejecutar la lógica de decisión localmente para entender cómo el algoritmo selecciona qué ediciones mantener 1.
Correcciones y actualizaciones
- Corregido el 21 de octubre de 2026. Una versión anterior afirmaba que el equipo de investigación incluía miembros de la Universidad de Carolina del Norte en Chapel Hill, la Universidad de Stanford y la Universidad Washington en San Luis; las fuentes no mencionan ninguna afiliación universitaria de ese tipo.
Los datos clave
- RRSI mantiene congelado el modelo de lenguaje base y evoluciona únicamente el entorno que rodea al agente.
- Las ediciones propuestas se redactan con Claude en Vertex AI y se evalúan en benchmarks de Docker.
- La lógica central de selección de ediciones se ejecuta en Python puro, sin claves de API ni GPUs.
- Una pantalla de filtrado bloquea las ediciones que podrían revelar accidentalmente las respuestas de prueba.
- Un presupuesto en enfriamiento permite que el agente realice muchas ediciones al principio y menos en fases posteriores.
Fuentes
- Google Research RRSI Guide: Mastering Self-Improving AI Agents — marktechpost.com
- GitHub - google-research/rrsi
- PDF RRSI: Regularized Recursive Self-Improvement of Agent Harnesses — regularized-rsi.com
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AI
Esta semana en IA: llegan nuevos modelos y los agentes se vuelven más seguros
Grandes lanzamientos de modelos de pesos abiertos, avances de velocidad y un impulso para que los agentes de IA sean más fiables y seguros.
 Empresas y reglasMirendil recauda 1.000 millones de dólares para desarrollar modelos de IA con mayor rapidezHerald of AI
Mirendil recauda 1.000 millones de dólares para desarrollar modelos de IA con mayor rapidez
Una nueva startup fundada por antiguos investigadores de Google DeepMind y Anthropic dice que su plataforma automatizada permite a equipos pequeños construir grandes modelos de IA con rapidez y bajo coste.
 Apps y productosJ.Crew lanza un estilista con inteligencia artificial impulsado por los modelos Claude de AnthropicHerald of AI
J.Crew lanza un estilista con inteligencia artificial impulsado por los modelos Claude de Anthropic
Ahora los compradores en EE. UU. pueden describir una ocasión y recibir un atuendo completo de J.Crew: todo usando Claude, en lugar de buscar cada pieza por separado.