Arquitectura de DeepSeek V3 **reimplementada** en 190 líneas de código, entrenada en un MacBook Air
Un desarrollador mostró cómo encajar la arquitectura de DeepSeek V3 en una base de código diminuta: útil para aprender, aún no lista para chatear.
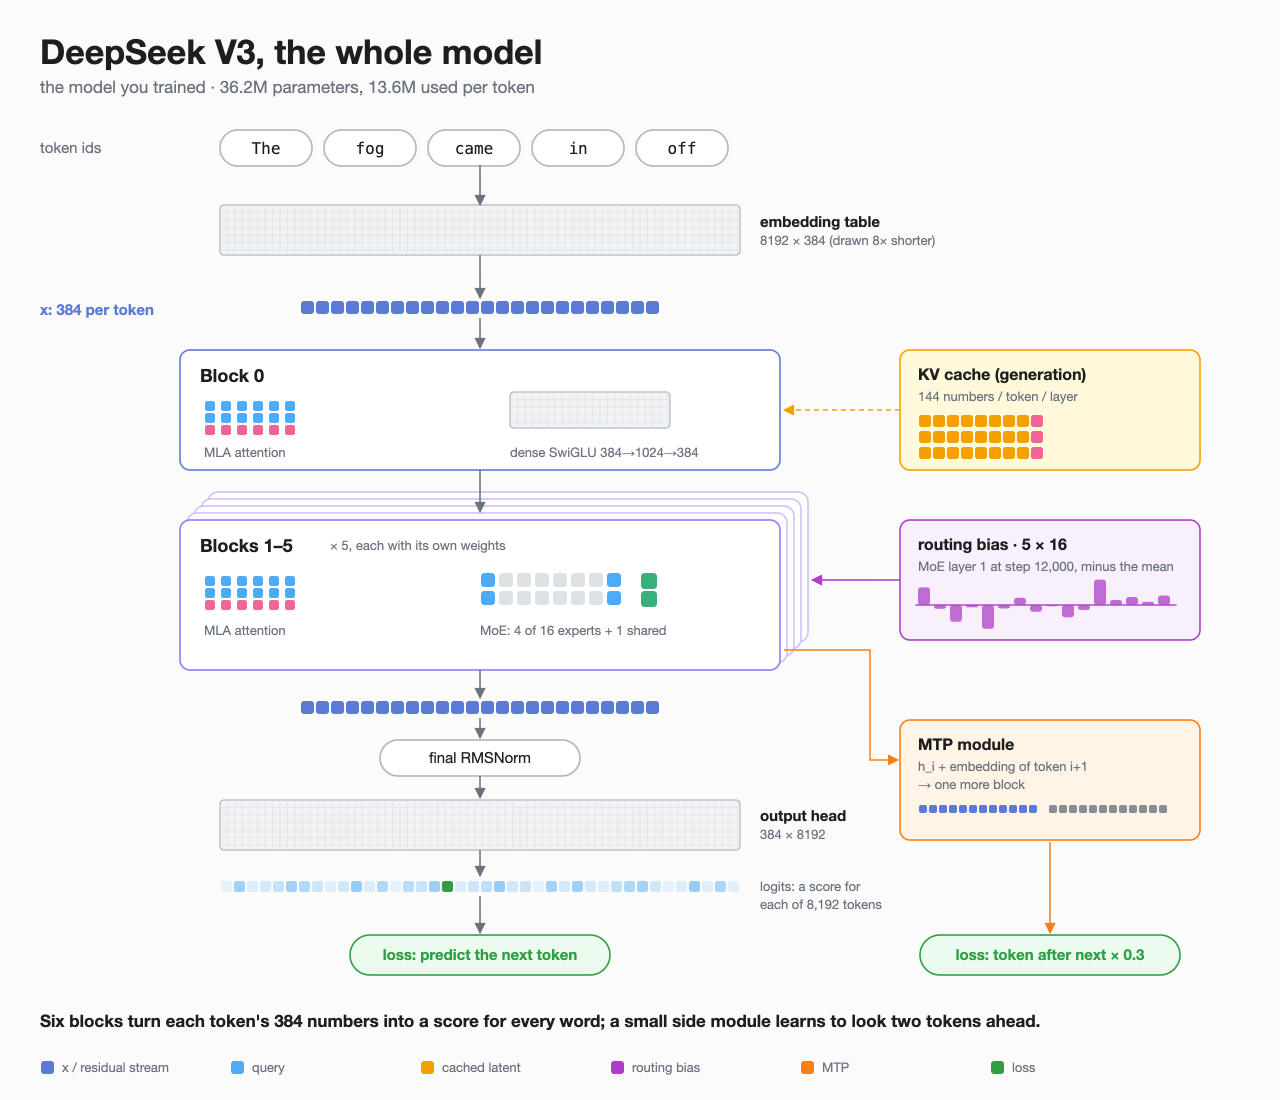
Una versión de enseñanza reducida de un modelo de lenguaje grande, escrita en 190 líneas y entrenada en una laptop.
- Descarga el código desde GitHub
- Ejecuta un script para bajar novelas policíacas
- Entrena el modelo en tu Mac durante unas horas
- Escribe un prompt y mira cómo aparece texto
Qué se puede hacer con ello
- Un estudiante podría leer el código de 190 líneas de arriba abajo para ver cómo funcionan las ideas clave de diseño de DeepSeek-V3 dentro de su propia implementación 1.
- Un aficionado con un Mac de Apple Silicon podría reproducir él mismo el entrenamiento, construyendo el conjunto de datos y ejecutando el modelo desde cero 3.
- Un desarrollador podría estudiar cómo se implementan en la práctica técnicas como la Atención Latente Multi-Cabeza y el equilibrio de carga libre de pérdida auxiliar 1.
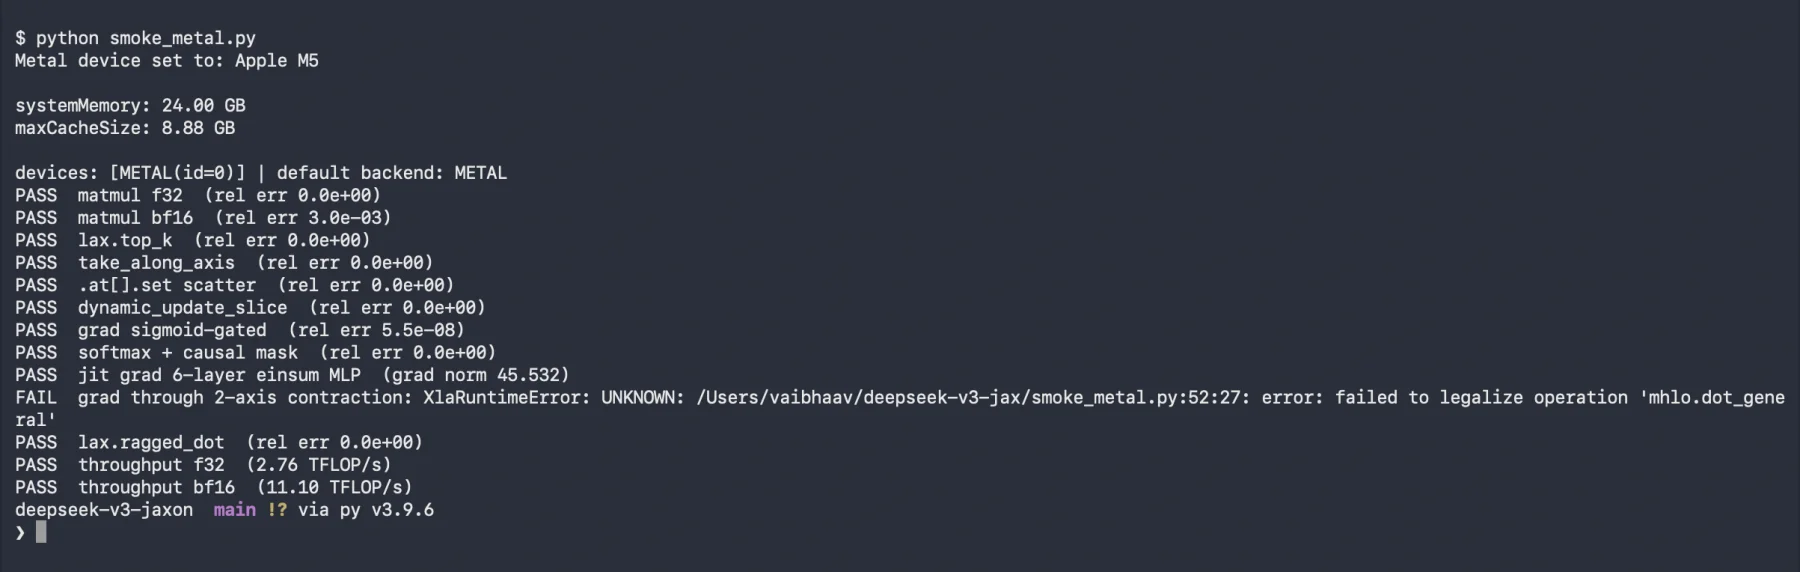
Imagen: vaibhaav.in
Words to know
- Multi-head Latent Attention (MLA): guarda un pequeño resumen numérico por token en lugar de detalles completos, ahorrando memoria · Mixture of Experts (MoE): selecciona solo unas pocas subredes especializadas por entrada en lugar de ejecutarlas todas · equilibrio libre de pérdida auxiliar: un truco que anima a los expertos a repartirse el trabajo de forma pareja sin añadir un término de coste separado al entrenamiento
Esta demostración docente vs. el verdadero DeepSeek‑V3
Cifras del artículo de blog y readme de GitHub de Vaibhaav Tiwari; especificaciones de DeepSeek‑V3 del informe técnico de diciembre de 2024.
De qué trata el proyecto
El repositorio de GitHub de Tiwari contiene una reimplantación autónoma de las ideas clave detrás de DeepSeek-V3, el gran modelo abierto publicado en diciembre de 2024 por DeepSeek-AI 12. El archivo deepseek_v3.py tiene 190 líneas de Python/JAX plano: no hay bibliotecas adicionales como Flax o Equinox, cada parámetro es un diccionario estándar de arrays, y cada pieza del modelo es una sola función que puedes leer de arriba abajo . La entrada de blog acompañante en vaibhaav.in explica el código paso a paso y muestra diagramas 3.
Él describe el resultado como «una demostración de arquitectura, no un modelo de lenguaje potente» 1.
Cómo se entrenó
El modelo pequeño tiene 36,2 millones de parámetros en total, con 13,6 millones activos por cada token porque usa un diseño de Mezcla de Expertos 1. Se preentrenó desde cero durante unos 12.000 pasos (aproximadamente 98 millones de tokens, o 4,5 pasadas sobre los datos) usando novelas policíacas del Proyecto Gutenberg, principalmente de Dashiell Hammett, que se incluyeron tres veces . La validación usó ficción policial retenida . El entrenamiento se ejecutó en un MacBook Air con chip M5 y 24 GB de memoria unificada a través del plugin Metal de JAX, que permite usar las GPUs de Apple Silicon como aceleradores para JAX 3. La ejecución terminó en aproximadamente 2,6 horas a una velocidad media de unas 10.700 tokens por segundo y alcanzó una pérdida de validación final de 3,51 . Para comparar, la pérdida de validación bajó de 5,02 en el paso 250 hasta 3,51 al final .
El conjunto de datos se descargó automáticamente mediante un script llamado prepare_data.py, que limpia los libros, construye un tokenizador Byte-Pair-Encoding de 8.192 tokens y escribe los archivos train.bin y val.bin 1.
Técnicas principales mostradas
La implementación incluye cuatro características que provienen directamente del artículo de DeepSeek-V3 12:
- Atención Latente Multi-Cabeza (MLA): cada capa almacena en caché solo 144 números por token en lugar de 480, combinando claves compartidas con valores comprimidos 1.
- Codificación posicional rotativa desacoplada (RoPE): una clave rotativa se mantiene fuera del latente comprimido y se aplica por separado 1.
- DeepSeek-MoE: un experto compartido siempre activo más 16 expertos enrutados, con cada token enviado a los 4 mejores 1.
- Equilibrio de carga libre de pérdida auxiliar: un pequeño sesgo por experto desvía el enrutamiento hacia expertos ociosos; esto hizo que el uso por experto oscilara entre el 5,7 % y el 6,9 % en lugar del muy desigual 0,09 % al 18,6 % observado sin el sesgo, mientras la pérdida de validación se mantuvo igual 1.
- Predicción multi-token (MTP): una cabeza adicional también predice el siguiente-next token, ponderado en 0,3 en la pérdida 1.
En comparación con el modelo completo de DeepSeek-V3 descrito en el informe técnico de diciembre de 2024, esta es una versión a escala docente centrada en mostrar la estructura, no en igualar la calidad de producción 12.
Cómo probarlo otros
El lanzamiento incluye un punto de control (ckpt.pkl, 138 MB) y un tokenizador 1. Para reproducir la ejecución, los usuarios necesitan un Mac de Apple Silicon con Python 3.12 y el gestor de paquetes uv; JAX debe quedarse en la versión 0.4.34 porque el backend metal está fijado a jax-metal==0.1.1 . Se menciona el entrenamiento solo en CPU pero más lento . Una nota breve advierte que el punto de control es un archivo pickle de Python y que solo debe cargarse desde fuentes confiables . La generación de muestras con el prompt que comienza «The fog came in off the...» produce un resultado como «The fog came in off the bay, and the great trees were spreading and the stars were shining» .
Las instrucciones completas, el código, los gráficos y el escrito detallado están disponibles en GitHub bajo Vaibhaav-Tiwari/deepseek-v3-jax 1.
Qué no hace este proyecto
El proyecto no cubre la arquitectura completa de DeepSeek-V3 a su escala publicada, que contiene cientos de miles de millones de parámetros y requiere clusters de GPUs de centros de datos 2. Se detiene en un modelo de ~36 millones de parámetros entrenado con unos 21,7 millones de tokens de novelas policíacas de dominio público 1. No se reportaron benchmarks contra otros modelos de lenguaje .
Qué tan bueno es
El propio proyecto reconoce que el resultado no es potente: describe la salida como «una demostración de arquitectura, no un modelo de lenguaje potente» 1. Alcanzó una pérdida de validación final de 3,51 después de 12.000 pasos con ~98 millones de tokens de novelas policíacas . La pérdida de validación bajó de 5,02 en el paso 250 a 3,51 al final, y no hay benchmarks rivales reportados .
Correcciones y actualizaciones
- Corregido el 15 de noviembre de 2026. Una versión anterior afirmaba que el modelo se había entrenado con menos de 25 millones de palabras; la fuente indica 21,7 millones de tokens de entrenamiento, medidos en tokens y no en palabras, y especifica el género con más precisión como novela policíaca.
Los datos clave
- 190 líneas de JAX puro implementan MLA, MoE y predicción multi-token al estilo DeepSeek-V3
- Entrenado en un MacBook Air M5 (24 GB) en ~2,6 horas, alcanzando pérdida de validación 3,51
- El modelo tiene 36,2M de parámetros, 13,6M activos por token, aprendió de 21,7M de tokens de novela policiaca
- El sesgo de equilibrio de carga por experto hizo el uso parejo (5,7–6,9 %) sin cambiar la pérdida
- Publicado como demostración de arquitectura en GitHub con punto de control y scripts de entrenamiento
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 Empresas y reglasMirendil recauda 1.000 millones de dólares para desarrollar modelos de IA con mayor rapidezHerald of AI
Mirendil recauda 1.000 millones de dólares para desarrollar modelos de IA con mayor rapidez
Una nueva startup fundada por antiguos investigadores de Google DeepMind y Anthropic dice que su plataforma automatizada permite a equipos pequeños construir grandes modelos de IA con rapidez y bajo coste.
Stanford da a los modelos de IA congelados una memoria súper poderosa que solo necesita 16 tokens
Investigadores convirtieron toda una biblioteca de documentos en 16 señales diminutas para que una IA protegida pueda responder preguntas sin repensar todo cada vez.
 Cómo funcionaCómo Meta triplica la productividad de ingeniería usando agentes para propagar técnicas de modelos publicitariosHerald of AI
Cómo Meta triplica la productividad de ingeniería usando agentes para propagar técnicas de modelos publicitarios
El nuevo sistema de agentes de IA de Meta adapta pequeñas mejoras en miles de modelos publicitarios de forma automática, ahorrando millones en costos de computación.