El CheMeleon del MIT aprende química de un millón de moléculas para que las farmacéuticas necesiten una experimentación mucho menor
Un nuevo modelo de inteligencia artificial entrenado con datos básicos sobre moléculas puede predecir el comportamiento de nuevos químicos, reduciendo los ensayos y errores que hacen lentos y costosos el descubrimiento de fármacos y materiales.
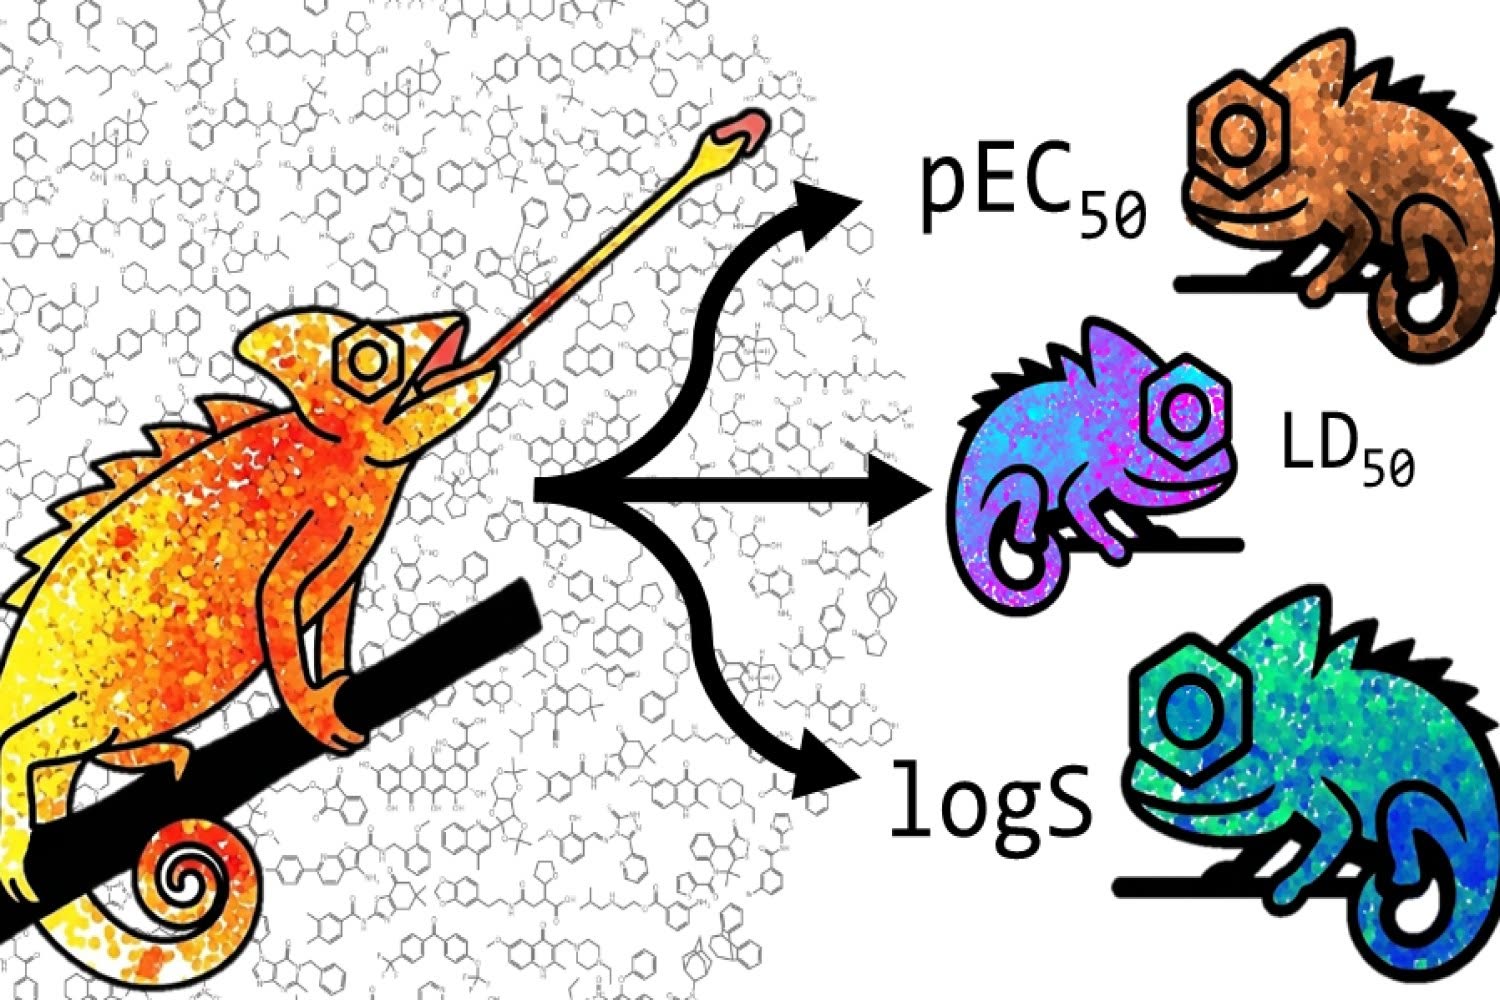
Cómo funciona
Un programa de IA que predice cómo se comportarán los productos químicos para que las empresas necesiten menos experimentos en el laboratorio
- Aprende química a partir de un millón de moléculas registradas
- Le indicas una nueva molécula que quieres estudiar
- Lo ajustas con unas pocas mediciones reales que ya tienes
- Predice la propiedad sin tener que hacer muchas pruebas nuevas
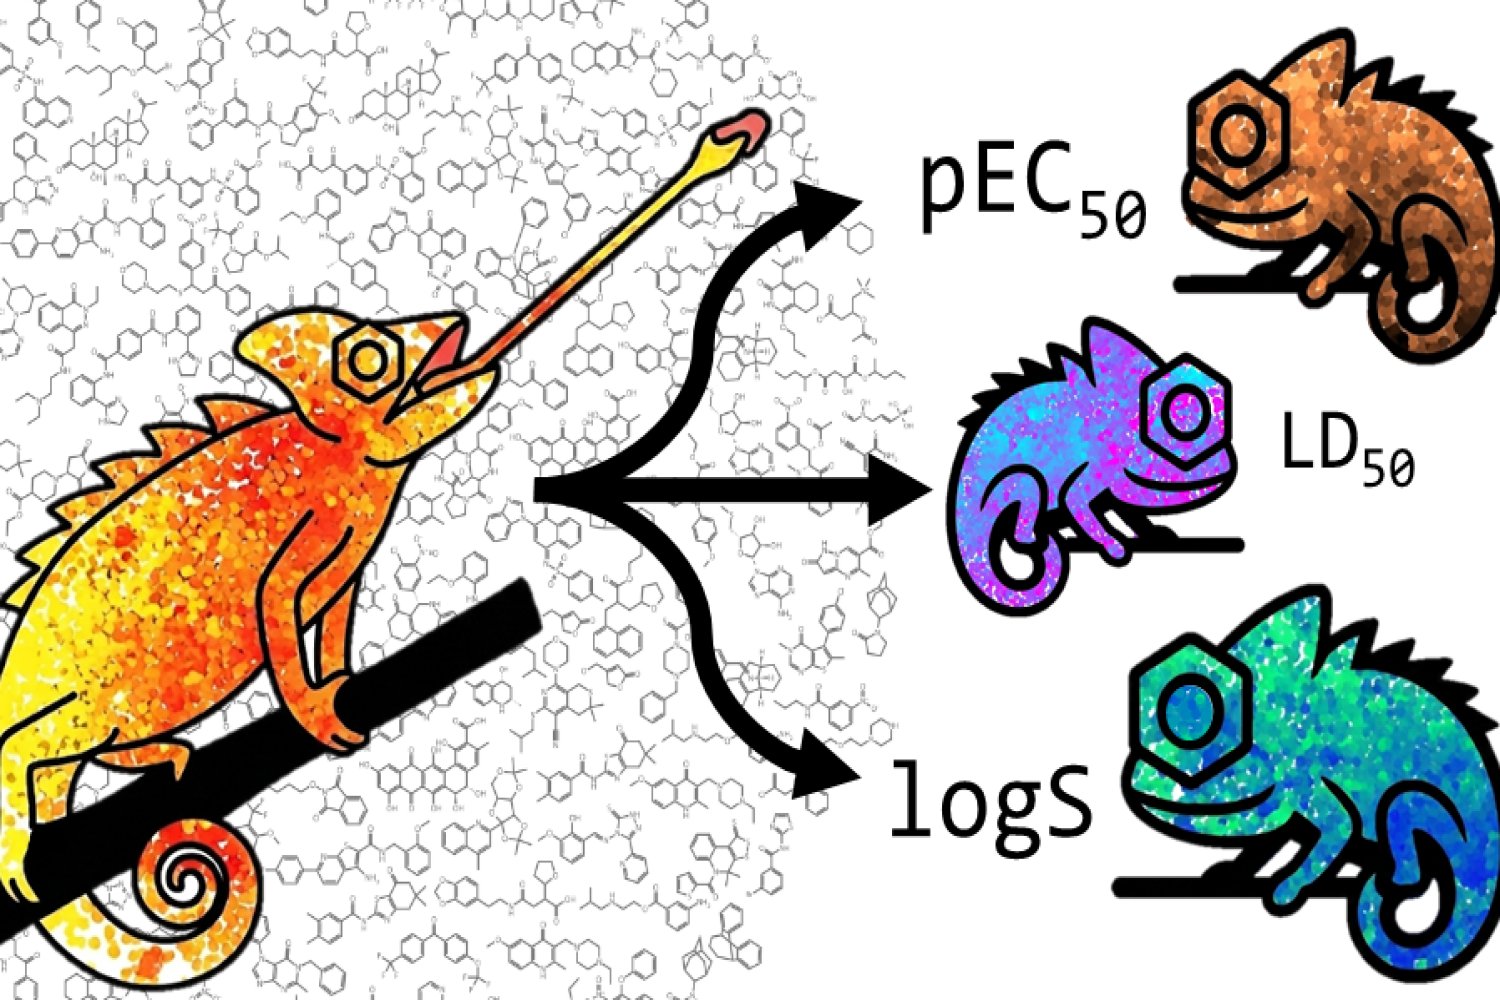
Imagen: news.mit.edu
Adivina
¿De cuántas moléculas más o menos aprendió CheMeleon?
El equipo del MIT extrajo y calculó características a partir de aproximadamente un millón de moléculas de PubChem.
Aprender química, no literatura
Algunos modelos exitosos usan datos extensos de la literatura publicada en revistas químicas 1. El equipo del MIT siguió un camino diferente . Partieron de PubChem, una base de datos de acceso libre gestionada por los Institutos Nacionales de Salud de Estados Unidos, y extrajeron información sobre aproximadamente un millón de moléculas . A partir de cada molécula calcularon características sencillas de obtener, como el peso molecular, el número de átomos de oxígeno, lo ramificado o voluminoso que es su estructura, y unas 1.600 descriptoras similares que los químicos han reunido a lo largo de décadas .
Primero se le pidió al modelo que adivinara esos descriptores solo a partir de la estructura molecular 1. Eso podría parecer un ejercicio circular hacia lo ya conocido, pero obliga al sistema a descubrir por sí mismo cómo se relacionan los arreglos atómicos con rasgos químicos medibles . "No lo estamos entrenando para una propiedad específica, sino como un modelo general que comprende un nivel de química", dijo el estudiante de posgrado Akshat Shirish Zalte . Una vez sentadas esas bases, el mismo modelo puede ajustarse para una tarea concreta —solubilidad, toxicidad, la fuerza con la que un compuesto se une a una proteína— con muchos menos ejemplos etiquetados de los que necesitaría un modelo entrenado desde cero .
Un ejemploInventado para explicarlo
Maya, revisando si un compuesto nuevo se disuelve bien
Maya¿Qué tanto se disuelve esta molécula en agua?
CheMeleonEso puedo predecirlo. ¿Ya tienes alguna medición?
MayaSolo tres, de unos cuantos ejemplos.
CheMeleonCon esas tres basta. Aquí te doy mi predicción.
Maya¡Me ahorra semanas de trabajo en el laboratorio!
Con solo unos cuantos experimentos obtuvo una estimación confiable de su solubilidad.
Adopción real antes de la revisión por pares
Los resultados se enviaron a la Journal of Chemical Information and Modeling el 14 de septiembre, pero el interés práctico llegó meses antes 1. A principios de este año, OpenADMET, una organización que organiza competiciones para predecir propiedades de moléculas nunca producidas, realizó un concurso . Cuando se anunciaron los ganadores, nueve de los veinte primeros equipos habían usado CheMeleon como parte de sus procesos .
Esa racha llamó la atención. El profesor William Green, catedrático Hoyt Hottel de Ingeniería Química en el MIT, dijo que al menos una farmacéutica envió un memorando a todos sus investigadores ordenándoles empezar cualquier proyecto de modelado de propiedades con CheMeleon 1. "Cada vez que modele una propiedad, empiece con CheMeleon; esa es nuestra nueva política corporativa", según se informa . El código abierto está integrado en ChemProp, otra herramienta mantenida por el grupo de Green, y cualquiera puede descargarla y adaptarla .
Por qué la escasez lo cambia todo
La fortaleza del modelo se muestra con mayor claridad cuando los datos son escasos 1. Desarrollar un nuevo fármaco suele significar perseguir un objetivo celular recién descubierto para el cual casi no existen datos de unión . Los enfoques clásicos, donde los expertos construyen fórmulas manualmente basándose en relaciones conocidas entre descriptores y resultados, tienen dificultades en esa situación porque no hay nada familiar que los ancle . Los modelos de aprendizaje profundo normalmente requieren aún más datos que los métodos tradicionales . CheMeleon, en cambio, aporta conocimiento previo de la química y solo necesita una pequeña cantidad de información específica de propiedades para alcanzar una precisión útil .
Un millón de moléculas sigue siendo una fracción minúscula de las formas casi infinitas en que los átomos pueden unirse, pero el equipo encontró que era suficiente para que la IA captara patrones subyacentes y los transfiriera a estructuras completamente nuevas 1. Los investigadores del MIT, entre ellos el reciente graduado Jackson Burns PhD '26 y el científico investigador Charlles Abreu, colaboraron con tres científicos de la empresa química BASF en el estudio . Una versión anterior del artículo circula en línea desde el año pasado, y el modelo de código abierto ya ha entrado en uso habitual en varias farmacéuticas .
Esta nota informa sobre una tendencia con fines exclusivamente informativos. No constituye asesoramiento ni recomendación para hacer ninguna de estas cosas.
Qué tan bueno es
El equipo comparó CheMeleon contra otros modelos de base existentes y contra modelos clásicos guiados por expertos en 58 casos de prueba, y CheMeleon quedó primero en cada comparación 1. El modelo destaca especialmente cuando los datos son escasos, justo cuando el descubrimiento de fármacos suele tener problemas porque los objetivos celulares recientes tienen poca o ninguna datos de unión disponibles . No se publicaron puntuaciones numéricas específicas en la fuente, por lo que el ranking solo se describe como quedar primero en las 58 pruebas . Nueve de los veinte primeros equipos en una competición de OpenADMET también usaron CheMeleon, lo que muestra que funciona bien bajo condiciones de evaluación independientes .
Correcciones y actualizaciones
- Corregido el 10 de noviembre de 2026. Una versión anterior indicaba que la mayoría de los modelos de IA de química se alimentaban de artículos académicos; la fuente atribuyó esa afirmación solo a algunos modelos exitosos. Una versión anterior también insinuaba que la instrucción farmacéutica llegó después de la revisión por pares; la fuente la describió como algo que ocurrió mientras el artículo aún estaba bajo revisión.
Los datos clave
- CheMeleon es un modelo fundacional preentrenado desarrollado en el MIT que aprende química general a partir de aproximadamente un millón de registros de PubChem utilizando alrededor de 1.600 descriptores moleculares.
- Nueve de los veinte primeros equipos en el concurso de predicción OpenADMET utilizaron CheMeleon, lo que al menos motivó a una compañía farmacéutica a adoptarlo como punto de partida predeterminado para el modelado de propiedades.
- El modelo supera tanto a los métodos clásicos impulsados por expertos como a los enfoques típicos de aprendizaje profundo cuando hay pocos datos sobre una propiedad objetivo.
- CheMeleon es de código abierto y se puede descargar a través de ChemProp, un paquete mantenido por el MIT; el equipo de investigación incluye autores del MIT y de BASF.
Fuentes
Sigue leyendo
 Nuevos modelosGPT-6 Astra repara la habilidad matemática de Qwen3.5 reescribiendo su cerebro sin ningún entrenamientoHerald of AINuevos modelos
GPT-6 Astra repara la habilidad matemática de Qwen3.5 reescribiendo su cerebro sin ningún entrenamiento
Investigadores del MIT mostraron que un único modelo de IA de vanguardia puede leer y editar los números internos de otro modelo para hacerlo mucho más inteligente en matemáticas: sin necesidad de entrenamiento.