Il CheMeleon del MIT impara la chimica da un milione di molecole così i produttori di farmaci servono molti meno esperimenti
Un nuovo modello di AI addestrato sui fatti fondamentali delle molecole può prevedere come si comporteranno le nuove sostanze chimiche, riducendo il metodo per tentativi ed errori che rende lenta e costosa la scoperta di farmaci e materiali.
Come funziona
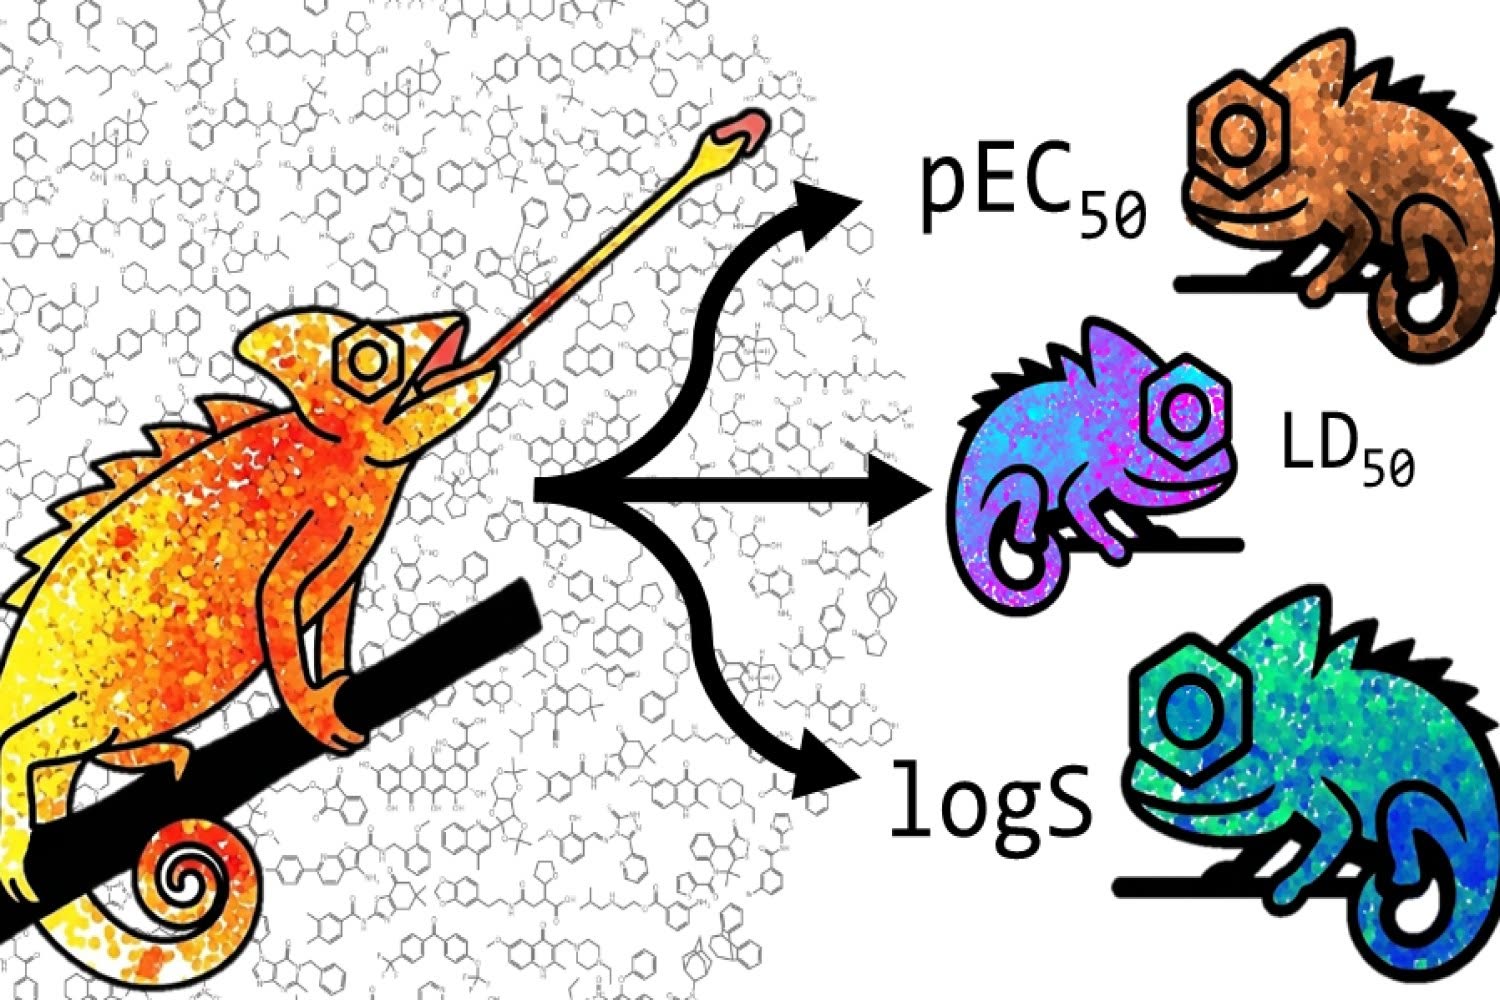
Un programma di intelligenza artificiale che prevede come si comportano le sostanze chimiche, così le aziende devono fare meno esperimenti in laboratorio
- Impara la chimica da un milione di molecole registrate
- Gli indichi una nuova molecola che vuoi studiare
- Lo migliori con qualche misura reale che hai già
- Prevede la proprietà senza dover fare tanti nuovi test
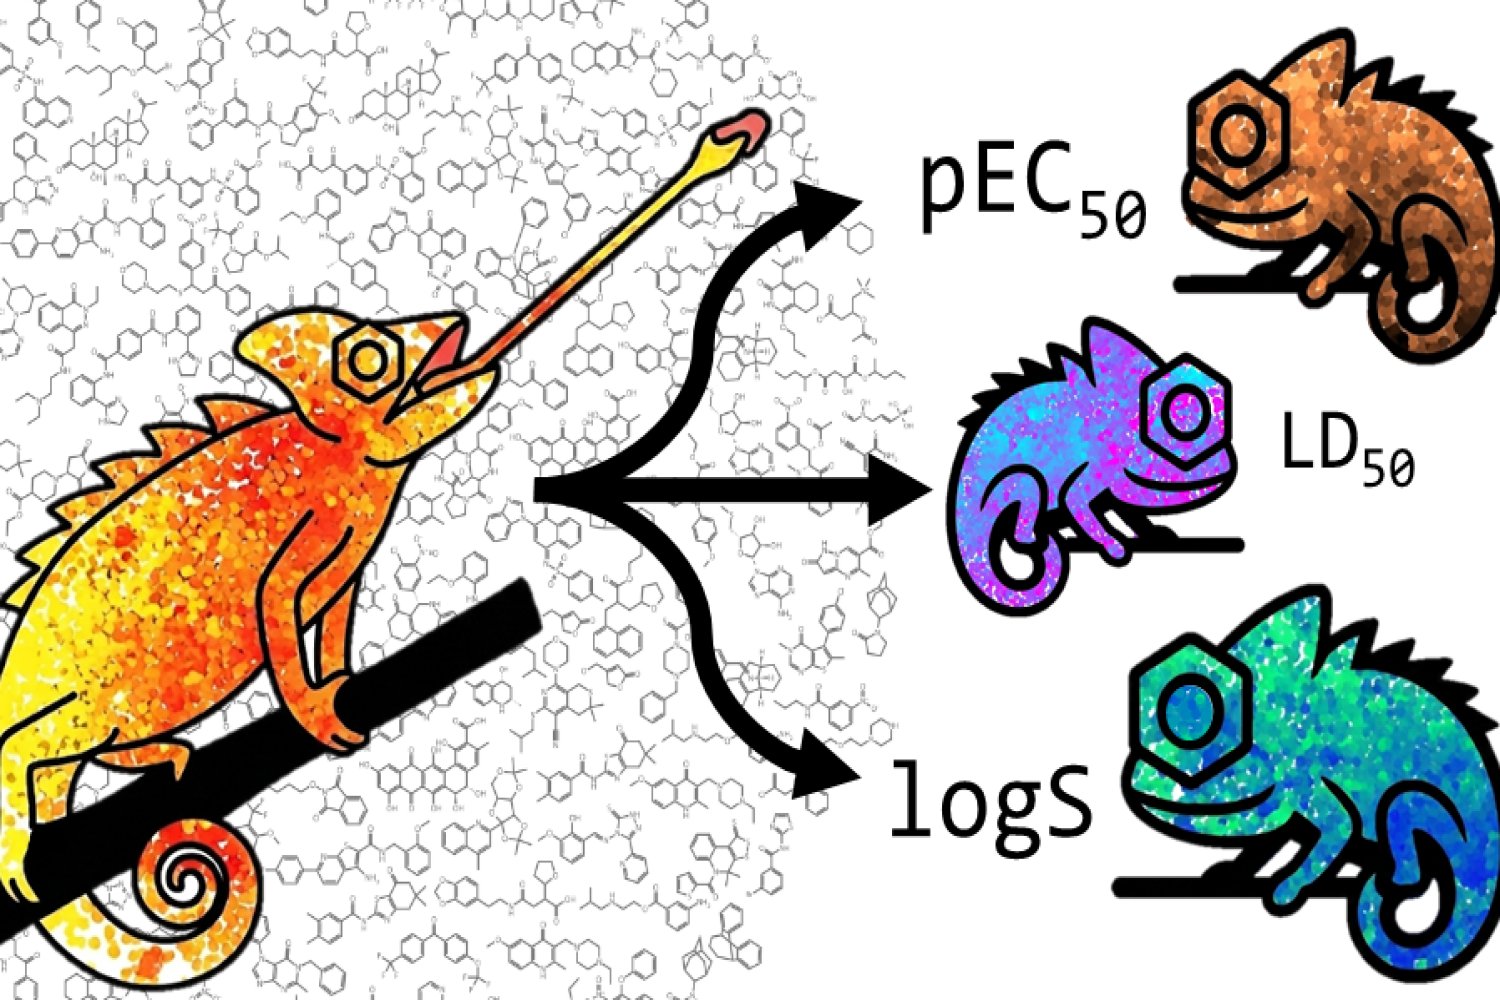
Immagine: news.mit.edu
Indovina
Da quante molecole circa ha imparato CheMeleon?
Il team del MIT ha preso e calcolato le caratteristiche da circa un milione di molecole in PubChem.
Imparare la chimica, non la letteratura
Alcuni modelli di successo usano dati estesi tratti dalla letteratura pubblicata sulle riviste di chimica 1. Il team del MIT ha preso una strada diversa . Hanno iniziato con PubChem, un database gratuitamente disponibile gestito dai National Institutes of Health degli Stati Uniti, e hanno prelevato informazioni su circa un milione di molecole . Da ogni molecola hanno calcolato caratteristiche facili da calcolare, come il peso molecolare, il numero di atomi di ossigeno, quanto la struttura è ramificata o ingombrante, e circa 1.600 descrittori simili raccolti dai chimici nel corso dei decenni .
Al modello è stato chiesto inizialmente di indovinare quei descrittori partendo dalla sola struttura molecolare 1. Questo può sembrare un esercizio in cui si torna a ciò che già si conosce, ma costringe il sistema a capire da sé come gli arrangiamenti atomici si colleghino ai tratti chimici misurabili . "Non stiamo addestrandolo per una proprietà specifica, ma come modello generale che comprende un certo livello di chimica", ha detto lo studente laureando Akshat Shirish Zalte . Una volta messo a punto questo fondamento, lo stesso modello può essere affinato per un compito particolare — solubilità, tossicità, intensità con cui un composto si lega a una proteina — con molte meno esempi etichettati di quanto servirebbe a un modello addestrato da zero .
Un esempioInventato per spiegare
Maya, che verifica se un nuovo composto si scioglie bene
MayaQuanto è solubile questa molecola in acqua?
CheMeleonPosso prevederlo. Hai già delle misurazioni?
MayaSolo tre, prese da alcuni campioni.
CheMeleonQueste tre bastano. Ecco la mia previsione.
MayaCosì mi risparmio settimane di lavoro in laboratorio.
Ha ottenuto una stima della solubilità affidabile con solo pochi esperimenti.
Adozione reale prima della revisione tra pari
I risultati sono stati sottoposti al Journal of Chemical Information and Modeling il 14 settembre, ma l'interesse pratico è arrivato mesi prima 1. All'inizio di quest'anno OpenADMET, un'organizzazione che gestisce sfide per la previsione delle proprietà di molecole mai prodotte, ha tenuto una competizione . Quando sono stati annunciati i vincitori, nove delle venti squadre migliori avevano usato CheMeleon come parte della loro pipeline .
Quella striscia ha attirato l'attenzione. Il professor William Green, Hoyt Hottel Professor of Chemical Engineering al MIT, ha dichiarato che almeno una compagnia farmaceutica ha inviato un memo a tutti i propri ricercatori invitandoli a iniziare qualsiasi progetto di modellazione delle proprietà con CheMeleon 1. "Ogni volta che modelli una proprietà, parti con CheMeleon, questa è la nostra nuova policy aziendale", secondo quanto riferito diceva il messaggio . Il codice open-source si trova all'interno di ChemProp, un altro strumento curato dal gruppo di Green, e chiunque può scaricarlo e adattarlo .
Perché la scarsità cambia tutto
La forza del modello emerge chiaramente soprattutto quando i dati sono scarsi 1. Sviluppare un nuovo farmaco spesso significa inseguire un target cellulare scoperto di recente per cui quasi non esistono dati di legame . Gli approcci classici — dove gli esperti costruiscono manualmente formule basate su relazioni note tra descrittori e risultati — faticano in quella situazione perché non c'è nulla di familiare su cui ancorarsi . I modelli di deep learning solitamente richiedono ancora più dati dei metodi tradizionali . CheMeleon, invece, porta a sostegno conoscenze prévie sulla chimica e ha bisogno solo di una piccola quantità di informazioni specifiche sulla proprietà per raggiungere un'accuratezza utile .
Un milione di molecole resta una frazione minuscola dei quasi infiniti modi in cui gli atomi possono legarsi insieme, ma il team ha scoperto che è sufficiente perché l'AI colga schemi sottostanti e li trasferisca a strutture completamente nuove 1. I ricercatori del MIT, tra cui il recentemente laureato Jackson Burns PhD '26 e il ricercatore Charlles Abreu, hanno collaborato con tre scienziati della società chimica BASF nello studio . Una versione precedente dell'articolo circola online dall'anno scorso, e il modello open-source è già entrato nell'uso regolare presso diverse aziende farmaceutiche .
Questo articolo segnala una tendenza a scopo puramente informativo. Non costituisce un consiglio né un incoraggiamento a fare alcuna di queste cose.
Quanto è bravo
Il team ha confrontato CheMeleon con altri modelli foundation esistenti e con modelli classici guidati dagli esperti su 58 casi di test, e CheMeleon ha ottenuto il primo posto in ogni confronto 1. Il modello è particolarmente forte quando i dati sono scarsi, che è esattamente quando la scoperta di farmaci spesso fatica perché i target cellulari recenti hanno pochi o nessun dato di legame disponibile . Nessun punteggio numerico specifico è stato pubblicato nella fonte, quindi il ranking è descritto solo come vincitore su tutti i 58 test . Nove delle venti squadre migliori in una competizione OpenADMET hanno inoltre usato CheMeleon, dimostrando che regge anche sotto condizioni di benchmark indipendenti .
Correzioni e aggiornamenti
- Corretto il 10 novembre 2026. Una versione precedente affermava che la maggior parte dei modelli di chimica basati su AI è addestrata su articoli pubblicati su riviste; la fonte ha attribuito tale affermazione solo ad alcuni modelli di successo. Una versione precedente inoltre lasciava intendere che l'istruzione farmaceutica fosse arrivata dopo il processo di peer review; la fonte la descriveva come avvenuta mentre il documento era ancora in fase di revisione.
I fatti principali
- CheMeleon è un modello foundation pre-addestrato sviluppato al MIT che impara la chimica generale da circa un milione di record di PubChem usando circa 1.600 descrittori molecolari.
- Nove delle venti squadre migliori nella competition di previsione OpenADMET hanno usato CheMeleon, spingendo almeno una compagnia farmaceutica a renderlo il punto di partenza predefinito per la modellazione delle proprietà.
- Il modello supera sia i metodi classici guidati dagli esperti sia gli approcci tipici di deep learning quando i dati su una proprietà bersaglio sono scarsi.
- CheMeleon è open source e scaricabile tramite ChemProp, un pacchetto curato dal MIT; il team di ricerca include autori del MIT e della BASF.
Fonti
Continua a leggere
 Nuovi modelliGPT-6 Astra risolve i problemi di matematica di Qwen3.5 riscrivendo il suo cervello senza addestramentoHerald of AINuovi modelli
GPT-6 Astra risolve i problemi di matematica di Qwen3.5 riscrivendo il suo cervello senza addestramento
Ricercatori del MIT hanno dimostrato che un singolo modello di AI all'avanguardia può leggere e modificare i parametri interni di un altro modello per renderlo molto più bravo a fare matematica — senza bisogno di addestramento.