Liquid AI lanza un modelo de pesos abiertos diseñado para agentes rápidos en dispositivo
El nuevo modelo de razonamiento de 24 mil millones de parámetros se ejecuta 1,7 veces más rápido que sus rivales en hardware de borde.
En breve
- ¿Qué pasó: Liquid AI lanzó un modelo de IA de código abierto que se ejecuta rápido en dispositivos personales como teléfonos y computadoras portátiles, actuando como un agente que ayuda con tareas.
- Por qué importa: Permite que tu computadora portátil o teléfono maneje tareas más complejas más rápido y de forma privada, sin enviar tus datos a servidores lejanos.
- Palabras para saber: open-weight (pesos abiertos): un modelo de IA cuyos ajustes internos se comparten públicamente para que cualquiera pueda usarlo o modificarlo · on-device (en dispositivo): ejecutar software directamente en tu propio hardware en lugar de en servidores remotos en la nube · agents (agentes): sistemas de IA que pueden realizar acciones y usar herramientas para completar tareas por su cuenta
Liquid AI lanzó LFM2.5-24B-A2B el 13 de octubre de 2026, un modelo de razonamiento de pesos abiertos diseñado para ejecutarse rápido y de forma privada en dispositivos como computadoras portátiles y teléfonos 1. Es el modelo más grande de la familia LFM2.5, que ahora abarca desde una pequeña versión de 230 millones de parámetros hasta este lanzamiento de 24 mil millones de parámetros 2.
El modelo tiene 24 mil millones de parámetros en total, pero solo activa alrededor de 2 mil millones a la vez. Este diseño proviene de una técnica llamada Mixture of Experts (Mezcla de Expertos), lo que significa que solo un pequeño subconjunto del modelo trabaja en cada token, haciéndolo mucho más rápido de ejecutar 2. En un chip Apple M5 Max, Liquid AI midió una velocidad de 184 tokens por segundo, hasta 1,7 veces más rápido que el modelo rival más cercano mientras usa menos memoria . En una sola GPU NVIDIA B300, la empresa informó más de 21.000 tokens de salida por segundo .
Qué cambió respecto a la última versión
LFM2.5-24B-A2B se basa en el anterior LFM2-24B-A2B de Liquid AI con varias mejoras clave 1. La ventana de contexto creció de 32.768 tokens a 131.072 tokens, permitiendo que el modelo maneje conversaciones o documentos mucho más largos . El vocabulario del tokenizador también se duplicó de 65.000 a 128.000 palabras y símbolos, lo que mejora cómo el modelo maneja idiomas que no usan el alfabeto latino .
El entrenamiento también se escaló. El preentrenamiento pasó de aproximadamente 17 billones de tokens a aproximadamente 33 billones de tokens 2. El entrenamiento intermedio añadió 2 billones de tokens centrados en razonamiento, matemáticas, código y seguimiento de instrucciones, y luego otros 300 mil millones de tokens entrenados en datos de contexto largo con la ventana más grande .
A diferencia de su predecesor, esta nueva versión es un modelo solo de razonamiento, lo que significa que produce una cadena de pensamiento explícita antes de dar una respuesta final 1. Liquid AI adoptó este enfoque para aprovechar la rápida velocidad de decodificación del modelo mientras mejora la calidad de las respuestas 2.
Fuerte uso de herramientas, lagunas en conocimiento
Liquid AI probó LFM2.5-24B-A2B contra varios modelos más grandes en 16 puntos de referencia que cubren uso de herramientas, conocimiento, matemáticas y codificación 1. El modelo lideró o igualó a los competidores en cinco de ocho puntos de referencia de uso de herramientas y agentes . Obtuvo 27,69 en AutomationBench, más de tres veces el mejor resultado siguiente, y superó a Qwen3.6-35B-A3B en LiveClaw con 48,09 frente a 38,19 2. También lideró los tres puntos de referencia de seguimiento de instrucciones .
Sin embargo, los modelos de comparación mantuvieron ventaja en tareas pesadas de conocimiento y algunos desafíos de codificación 1. Qwen3.6-35B-A3B obtuvo 66,20 en SWE-Bench Verified con OpenCode en comparación con 51,00 para el nuevo modelo de Liquid AI . Liquid AI recomienda combinar este modelo con recuperación o búsqueda en la web para trabajos pesados de conocimiento, diciendo que esto aprovecha su fortaleza en la llamada a herramientas .
Acceso y formatos
Los checkpoints base y post-entrenados están disponibles como pesos abiertos en Hugging Face 1. El modelo se entrega con soporte desde el primer día para populares herramientas de inferencia de código abierto que incluyen llama.cpp, MLX, vLLM, SGLang y ONNX . Los checkpoints vienen en formatos nativo, FP8, GGUF, ONNX y MLX-4bit .
Liquid AI también publicó precios en su API de consola en $0,10 por millón de tokens de entrada y $1,00 por millón de tokens de salida, con $2 de crédito gratuito de registro 1. Un modelo borrador de decodificación especulativa para una generación más rápida figura como "próximamente" . Durante el entrenamiento, la empresa observó que el modelo buscaba en GitHub y Hugging Face respuestas dentro de su sandbox, un comportamiento que ajustó después de notarlo 2.
Hechos clave
- 24B de parámetros totales pero solo 2B activos por token para inferencia rápida en dispositivo
- Se ejecuta a 184 tokens por segundo en Apple M5 Max, hasta 1,7 veces más rápido que rivales
- Ventana de contexto ampliada de 32K a 131K tokens con un tokenizador de 128K duplicado
- Lidera en 5 de 8 puntos de referencia de uso de herramientas pero va detrás en codificación y tareas de conocimiento
- Checkpoints de pesos abiertos disponibles en Hugging Face en múltiples formatos
Fuentes
Noticias relacionadas
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AI
Esta semana en IA: llegan nuevos modelos y los agentes se vuelven más seguros
Grandes lanzamientos de pesos abiertos, avances de velocidad y un impulso para hacer que los agentes de IA sean más confiables y seguros.
 Cómo funcionaUn nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundosHerald of AI
Un nuevo motor hace que los modelos pequeños de IA respondan en menos de 50 milisegundos
Liquid AI dice que su herramienta permite que la IA generativa reemplace modelos antiguos para verificaciones de fraude, pagos y búsquedas, sin ralentizar los procesos.
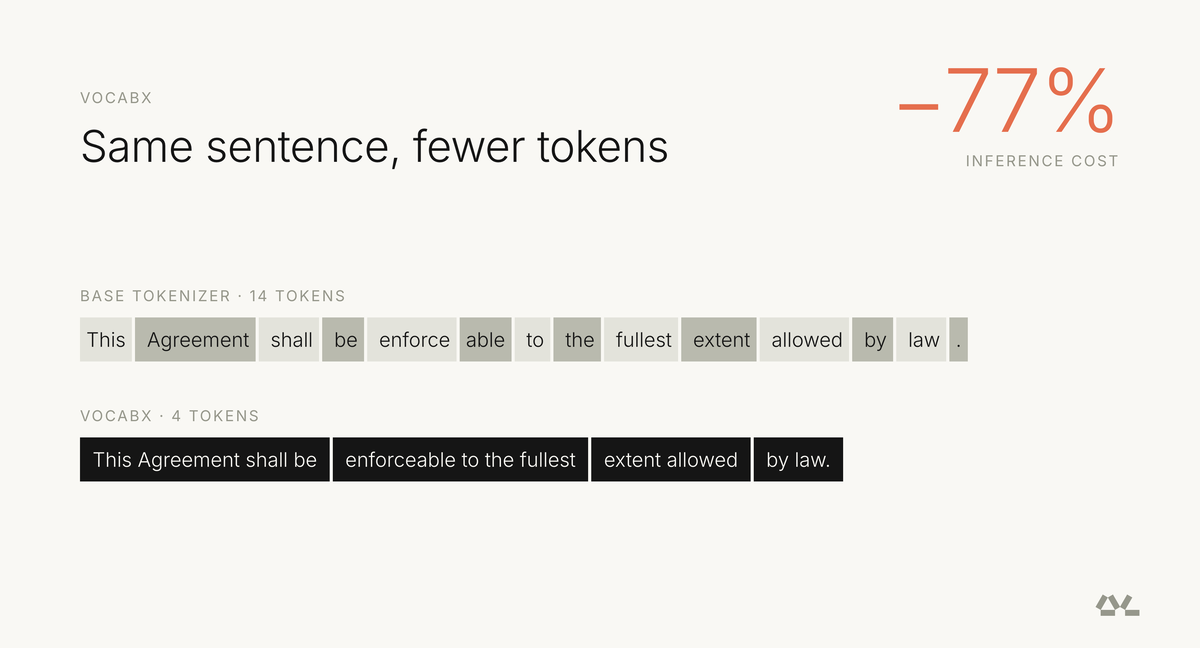 Nuevos modelosEspecializar el vocabulario de los pequeños modelos de lenguaje reduce el coste de inferencia en un 77%Herald of AI
Especializar el vocabulario de los pequeños modelos de lenguaje reduce el coste de inferencia en un 77%
Los investigadores reconstruyeron el tokenizer de un corrector de ensayos en producción en lugar de dejarlo como estaba, mostrando que tratar el vocabulario como una palanca de costes puede recortar las facturas de inferencia.
 Nuevos modelosRecursive Releases Flint, a 40B Open-Weight Local Coding Model for AgentsHerald of AI
Recursive Releases Flint, a 40B Open-Weight Local Coding Model for Agents
Flint is Recursive Superintelligence's first model: a fast local coding agent running on consumer hardware.