I ricercatori esaminano lo stop anticipato nei modelli di ragionamento AI e scoprono che le risposte possono peggiorare procedendo oltre
Un nuovo studio dimostra che lasciare andare avanti i modelli di ragionamento di grandi dimensioni anche dopo il punto in cui sembrano aver trovato la risposta può in realtà danneggiare l'affidabilità.
Come funziona
Una tecnica che interrompe prima il ragionamento di un modello AI per risparmiare calcolo quando sembra aver già trovato una risposta.
- Fai una domanda difficile a un modello di ragionamento
- Ferma il modello prima che finisca di ragionare
- Prendi la risposta che ha prodotto
- Confronta quella risposta con la versione a esecuzione completa
Cosa potresti farne
- I ricercatori potrebbero valutare i metodi di stop anticipato su cinque modelli di ragionamento in compiti di matematica, scienze, programmazione e correttezza fattuale utilizzando un protocollo condiviso di replay delle rollout 1.
- Gli sviluppatori che costruiscono sistemi che dipendono da lunghe catene di pensiero potrebbero utilizzare i risultati sull'affidabilità dello studio per evitare di fidarsi ciecamente degli output stoppate precocemente in applicazioni ad alto rischio 1.
- I team potrebbero applicare la nuova metrica Target-Integrated Token Efficiency (TITE) per misurare quanto calcolo viene risparmiato rispetto alla risposta ideale della corsa completa a vari obiettivi di accuratezza 1.
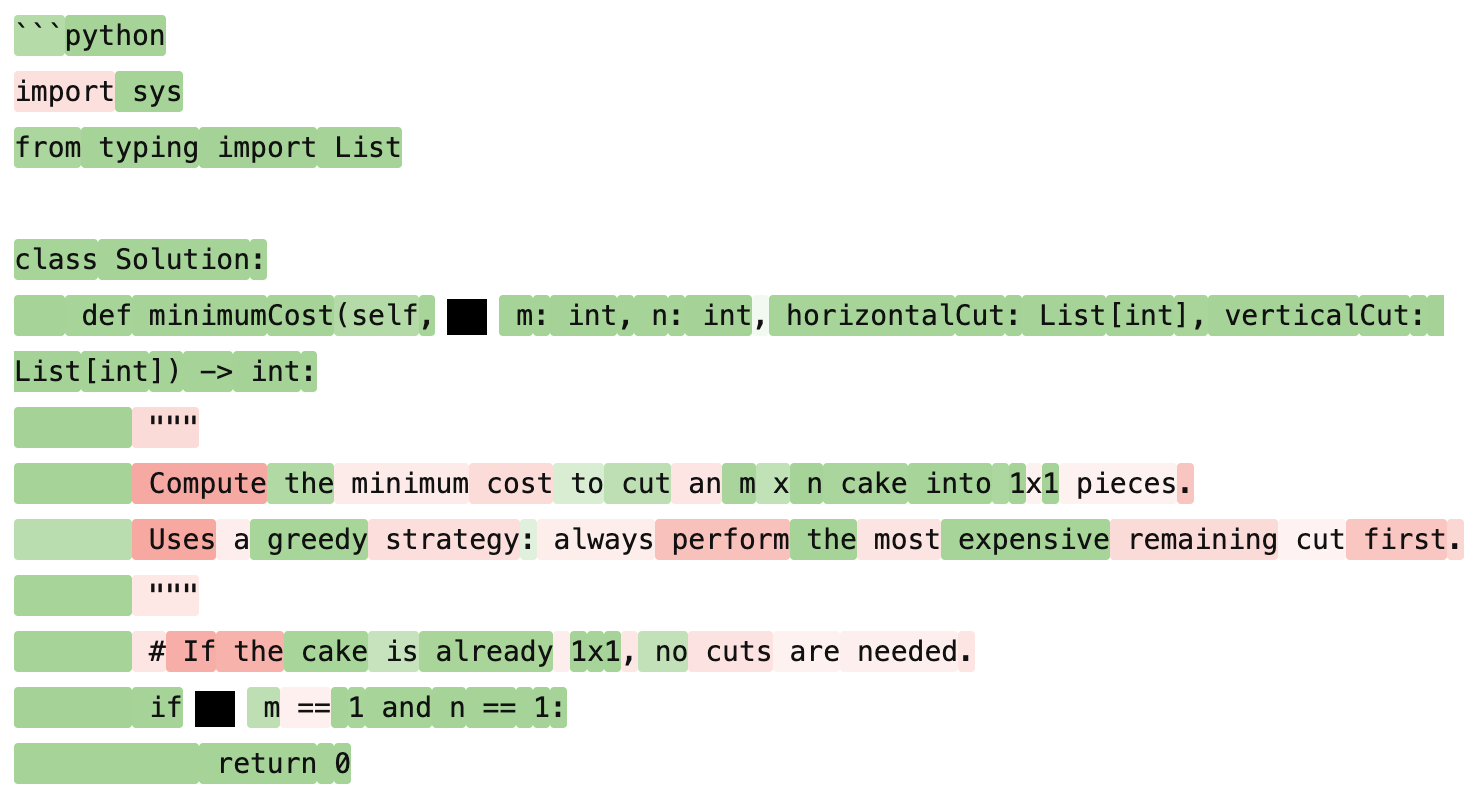
Figura: Nguyen et al., arXiv:2611.00166, CC BY 4.0
Un esempioInventato per spiegare
Ravi, uno sviluppatore che usa un modello di ragionamento per compiti di programmazione
RaviHo fermato prima il mio modello di ragionamento per risparmiare sui costi di calcolo.
CollegaAttenzione. Lo studio ha trovato lacune nell'affidabilità nei punti di uscita successivi.
RaviLe mie risposte però sembravano corrette. Era sicuro?
CollegaLa correttezza può diminuire oltre quanto previsto dai modelli di rumore. Inoltre, i modelli continuano a ragionare dopo l'arresto forzato.
RaviAllora il segnale di arresto non è affidabile?
CollegaUsa la metrica TITE per misurare il vero trade-off tra costo e precisione.
Ravi ha imparato che l'arresto anticipato può far risparmiare calcolo ma introduce rischi nascosti sull'affidabilità.
Parole da sapere
Stop anticipato (early stopping): interrompere la generazione della catena di pensiero di un modello una volta che sembra aver raggiunto una conclusione sufficiente · Oracle: la risposta ideale che un modello produrrebbe se girasse fino alla fine senza interruzioni
Cosa ha fatto lo studio
L'articolo, pubblicato su arXiv il 30 ottobre 2026 da Quang Hung Nguyen e colleghi, ha introdotto un protocollo condiviso di replay delle rollout per confrontare le strategie di stop anticipato su cinque modelli di ragionamento 1. La valutazione ha coperto ragionamento matematico e scientifico, generazione di codice e benchmark di correttezza fattuale .
I ricercatori hanno inoltre proposto una nuova metrica chiamata Target-Integrated Token Efficiency (TITE), che misura quanto calcolo viene risparmiato rispetto all'oracle — la risposta ideale della corsa completa — a vari obiettivi di accuratezza 1. Questo offre una comprensione più pratica del trade-off costo-beneficio rispetto ai conteggi grezzi di token presi da soli.
Indovina
Cosa succede quando un modello di ragionamento continua oltre il punto in cui sembra aver già trovato la risposta?
La correttezza può diminuire nelle posizioni di uscita successive, contrariamente a quanto gli sviluppatori potrebbero aspettarsi.
Sorprese sui risultati di affidabilità
L'esame ha messo in luce due principali problemi di affidabilità 1. In primo luogo, la correttezza può diminuire in posizioni di uscita successive oltre quanto previsto dal modello di rumore di decoding adattato, il che significa che il quadro statistico usato per giustificare l'arresto anticipato potrebbe essere troppo ottimista . In secondo luogo, i controlli di affidabilità hanno rivelato che i modelli continuavano a generare ragionamenti anche dopo l'interruzione forzata, suggerendo che il segnale di stop potrebbe non catturare in modo affidabile quando un modello ha effettivamente terminato il suo processo di pensiero .
Inoltre, alcuni output di stop anticipato corretti hanno mostrato un ragionamento di supporto più debole rispetto agli output della corsa completa, sollevando dubbi sul fatto che le giustificazioni del modello siano altrettanto solide quando fermato precocemente 1.
Cosa significa
Lo studio conferma che lo stop anticipato può ridurre il calcolo, ma mette in guardia dal fatto che questa pratica introduce rischi più sottili di quanto precedentemente riconosciuto 1. Gli sviluppatori che costruiscono sistemi che dipendono da lunghe catene di pensiero dovrebbero essere consapevoli che fermare un modello a metà pensiero non produce sempre una risposta pulita e stabile . L'implementazione completa è disponibile pubblicamente su GitHub .
I fatti principali
- Cinque modelli di ragionamento testati in compiti di matematica, scienze, programmazione e correttezza fattuale
- La nuova metrica TITE misura l'efficienza rispetto all'oracle a obiettivi di accuratezza
- La correttezza diminuisce in posizioni successive oltre le previsioni del modello
- I modelli hanno continuato a ragionare dopo l'interruzione forzata, evidenziando lacune di affidabilità
- Fonte: articolo su arXiv di Nguyen et al., ottobre 2026
Fonti
Continua a leggere
 Come funzionaAnthropic blocca Claude Code dal ricreare videogiochi esistentiHerald of AICome funziona
Anthropic blocca Claude Code dal ricreare videogiochi esistenti
Chi usava l'AI per copiare e portare giochi per console su PC ora si scontra con un muro usando Claude.
 Come funzionaApple Watch riceve funzioni AI per riassumere conversazioni e riascoltare ciò che ti sei persoHerald of AI▶
 Come funzionaI ricercatori propongono Avatar Intelligence per migliorare gli agenti AI nelle attività quotidianeHerald of AI
 Come funzionaArrowmax Arrowspace S1 usa l'AI e una fotocamera per trovare la vite giusta e regolare la potenzaHerald of AI▶