Ricercatori di AI costruiscono un sistema che impara cosa non sa per creare dati di allenamento migliori
Un nuovo framework multi-agente aiuta i sistemi AI a generare dati di allenamento più intelligenti identificando e correggendo le loro debolezze.
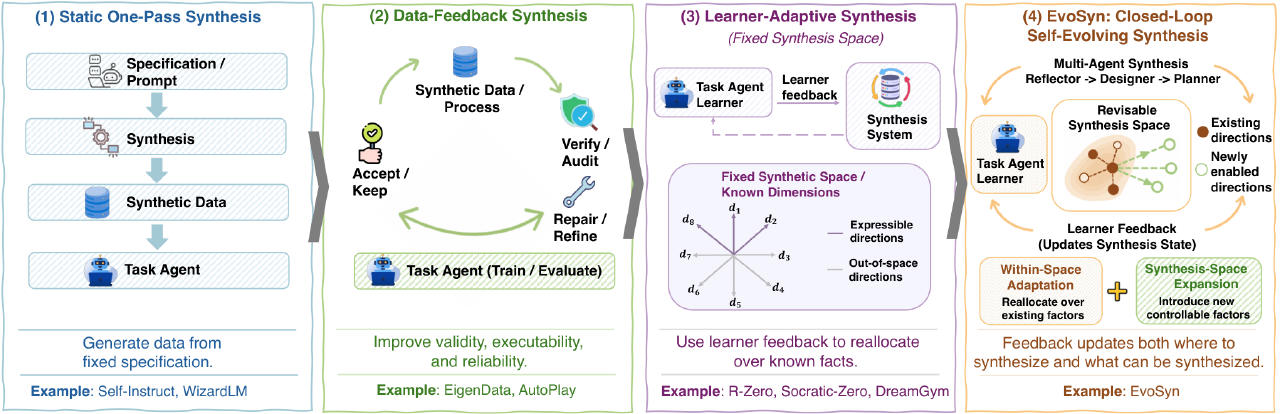
Un programma in cui diversi assistenti AI collaborano per scoprire i propri punti deboli e creare esercizi di pratica più intelligenti.
- Gli agenti AI provano dei compiti e falliscono
- Un designer sceglie quali lacune sono importanti
- Un pianificatore crea nuove esercitazioni
- Gli specialisti aggiornano i dati di addestramento basandosi sui feedback
Il Problema con i Dati di Allenamento AI
I modelli di linguaggio di grandi dimensioni continuano a migliorare, ma una grande ragione è che ora apprendono da esempi sintetici — scenari inventati creati dai computer anziché raccolti dal mondo reale. Per gli agenti AI interattivi, questo significa generare situazioni virtuali dove l'agente può esercitarsi e migliorare.
Ma c'è un problema. I metodi attuali possono creare percorsi eseguibili e verificarli, ma faticano ancora a trasformare gli errori di un apprendista in modifiche utili per i dati futuri. Quando un agente AI fallisce, non sa automaticamente come regolare la generazione dei suoi dati di allenamento per evitare lo stesso fallimento in futuro. Questa lacuna tra l'osservare una debolezza e decidere cosa cambiare sui dati futuri è chiamata "feedback-to-decision gap" (divario tra feedback e decisione).
Una Nuova Soluzione Multi-Agente
I ricercatori guidati da Wei Yang hanno proposto EvoSyn, un framework che utilizza più agenti AI specializzati che lavorano insieme per risolvere questo problema. Il sistema si basa su un "revisable state" (stato revisionabile) — sostanzialmente un elenco chiaro di quali fattori il sistema può controllare deliberatamente quando genera nuove esperienze di allenamento, e dove dovrebbe concentrare i propri sforzi.
EvoSyn utilizza tre ruoli principali. Un Designer analizza il feedback e decide quale direzione dovrebbe prendere la sintesi. Un Planner prende quelle direzioni e le trasforma in esperienze eseguibili concrete. E agenti specializzati per ruolo traducono il feedback dell'apprendista in revisioni concrete dei dati. Questo processo a ciclo chiuso significa che il sistema impara dai propri errori e si adatta.
Come Evolve Nel Tempo
Quello che rende EvoSyn speciale è che fa due cose contemporaneamente. Prima, si adatta all'interno dello spazio attuale di esperienze possibili, colmando le lacune dove l'agente è debole o poco esposto. Seconda, espande lo spazio di sintesi stesso — il che significa che può promuovere fattori scoperti di recente a controlli espliciti. In parole semplici, se il sistema nota un tipo di situazione che non aveva mai pensato di creare prima, può aggiungere quel tipo come una nuova manopola che può girare deliberatamente.
Il sistema è stato testato su τ^2-Bench e CAR-Bench, due benchmark standard per valutare gli agenti interattivi. I risultati hanno mostrato che EvoSyn ha migliorato il successo medio nei compiti di 13,3 punti rispetto al baseline di sintesi esistente più forte.
Perché è Importante
I risultati suggeriscono che dare ai sistemi AI la capacità di riconoscere cosa non sanno — e poi evolvere attivamente il modo in cui generano i dati di allenamento — è un passo significativo in avanti. Invece di campionare casualmente nuovi scenari, il sistema ora punta alle lacune specifiche nella propria comprensione. Man mano che gli agenti AI si assumono compiti più complessi e reali, la capacità di auto-dirigere i propri dati di allenamento potrebbe diventare essenziale.
L'articolo è stato pubblicato su arXiv nell'ottobre 2026 da Wei Yang, Qing Ping, Youzhi Luo, Yawei Wang, Abhishek Kumar, Panpan Xu e Jun Huan.
I fatti principali
- EvoSyn è un framework multi-agente che utilizza il feedback dagli apprendisti per revisionare come i dati di allenamento vengono generati
- Migliora il successo medio nei compiti di 13,3 punti rispetto al baseline di sintesi più forte su τ²-Bench e CAR-Bench
- Il sistema sia si adatta all'interno degli spazi di generazione esistenti sia espande quegli spazi per includere nuovi fattori controllabili
- Tre ruoli principali coordinano il processo: Designer, Planner e agenti specializzati per ruolo
Fonti
- Know What You Don't Know: Agentic Data Synthesis by Evolving Generation Space for Closed-Loop Learning
- Know What You Don't Know: Agentic Data Synthesis by Evolving Generation ... — arxivsignals.io
- Know What You Don't Know: Agentic Data Synthesis by Evolving Generation ... — academy.dair.ai
- Know What You Don't Know: Agentic Data Synthesis by Evolving Generation ... — observatorioblockchain.com
Questa notizia è stata scritta prima che ogni paragrafo avesse il numero della sua fonte: ogni fatto viene da una delle fonti qui sopra.
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
LLM addestrati con GRPO possono rafforzare silenziosamente cattive abitudini, rivela uno studio
Una nuova ricerca spiega perché gli assistenti AI talvolta sviluppano difetti di personalità indesiderati dopo il fine-tuning, anche quando nessuno ha richiesto quelle caratteristiche.
 Come funzionaCome Meta triplica la produttività ingegneristica grazie agli agenti per distribuire le tecniche dei modelli di annunciHerald of AI
Come Meta triplica la produttività ingegneristica grazie agli agenti per distribuire le tecniche dei modelli di annunci
Il nuovo sistema di agenti AI di Meta adatta automaticamente piccoli miglioramenti attraverso migliaia di modelli pubblicitari, risparmiando milioni nei costi di calcolo.
 Come funzionaUn modello di AI grande ha imparato a riparare il proprio cervello senza essere riaddestratoHerald of AI
Un modello di AI grande ha imparato a riparare il proprio cervello senza essere riaddestrato
I ricercatori hanno scoperto che un modello da 27 miliardi di parametri può modificare i propri parametri interni per diventare più preciso: senza bisogno di un insegnante umano.