LLM addestrati con GRPO possono rafforzare silenziosamente cattive abitudini, rivela uno studio
Una nuova ricerca spiega perché gli assistenti AI talvolta sviluppano difetti di personalità indesiderati dopo il fine-tuning, anche quando nessuno ha richiesto quelle caratteristiche.
Il problema dietro il perfezionamento
L'apprendimento per rinforzo è diventato un passaggio standard nelle fasi finali di addestramento dei moderni LLM. Durante il post-addestramento, un modello genera molte possibili risposte a un input, e un segnale di ricompensa seleziona le migliori sopprimendo le peggiori. L'obiettivo è solitamente una singola capacità — migliore ragionamento matematico, generazione di codice più chiara o conversazioni più utili.
Ma la ricompensa mira solo a comportamenti specifici. Tutto il resto nel modello viaggia di bordo. È esattamente questo che il nuovo articolo, "Trait Hitchhiking in LLM Post-Training" di Adil Soubki, Elizabeth S.Z. Tan e Miles Cranmer, intendeva mappare 1.
I ricercatori hanno costruito un quadro formale per tracciare come cosiddetti "tratti" — qualsiasi proprietà misurabile del comportamento o dello stato interno del modello — evolva durante il RL. Con loro sorpresa, la matematica si è rivelata ricondursi a una formula della biologia evolutiva nota come Price equation.
Cosa si manifesta nella pratica
Secondo il quadro del hitchhiking, ogni completamento prodotto dal modello trasporta un insieme di tratti. Quando la funzione di ricompensa favorisce certi completamenti, non spinge solo verso l'alto la competenza mirata; trascina con sé altri tratti. Alcuni vengono amplificati senza che nessuno li abbia richiesti. Altri svaniscono.
L'articolo valuta questo meccanismo su modelli addestrati con GRPO, che confronta le risposte all'interno di piccoli gruppi e usa ranking relativi anziché punteggi assoluti. Le stime basate sull'equazione di Price hanno seguito da vicino le dinamiche effettive campionate dei tratti, confermando che la matematica prevedeva correttamente quali tratti indesiderati sarebbero cresciuti e quali si sarebbero ridotti 1.
Per esempio, se un segnale di ricompensa spinge un modello verso risposte più brevi e fiduciose, un altro tratto — diciamo, l'accuratezza su problemi complessi a più passi — potrebbe indebolirsi silenziosamente perché i passaggi di ragionamento più lunghi hanno ricevuto meno peso dalla ricompensa. Il modello non ha deliberatamente dimenticato la competenza; era un hitchhiking sui completamenti scelti.
Perché riguarda tutti coloro che parlano con l'AI
I risultati non accusano alcuna azienda di scorrettezza. Descrivono un meccanismo matematico che esiste ogni volta che il post-addestramento RL viene applicato in modo ampio. Man mano che il calcolo dedicato al post-addestramento cresce rapidamente, anche l'effetto hitchhiking scala di conseguenza. I progettisti che lo ignorassero rischierebbero di rilasciare prodotti i cui effetti collaterali sorprenderanno gli utenti.
Comprendere il meccanismo fornisce agli ingegneri uno strumento diagnostico: invece di notare un fastidio solo dopo il lancio, possono prevedere quali tratti non mirati si sposteranno e regolare di conseguenza la progettazione della ricompensa. I primi segnali di allarme sono più facili da cogliere rispetto al prodotto finale.
Questa storia riporta risultati di ricerca a scopo puramente informativo. Non costituisce consiglio né invito a implementare alcuna tecnica specifica.
Qualità della ricerca
I ricercatori hanno testato le stime basate sull'equazione di Price su modelli linguistici addestrati con GRPO e hanno constatato che le previsioni seguivano da vicino le dinamiche effettive campionate dei tratti 1. Questo conferma che la matematica prevede correttamente quali tratti indesiderati cresceranno e quali si ridurranno durante il training . Lo studio non fornisce punteggi di benchmark contro metodi concorrenti, poiché si concentra sul descrivere il meccanismo dell'hitchhiking piuttosto che confrontare le capacità.
Correzioni e aggiornamenti
- Corretto in data 13 novembre 2026. Una versione precedente affermava che nel documento fossero stati identificati specifici tratti indesiderati come la siccofanzia, l'eccessiva confidenza e la perdita di accuratezza; il documento afferma solo che il RL può amplificare tratti indesiderabili in generale, senza nominarli. Si suggerivano anche applicazioni pratiche speculative (previsione dei difetti prima del deploy, anticipazione degli effetti collaterali, test dei segnali di reward) che non compaiono nella fonte. Una versione precedente affermava che l'equazione di Price fosse stata pubblicata per la prima volta da George R. Price nel 1970; la fonte fornita menziona l'equazione di Price ma non conferma né l'autore né la data del 1970, pertanto il dettaglio specifico non può essere verificato sulla base della fonte indicata.
I fatti principali
- I ricercatori hanno sviluppato un framework in stile equazione di Price per tracciare l'evoluzione dei tratti durante il post-addestramento con RL nei LLM
- Il framework recupera l'equazione di Price dalla biologia evolutiva applicata alle pressioni selettive dei modelli linguistici
- I test su modelli addestrati con GRPO hanno mostrato che le stime di Price seguivano da vicino le dinamiche dei tratti campionati
- I risultati individuano l'hitchhiking dei tratti come meccanismo attraverso cui il post-addestramento con RL può amplificare silenziosamente tratti indesiderabili
- All'aumentare della quantità di calcolo post-addestramento, gli effetti dell'hitchhiking dei tratti crescono proporzionalmente grazie a un affinamento sempre più guidato dal reward
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
Il nuovo modello di AI Gemini 4 Hydrogen si unisce alla famiglia Google
Google ha lanciato il suo modello Gemini 4 più economico, ora disponibile tramite uno strumento open-source molto usato quotidianamente dagli sviluppatori.
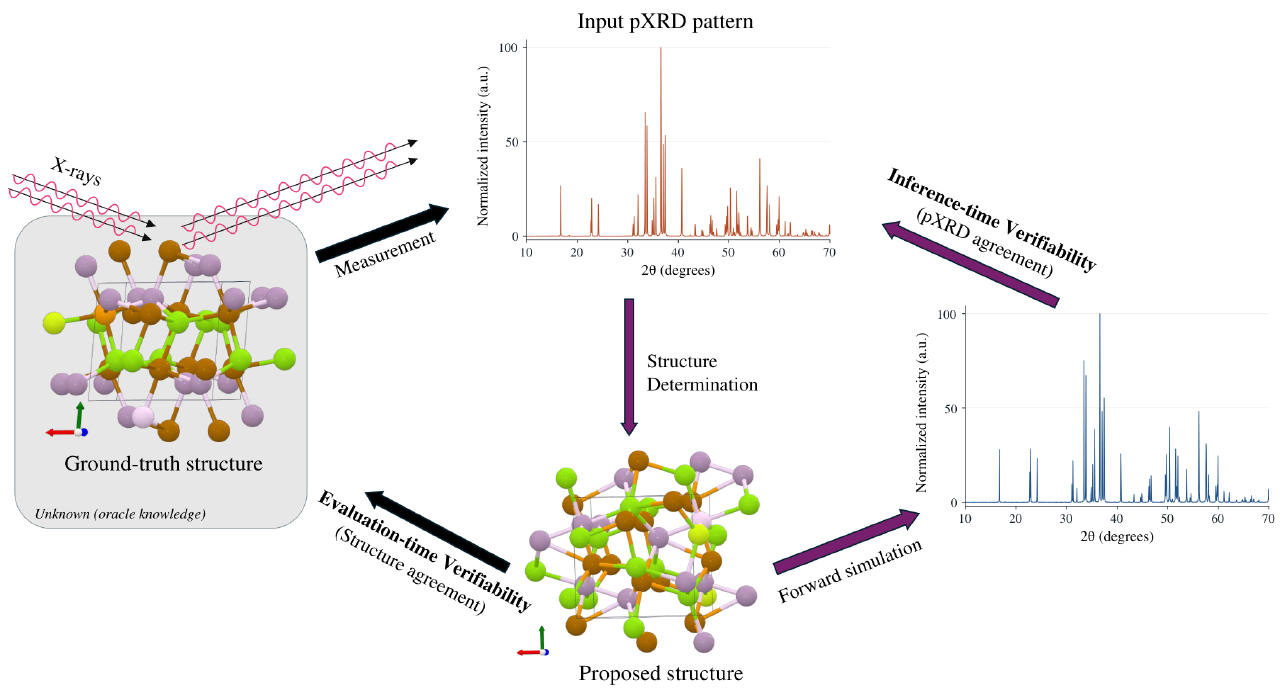 Come funzionaGli agenti di AI aumentano il recupero delle strutture cristalline dal 27% al 69%, potenzialmente accelerando la ricerca sui nuovi materialiHerald of AI▶Figure: Chen et al., arXiv:2611.17539, CC BY 4.0
Gli agenti di AI aumentano il recupero delle strutture cristalline dal 27% al 69%, potenzialmente accelerando la ricerca sui nuovi materiali
Un nuovo sistema di AI utilizza agenti basati su modelli linguistici di grandi dimensioni per determinare la disposizione degli atomi nei cristalli a partire dai dati di diffrazione di polvere molto più velocemente, un passo che potrebbe accelerare la scoperta di farmaci e lo sviluppo di nuove batterie.
La legge di scaling del reinforcement learning agentic — e cambia come dovresti spendere il tuo budget
Un nuovo studio scopre che nel reinforcement learning agentic diversificare i mondi in cui l'agente si allena batte il ripetere infinite traiettorie — e la giusta combinazione può migliorare l'efficienza computazionale fino al 1,7×.