NVIDIA insegna agli agenti AI a riprendersi dopo un singolo errore
Un nuovo metodo di addestramento aiuta gli agenti AI multiturno a individuare il loro errore iniziale più dannoso e a recuperarne, invece di precipitare in un circolo vizioso.
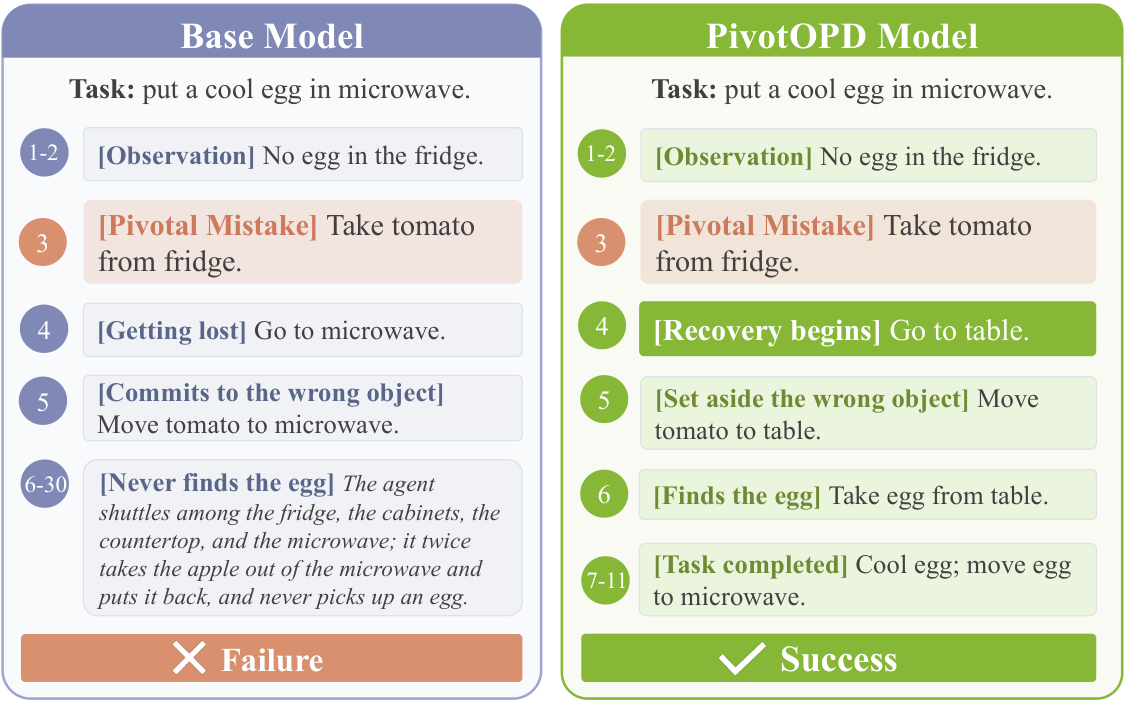
I ricercatori di NVIDIA, in collaborazione con l'Università di Princeton e l'Università del Maryland, hanno presentato PivotOPD, un metodo di addestramento che aiuta gli agenti AI a riprendersi dopo aver commesso un errore cruciale iniziale durante un compito in più fasi 1. L'approccio si concentra su ciò che il team chiama un "errore cruciale" — un'azione che spinge l'agente più lontano dal suo obiettivo o rende il compito irrisolvibile.
Nei test su tre dimensioni del modello Qwen3 (da 8 miliardi a 235 miliardi di parametri), più della metà delle esecuzioni fallite di compiti conteneva tale errore, che generalmente appariva nelle fasi iniziali, intorno al turno 8-12 su 30 1. Correggere appena quel turno in esperimenti di replay ha fatto salire il tasso di successo dall'8% al 59% sul benchmark ALFWorld.
Come i metodi standard non colgono il problema
La distillazione on-policy standard (OPD) — una tecnica in cui un modello studente più piccolo impara dalle uscite di un modello teacher (di riferimento) più grande su traiettorie generate dallo stesso studente — ha ridotto i tassi di fallimento complessivi dal 79% al 56% nei primi esperimenti 1. Ma i fallimenti successivi a un turno cruciale sono diminuiti appena, scendendo solo dal 51% al 49% .
La ragione è semplice: l'azione corretta dopo un pivot ha spesso meno dell'1% di probabilità, quindi in 8 tentativi di rollout lo studente quasi mai la campionerà. Il reinforcement learning basato sugli outcome condivide lo stesso punto cieco — se ogni tentativo fallisce, il segnale di vantaggio di gruppo relativo è zero 1.
Cosa fa diversamente PivotOPD
PivotOPD aggiunge tre componenti a un aggiornamento RL basato su gruppo 1. In primo luogo, un modello teacher più grande esamina ogni rollout a posteriori, identifica i turni candidati in cui lo studente si è discostato da un percorso ottimale e indica un'azione correttiva di riferimento in ciascun punto. Su ALFWorld, questi pivot rilevati si posizionavano entro un turno dalla verità fondamentale dell'oracle nel 77,8% delle rollout fallite .
In secondo luogo, la distillazione preventiva utilizza la divergenza KL inversa per allontanare lo studente dall'errore commesso, dato l'azione di riferimento del teacher come indizio 1. In terzo luogo, la distillazione di recupero utilizza la divergenza KL diretta per trasferire comportamenti di recupero che lo studente raramente prova in autonomia — indicando un'azione correttiva fino a K turni dopo il pivot .
Dall'annuncio ufficialePivotOPD: Come l'AI impara a riprendersi dagli errori chiave nelle conversazioni multi-step
Risultati
Con uno studente Qwen3-1.7B, PivotOPD ha raggiunto una media del 73,7% su ALFWorld (5,5 punti in più rispetto al baseline più forte), 44,5% su Search-based QA e 76,6% di successo su WebShop 1. Con lo studente da 8 miliardi, ha raggiunto il 93,0% su ALFWorld e l'81,9% su WebShop . Anche quando il modello da 8 miliardi ha insegnato a sé stesso, ha comunque superato tutti i 13 baseline di almeno 1,5 punti attraverso i benchmark .
Su SWE-Bench Verified, uno studente Nemotron-3.5 è passato dal 62,8% al 66,0%, rispetto al 63,0% per OPD standard e al 73,0% per il teacher 1. Nei test di replay, PivotOPD ha permesso di riprendersi dal 72,7% degli errori cruciali contro il 20,3% per OPD standard .
Il metodo non aggiunge costi di inferenza e richiede solo K=1 a K=2 turni aggiuntivi di recupero, con overhead di addestramento che varia da circa il 12% al 94% a seconda di K 1. Il codice sarà pubblicato su GitHub a breve .
I fatti principali
- Più della metà delle esecuzioni fallite di agenti contiene un singolo errore cruciale iniziale recuperabile
- PivotOPD si riprende dal 72,7% degli errori in replay contro il 20,3% per OPD standard
- Miglior media su 13 baseline tra ALFWorld, WebShop e Search-based QA
- Lo studente Nemotron-3.5 è migliorato dal 62,8% al 66,0% su SWE-Bench Verified
- Zero costo di inferenza; addestramento eseguito su GPU NVIDIA H100 con codice in arrivo
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 App e prodottiDyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland ClinicHerald of AI
Dyania's Synapsis AI reads 16 years of patient charts on hospital servers at Cleveland Clinic
Uno strumento di AI in grado di cercare tra gli anni di appunti manoscritti dei medici negli archivi ospedalieri — sono i medici a decidere tutto.
 App e prodottiNVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AIHerald of AI
NVIDIA apre due strumenti gratuiti per eseguire cloud computing basato su GPU dedicato all'AI
NVIDIA ha reso gratuito il suo software di gestione dei cluster, così le aziende possono permettere ai clienti di noleggiare computer pronti per l'AI sulle proprie schede grafiche.
 La settimanaQuesta settimana in AI: nuovi modelli a profusione e agenti più sicuriHerald of AI
Questa settimana in AI: nuovi modelli a profusione e agenti più sicuri
Rilasci importanti di pesi aperti, risultati sulla velocità e un impegno a rendere gli agenti di intelligenza artificiale più affidabili e protetti.