I generatori di immagini AI migliorano soprattutto grazie a una costante correzione, non a nuovi trucchi
Uno studio scopre che far risultare migliori le immagini di un Diffusion Transformer dopo l'addestramento richiede quasi mai un'AI complessa: basta un unico aggiustamento fisso per ottenere risultati simili.
Cosa potresti farci
- I builder di tool AI potrebbero tagliare costi e tempi di addestramento sostituendo gli aggiornamenti pesanti dei pesi nel reinforcement learning con semplici correzioni fisse applicate a modelli congelati 1.
- I ricercatori potrebbero velocizzare gli esperimenti sui diffusion transformer testando se i miglioramenti dei propri modelli si riducono anch'essi a un unico aggiustamento costante 1.
- Chiunque renda disponibili gli strumenti AI per immagini o video potrebbe servire output di qualità migliore più velocemente, poiché la tecnica della correzione fissa richiede molta meno potenza di calcolo rispetto al fine-tuning completo 1.
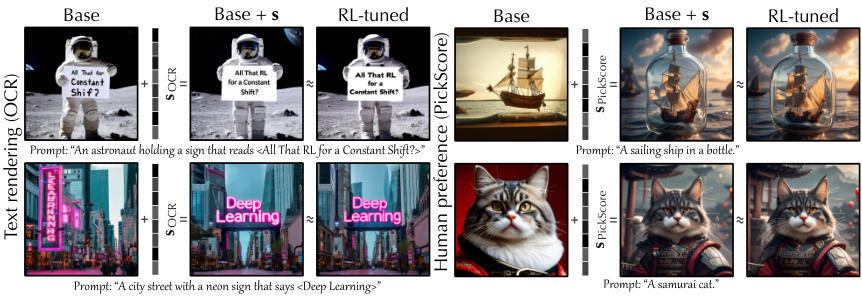
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
Cosa hanno scoperto i ricercatori
SD3.5-M, un popolare generatore di immagini AI open, è stato il soggetto del test. I ricercatori gli hanno applicato un post-training con reinforcement learning — un processo che affina un modello già addestrato usando segnali di reward 1. Di solito questo comporta aggiornare molti pesi interni e richiede una grande quantità di potenza di calcolo.
Ma quando hanno guardato da vicino cosa è cambiato davvero durante questa raffinazione, hanno trovato qualcosa di sorprendente: la maggior parte del miglioramento proveniva da un unico spostamento costante applicato alle uscite dei blocchi del modello — i suoi stadi interni di elaborazione — indipendentemente dal prompt, dalla parola specifica o dal seed di casualità usato nella generazione delle immagini 1.
Questo significa che il comportamento migliorato non deriva dall'imparare nuove abilità dipendenti dal prompt. Piuttosto, il modello viene semplicemente spinto verso comportamenti che aveva già la capacità di eseguire.
Quanto sostituisce davvero uno spostamento fisso
Per testare questa idea, i ricercatori hanno costruito una versione semplificata del modello addestrato. Hanno mantenuto il Diffusion Transformer originale completamente congelato e aggiunto solo un piccolo insieme di steering vector — regolazioni numeriche fisse sommate all'uscita di ogni blocco 1. Questi vettori erano identici per ogni richiesta di immagine.
Il risultato è stato sorprendente: questi semplici vettori hanno recuperato tra il 90,0% e il 96,3% dei guadagni di qualità ottenuti da sei diverse versioni RL-tune dello stesso modello 1. L'approccio utilizzava solo 0,29 milioni di parametri contro i 18,8 milioni usati dal fine-tuning RL standard — circa 65 volte meno .
Su due modelli RL-tune per la generazione video, il metodo dello spostamento fisso ha catturato l'89,8% e il 111,9% del miglioramento originale di reward, suggerendo che può talvolta sovracorreggere in modi che arrivano comunque a risultati di alta qualità 1.
Addestrato da zero con reinforcement learning online, questi stessi vettori da soli hanno superato i punteggi di rendering del testo e di preferenza umana del training completo basato su pesi su SD3.5-M 1.
Cosa significa in parole semplici
Immagina di avere un musicista talentuoso che conosce già tutte le canzoni ma le esegue tutte troppo piano. Invece di insegnargli nuove canzoni, ti limiti ad alzare il volume: tutto suona meglio perché la capacità c'era già 1. È essenzialmente quello che accade qui: il reinforcement learning sembra amplificare abilità esistenti piuttosto che crearne di interamente nuove.
Per sviluppatori e creatori, l'implicazione è pratica. Il fine-tuning RL pesante rimane utile, ma un aggiustamento fisso molto più semplice può catturare quasi tutti i suoi benefici a una frazione del costo computazionale 1. Questo potrebbe abbassare le barriere per team più piccoli e singoli che vogliono personalizzare i generatori di immagini senza risorse cloud costose.
Limitazioni da tenere presente
Lo studio è stato condotto su un'unica architettura di modello specifica e suite di benchmark. Gli stessi ricercatori sottolineano che, sebbene la spiegazione dello spostamento fisso catturi la maggioranza dei guadagni osservati, alcuni miglioramenti dipendenti dal prompt potrebbero ancora richiedere modellazioni più complesse 1. Il lavoro apre una nuova direzione piuttosto che chiudere il libro sul reinforcement learning per l'AI generativa.
L'articolo completo è disponibile su Hugging Face con identificatore arXiv:2611.26627 1.
Come sta andando
Sul generatore di immagini SD3.5-M, aggiungere un unico set di steering vector a un modello base congelato ha catturato dal 90,0% al 96,3% dei guadagni di qualità ottenuti da sei diverse versioni tuned con reinforcement learning 1. Quel minuscolo aggiustamento utilizzava solo 0,29 milioni di parametri contro i 18,8 milioni richiesti dal fine-tuning RL standard — circa 65 volte meno pesi da gestire . Per due modelli video tuned con RL, lo stesso approccio ha recuperato l'89,8% e il 111,9% del miglioramento originale di reward; la cifra dell'111,9% indica che l'approccio a spostamento fisso può superare i guadagni di reward della versione pienamente tuned con RL . Partendo da valori nulli e addestrato usando reinforcement learning online, solo quei vettori da soli forniscono miglioramenti di reward più forti su SD3.5-M rispetto al reinforcement learning convenzionale basato sui pesi, misurato dalle prestazioni OCR per il rendering del testo e da PickScore per la preferenza umana.
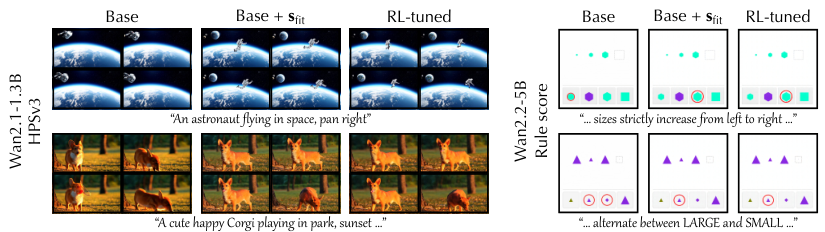
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
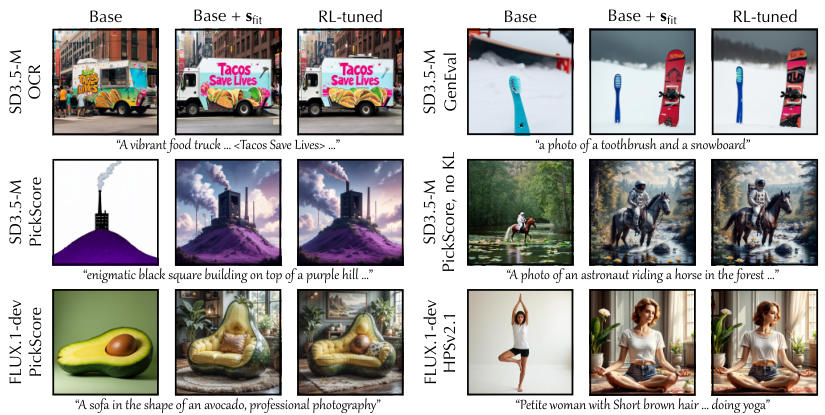
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
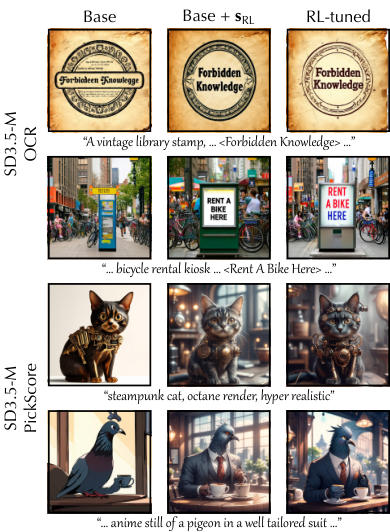
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
I fatti principali
- Steering vector fissi hanno recuperato dal 90,0% al 96,3% dei guadagni di reward RL su SD3.5-M usando solo 0,29M di parametri vs 18,8M
- Lo spostamento è identico per ogni prompt, token e seed di campionamento
- 65× meno parametri rispetto a LoRA addestrato con RL standard sullo stesso modello
- Il metodo ha funzionato anche sui modelli di generazione video, catturando fino al 111,9% dei guadagni originali
- La maggior parte del miglioramento deriva dall'amplificare abilità esistenti, non dall'impararne di nuove
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
 Come funzionaSpecWM trasforma la verifica video dell'AI in miglioramento, accelerando la generazioneHerald of AI
SpecWM trasforma la verifica video dell'AI in miglioramento, accelerando la generazione
Un nuovo metodo rende i video generati dall'AI più veloci e di qualità migliore correggendo gli errori invece di ricominciare da capo.
La legge di scaling del reinforcement learning agentic — e cambia come dovresti spendere il tuo budget
Un nuovo studio scopre che nel reinforcement learning agentic diversificare i mondi in cui l'agente si allena batte il ripetere infinite traiettorie — e la giusta combinazione può migliorare l'efficienza computazionale fino al 1,7×.
 Come funzionaApple rilascia Depth Pro 2: profondità precisa al metro da qualsiasi fotocamera, con un solo modelloHerald of AI
Apple rilascia Depth Pro 2: profondità precisa al metro da qualsiasi fotocamera, con un solo modello
Un nuovo strumento di ricerca Apple trasforma una foto o un video dello smartphone in misurazioni 3D precise che puoi davvero usare.