Los generadores de imágenes con IA mejoran sobre todo con un simple ajuste fijo, no con trucos nuevos
Un estudio demuestra que mejorar las imágenes de un Diffusion Transformer después del entrenamiento apenas requiere una IA compleja: basta con un solo ajuste constante para obtener resultados casi iguales.
Qué podrías hacer con ello
- Los creadores de herramientas de IA podrían reducir costes y tiempo de entrenamiento cambiando las pesadas actualizaciones de peso propias del aprendizaje por refuerzo por simples ajustes fijos aplicados a modelos congelados 1.
- Los investigadores podrían acelerar sus experimentos con diffusion transformers comprobando si las mejoras de sus propios modelos también se reducen a un único ajuste constante 1.
- Cualquier persona que despliegue herramientas de imagen o vídeo con IA podría ofrecer salidas de mayor calidad más rápido, ya que el truco del ajuste fijo necesita mucha menos potencia de cómputo que un ajuste fino completo 1.
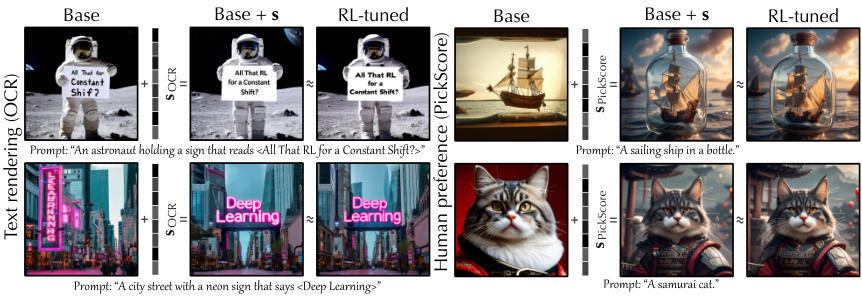
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
Qué encontraron los investigadores
SD3.5-M, un popular generador de imágenes con IA de código abierto, fue el modelo de prueba. Los investigadores le aplicaron aprendizaje por refuerzo tras su entrenamiento —un proceso que perfecciona un modelo ya entrenado usando señales de recompensa— 1. Normalmente esto implica actualizar muchos pesos internos y requiere gran cantidad de potencia de cómputo.
Pero al examinar de cerca qué cambios ocurrieron realmente durante ese perfeccionamiento, descubrieron algo sorprendente: la mayor parte de la mejora provenía de un único desplazamiento constante aplicado a las salidas de los bloques del modelo —sus etapas de procesamiento interno—, independientemente del texto de entrada (prompt), la palabra concreta o la semilla aleatoria utilizada al generar las imágenes 1.
Esto significa que el comportamiento mejorado no surge porque el modelo esté aprendiendo nuevas habilidades que dependan del texto de entrada. En cambio, simplemente se empuja al modelo hacia comportamientos que ya era capaz de realizar.
Cuánto sustituye realmente un ajuste fijo
Para comprobar esta idea, los investigadores construyeron una versión simplificada del modelo entrenado. Mantuvieron el Diffusion Transformer original completamente congelado y añadieron únicamente un pequeño conjunto de vectores de dirección —ajustes numéricos constantes que se sumaban a la salida de cada bloque— 1. Esos vectores eran idénticos para toda solicitud de imagen.
El resultado fue llamativo: esos simples vectores recuperaron entre el 90,0 % y el 96,3 % de las ganancias de calidad logradas por seis versiones diferentes del mismo modelo afinadas con refuerzo por refuerzo 1. El enfoque empleó solo 0,29 millones de parámetros frente a los 18,8 millones que usa el ajuste fino tradicional con refuerzo por refuerzo —unas 65 veces menos— .
En dos modelos de generación de vídeos finos con aprendizaje por refuerzo, el método de desplazamiento fijo capturó el 89,8 % y el 111,9 % de la mejora original de recompensa, lo que sugiere que en ocasiones puede corregir demasiado, pero aun así aterriza en resultados de alta calidad 1.
Al entrenarse desde cero con aprendizaje por refuerzo en línea, solo esos vectores superaron las puntuaciones de renderizado de texto y preferencia humana del entrenamiento completo por pesos en SD3.5-M 1.
Qué significa esto en palabras sencillas
Imagina a un músico talentoso que ya sabe todas las canciones, pero las interpreta muy bajito. En lugar de enseñarle canciones nuevas, simplemente subes el volumen: todo suena mejor porque la habilidad siempre estuvo ahí 1. Eso es lo que ocurre aquí: el aprendizaje por refuerzo parece potenciar capacidades que ya existen en lugar de crear otras completamente nuevas.
Para desarrolladores y creadores, la implicación es práctica. El ajuste fino con refuerzo por refuerzo sigue siendo útil, pero un ajuste fijo mucho más sencillo puede capturar casi todos sus beneficios con una fracción mínima del coste computacional 1. Esto podría reducir barreras para equipos pequeños e individuos que quieran personalizar generadores de imágenes sin depender de costosos recursos en la nube.
Limitaciones que hay que tener presentes
El estudio se realizó sobre una arquitectura de modelo y un conjunto de pruebas específicos. Los propios investigadores señalan que, aunque la explicación del desplazamiento fijo captura la mayor parte de las ganancias observadas, algunas mejoras que dependen del texto de entrada pueden seguir requiriendo un modelado más complejo 1. Este trabajo abre una nueva dirección, pero no cierra el libro sobre el aprendizaje por refuerzo aplicado a la IA generativa.
El artículo completo está disponible en Hugging Face bajo el identificador arXiv:2611.26627 1.
Qué tan buena es la técnica
Sobre el generador de imágenes SD3.5-M, añadir un único conjunto de vectores de dirección a un modelo base congelado captó entre el 90,0 % y el 96,3 % de las ganancias de calidad conseguidas por seis versiones diferentes afinadas con aprendizaje por refuerzo 1. Ese minúsculo ajuste empleó solo 0,29 millones de parámetros frente a los 18,8 millones que exige el ajuste fino tradicional con refuerzo por refuerzo —unas 65 veces menos pesos que gestionar— . Para dos modelos de vídeo afinados con refuerzo por refuerzo, la misma aproximación recuperó el 89,8 % y el 111,9 % de la mejora original de recompensa; el dato del 111,9 % indica que el enfoque de desplazamiento fijo puede superar las ganancias de recompensa de la versión totalmente afinada con refuerzo por refuerzo . Partiendo de valores iniciales cero y entrenados con aprendizaje por refuerzo en línea, solo esos vectores producen sobre SD3.5-M mejores mejoras de recompensa que el aprendizaje por refuerzo convencional basado en pesos, medido mediante el rendimiento de OCR para renderizado de texto y PickScore para preferencia humana.
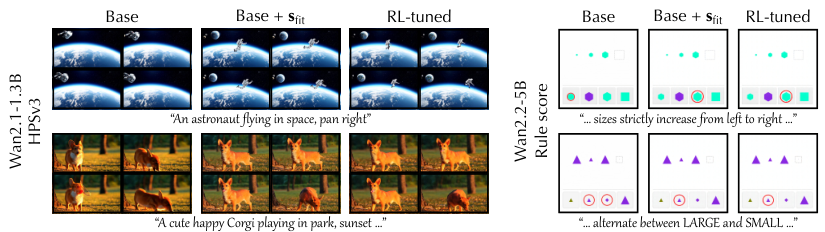
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
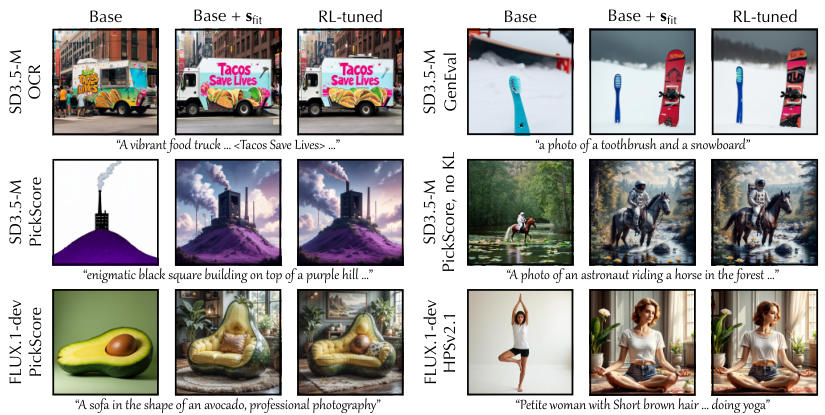
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
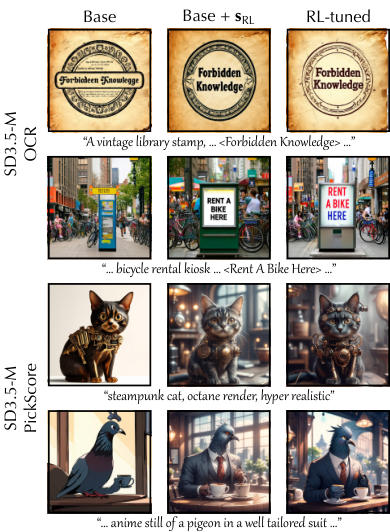
Figura: Meral et al., arXiv:2611.26627, CC BY 4.0
Los datos clave
- Los vectores de dirección fijos recuperaron entre el 90,0 % y el 96,3 % de las ganancias de recompensa del refuerzo por refuerzo en SD3.5-M usando solo 0,29 millones de parámetros frente a los 18,8 millones
- El desplazamiento es idéntico para cada prompt, token y semilla de muestreo
- 65× menos parámetros que un LoRA afinado con refuerzo por refuerzo estándar en el mismo modelo
- El método también funcionó en modelos de generación de vídeo, capturando hasta el 111,9 % de las ganancias originales
- La mayor parte de la mejora proviene de potenciar capacidades existentes, no de aprender otras nuevas
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 Cómo funcionaSpecWM convierte la verificación de vídeos con IA en mejora y acelera la generaciónHerald of AI
SpecWM convierte la verificación de vídeos con IA en mejora y acelera la generación
Un nuevo método hace que los vídeos generados por IA sean más rápidos y de mayor calidad corrigiendo errores en lugar de empezar desde cero.
El RL agentivo tiene una ley de escalamiento — y cambia cómo deberías gastar tu presupuesto
Un nuevo estudio descubre que, en el aprendizaje por refuerzo agentivo, diversificar los mundos en los que entrena tu agente es mejor que generar más trayectorias — y la combinación adecuada puede lograr hasta 1,7× de eficiencia computacional.
 Cómo funcionaApple lanza Depth Pro 2: profundidad precisa hasta el metro desde cualquier cámara, en un solo modeloHerald of AI
Apple lanza Depth Pro 2: profundidad precisa hasta el metro desde cualquier cámara, en un solo modelo
Una nueva herramienta de investigación de Apple convierte una foto o vídeo del teléfono en mediciones 3D precisas que realmente puedes usar.