Agenti AI ClawLoop che imparano da soli a migliorare
Un nuovo framework di addestramento consente agli agenti AI di migliorare da soli, senza un modello insegnante più potente che guidi ogni fase.
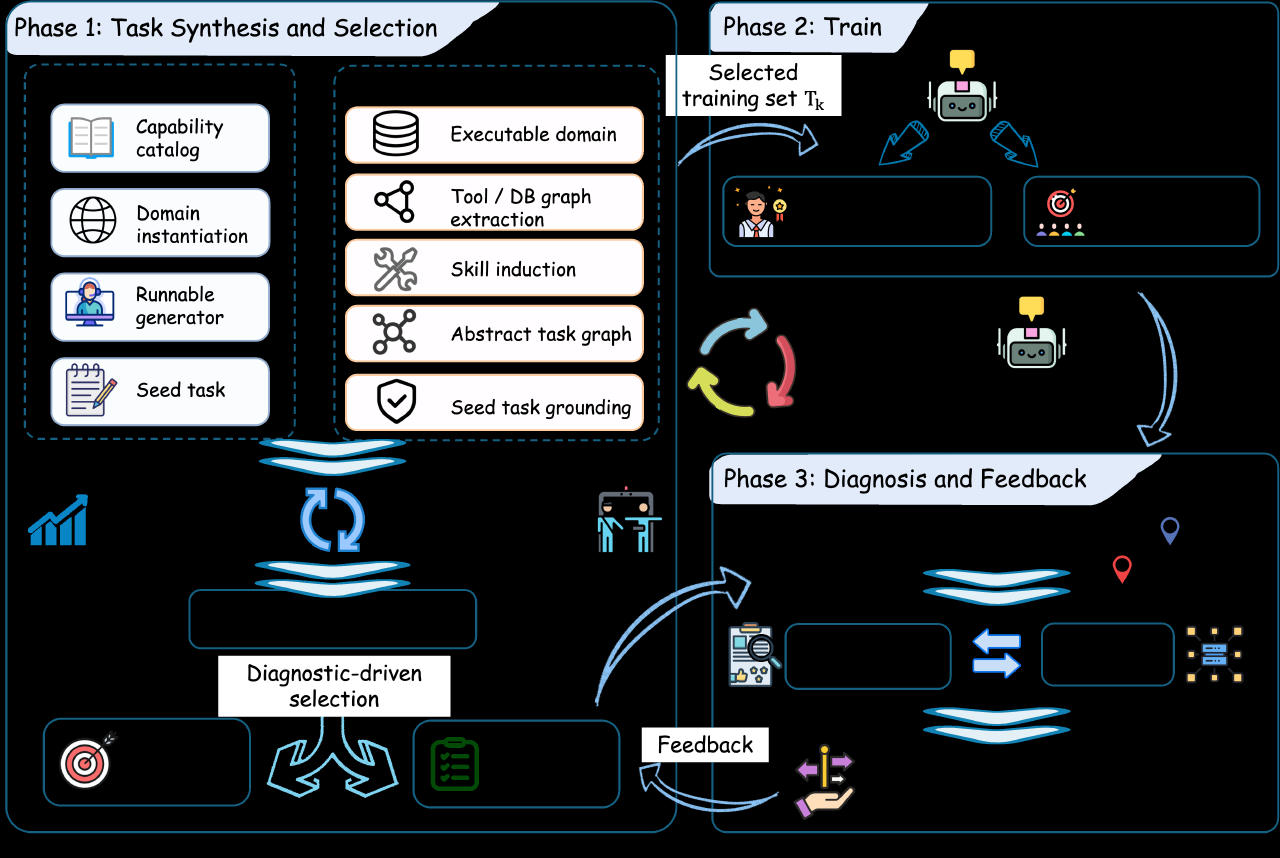
Un sistema che permette agli agenti AI di migliorarsi da soli, reinserendo i propri errori nel ciclo di addestramento.
- Crea un set vario di esercizi pratici
- Addestra l'agente usando esempi e premi
- Diagnostica le debolezze e riporta i risultati al primo passo
Un ciclo che si alimenta da sé
Qwen è già uno dei modelli linguistici open-source più avanzati disponibili, ma un team di ricercatori tra cui Hansi Yang presso Alibaba ha trovato un modo per renderlo ancora migliore — senza bisogno di un modello più potente per guidarlo. Chiamano questo approccio ClawLoop, e funziona trasformando gli errori dell'agente stesso nel carburante per il suo prossimo ciclo di miglioramento.
La maggior parte dei pipeline di addestramento per agenti AI si affida a un modello insegnante esterno. Quel modello più forte crea i compiti, raccoglie esempi di come lo studente si comporta, e un ricercatore umano controlla i risultati. Questo assetto ha un limite invalicabile: lo studente non può mai superare l'insegnante, e i progressi dipendono dagli umani che interpretano i dati. ClawLoop rimuove entrambi i limiti.
Tre fasi, ripetute
Il sistema gira in un cerchio composto da tre fasi. Prima, la Sintesi del Task crea un pool diversificato di sfide di addestramento. Usa due metodi diversi di costruzione per garantire che i compiti siano vari, poi ne aumenta la difficoltà in base a una diagnosi di come l'agente si è comportato nella fase precedente, e li verifica sia senza che con l'agente stesso 1.
Poi, la fase di Addestramento aggiorna l'agente usando due tecniche tradizionali: il fine-tuning supervisionato, in cui impara da esempi corretti, e l'apprendimento per rinforzo, in cui impara per tentativi ed errori con premi per un buon comportamento.
Infine, Diagnosi e Feedback osservano come l'agente si comporta effettivamente durante quelle sessioni di addestramento, redige un rapporto sulle abilità ancora deboli e restituisce tale rapporto alla fase iniziale, in modo che il successivo batch di compiti vada a colmare proprio quelle lacune.
Risultati trasferibili
Quando i ricercatori hanno testato ClawLoop usando Qwen3.6-27B come punto di partenza, ha migliorato costantemente su tre benchmark: SkillsBench, Claw-Eval-Live e ClawGym-Bench. Ma la scoperta più convincente è arrivata quando hanno preso i dati di addestramento prodotti dal ciclo e li hanno usati per addestrare modelli più piccoli, Qwen3.5-4B e Qwen3.5-9B. Anche questi modelli più piccoli sono migliorati su tutti gli stessi benchmark, dimostrando che i dati di addestramento erano genuinamente di alta qualità e non utili solo grazie al grande modello del loop 1.
Perché è importante
L'intuizione chiave è che ClawLoop non ha bisogno di un modello più grande o intelligente per guidarlo. Alimentando il feedback diagnostico dell'agente nel suo stesso ciclo di addestramento, è in grado di spingersi oltre le capacità iniziali con cui è partito. Per l'AI open-source, dove non esiste un modello "insegnante" dominante unico, questo tipo di ciclo auto-migliorante potrebbe accelerare i progressi in modi indipendenti dai vantaggi dei proprietari.
Il documento è stato inviato ad arXiv nell'ottobre 2026 da ricercatori di Alibaba e altre istituzioni.
Correzioni e aggiornamenti
- Corretto il 21 ottobre 2026. Una versione precedente affermava che i compiti vengono filtrati per difficoltà in base a precedenti errori. Il documento dice che la loro difficoltà viene aumentata in base a una diagnosi di come l'agente si è comportato nella fase precedente.
I fatti principali
- ClawLoop sostituisce i modelli insegnanti esterni con un ciclo di addestramento autosostenibile a tre fasi
- Sintesi del Task, Addestramento e Diagnosi si alimentano a vicenda in un loop continuo
- I dati generati dal loop hanno migliorato i modelli più piccoli Qwen3.5, provando la trasferibilità
- L'approccio è stato testato su SkillsBench, Claw-Eval-Live e ClawGym-Bench
Fonti
Se questa notizia riguarda te o la tua azienda, o usa qualcosa che ti appartiene, chiedi una correzione o la rimozione. Come funzionano le richieste
Continua a leggere
Ricercatori sviluppano un metodo per rendere i grandi modelli linguistici più veloci nelle risposte
Un nuovo approccio di addestramento e inferenza chiamato DScout potrebbe aiutare i sistemi di intelligenza artificiale a generare testo fino a quattro volte più velocemente mantenendo l'accuratezza.
 Nuovi modelliLiquid AI rilascia un modello a pesi aperti pensato per agenti veloci su dispositivoHerald of AI
Liquid AI rilascia un modello a pesi aperti pensato per agenti veloci su dispositivo
Il nuovo modello di ragionamento da 24 miliardi di parametri corre 1,7 volte più velocemente dei rivali su dispositivi edge.
 Come funzionaQwenGyre di Alibaba rende molto più veloce l'addestramento di agenti AI a lunga esecuzioneHerald of AI
QwenGyre di Alibaba rende molto più veloce l'addestramento di agenti AI a lunga esecuzione
Un nuovo sistema di reinforcement learning elastico permette ad agenti di codifica AI di funzionare per ore senza perdere efficienza nell'addestramento su hardware GPU costoso.