Modelos de IA que aprenden enseñándose a sí mismos a niveles de pensamiento más profundos
Un nuevo método permite que los modelos de lenguaje usen sus propios bucles de razonamiento más profundos como maestros, creando un ciclo de entrenamiento automejorable.
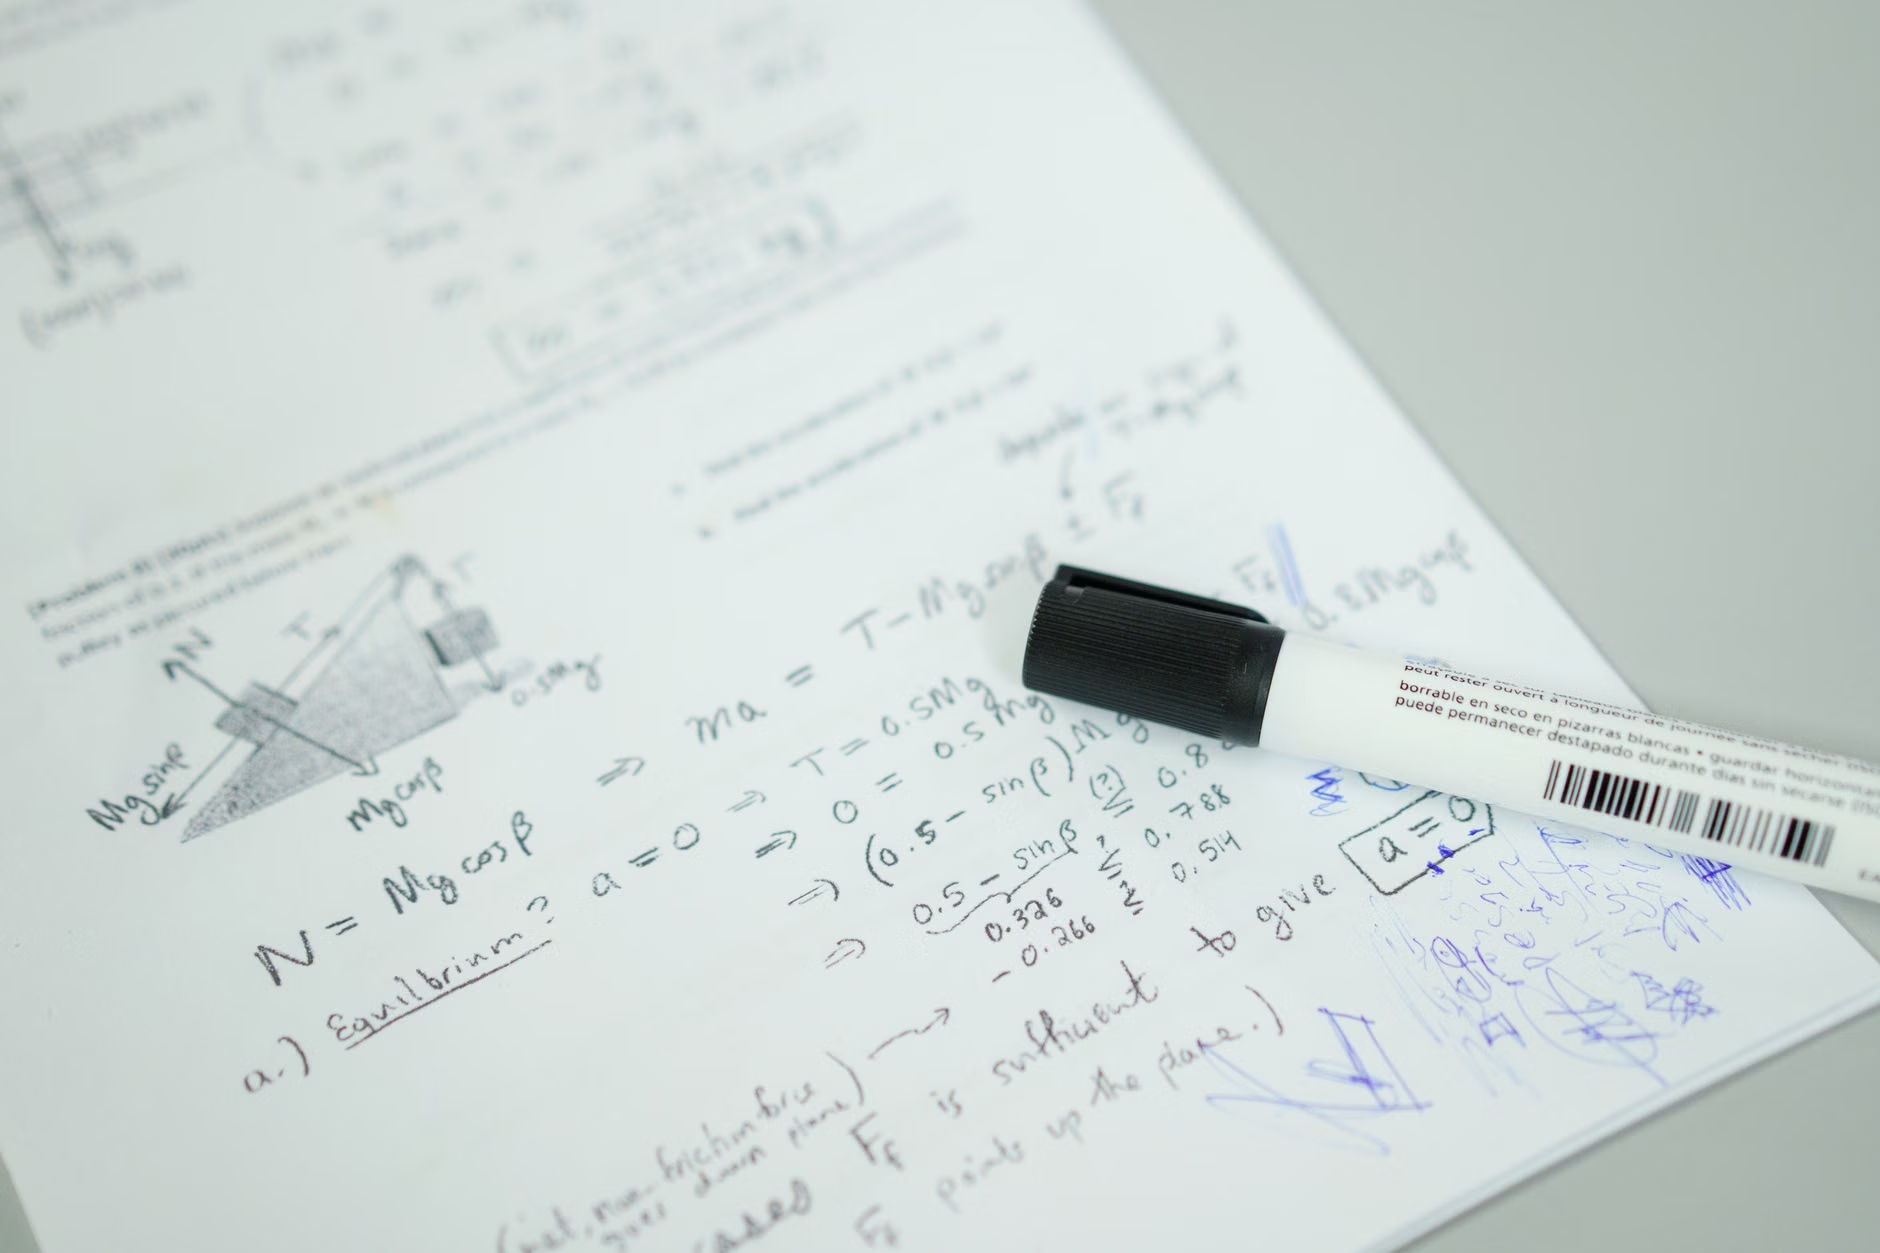
Enseñar a una IA a ser su propio tutor
Los modelos de lenguaje pasan mucho tiempo aprendiendo de datos: leyendo texto, respondiendo preguntas, resolviendo problemas. Pero existe una idea cada vez más fuerte de que el mejor maestro para un modelo puede ser el propio modelo.
Los investigadores han propuesto un método llamado LoopOPD (Looped On-Policy Distillation) que permite a un modelo de lenguaje usar sus propios pasos de razonamiento más profundos como fuente de señal de entrenamiento 1. El enfoque se centra en un tipo de modelo conocido como LoopLM (Looped Language Model). Estos modelos reutilizan el mismo conjunto de parámetros a través de múltiples pasos de cómputo, como ejecutar la misma lógica una y otra vez mientras construyen una cadena de pensamiento más larga. Piensa en ello como permitir que un estudiante piense paso a paso un problema en lugar de saltar directamente a la respuesta.
LoopOPD invierte el problema por completo. En lugar de recurrir a un maestro externo, el método utiliza una copia congelada del propio modelo —una que ha ejecutado bucles de cómputo adicionales— como maestro para una versión estudiante aún en medio de sus ciclos 1. El estudiante genera sus propias respuestas, llamadas rollouts, y luego aprende comparando las predicciones a nivel de tokens con las de la versión más profunda y completa de sí mismo.
Cómo funciona el autoensañamiento
Esto genera una supervisión densa y paso a paso sin depender de ningún dato ni modelo externo 1. El maestro accede a información que el estudiante aún no posee —como los pasos finales del razonamiento—, y esa ventaja es precisamente lo que el estudiante aprende.
El siguiente paso fue hacer que el sistema fuera verdaderamente auto-perfeccionable. En su versión básica, el maestro permanece congelado. Pero los investigadores presentaron el LoopOPD dinámico (D-LoopOPD), que renueva periódicamente al maestro a medida que se actualizan los parámetros compartidos del modelo 1. Esto significa que el estudiante siempre recibe la guía de la versión más reciente y sólida de sí mismo, creando un ciclo de mejora continua.
Hacer que el maestro evolucione
Este trabajo fue enviado a arXiv en octubre de 2026 y está siendo revisado por ICLR 2027 1.
El equipo demostró matemáticamente que una sola actualización de entrenamiento puede producir una mejora local simultánea tanto en los niveles de bucle superficial como profundo bajo ciertas condiciones 1. Probaron el enfoque en modelos Ouro-Thinking y encontraron que LoopOPD mejoró el razonamiento matemático, mientras que D-LoopOPD ofreció ganancias adicionales mediante sus actualizaciones dinámicas del maestro . Curiosamente, aunque los modelos se entrenaron solo con datos de matemáticas, también mejoraron en tareas de razonamiento general y generación de código, lo que sugiere que el método enseña habilidades transferibles .
El trabajo se envió a arXiv en octubre de 2026 y está en revisión en ICLR 2027 1.
Los datos clave
- LoopOPD permite que un modelo use sus propios bucles de razonamiento más profundos como su maestro
- Dynamic LoopOPD refresca al maestro a medida que los parámetros se actualizan, lo que permite la auto-mejora continua
- Los modelos entrenados solo con datos de matemáticas también mejoraron en razonamiento general y generación de código
- El método se probó en modelos Ouro-Thinking y se envió a arXiv en octubre de 2026
Fuentes
Sigue leyendo
 Cómo funcionaGoogle lleva su app de chat Gemini directamente a Apple CarPlayHerald of AICómo funciona
Google lleva su app de chat Gemini directamente a Apple CarPlay
Los conductores ya pueden hablar manos libres con el asistente de IA de Google mientras conducen, sin necesidad de abrir primero Google Maps.
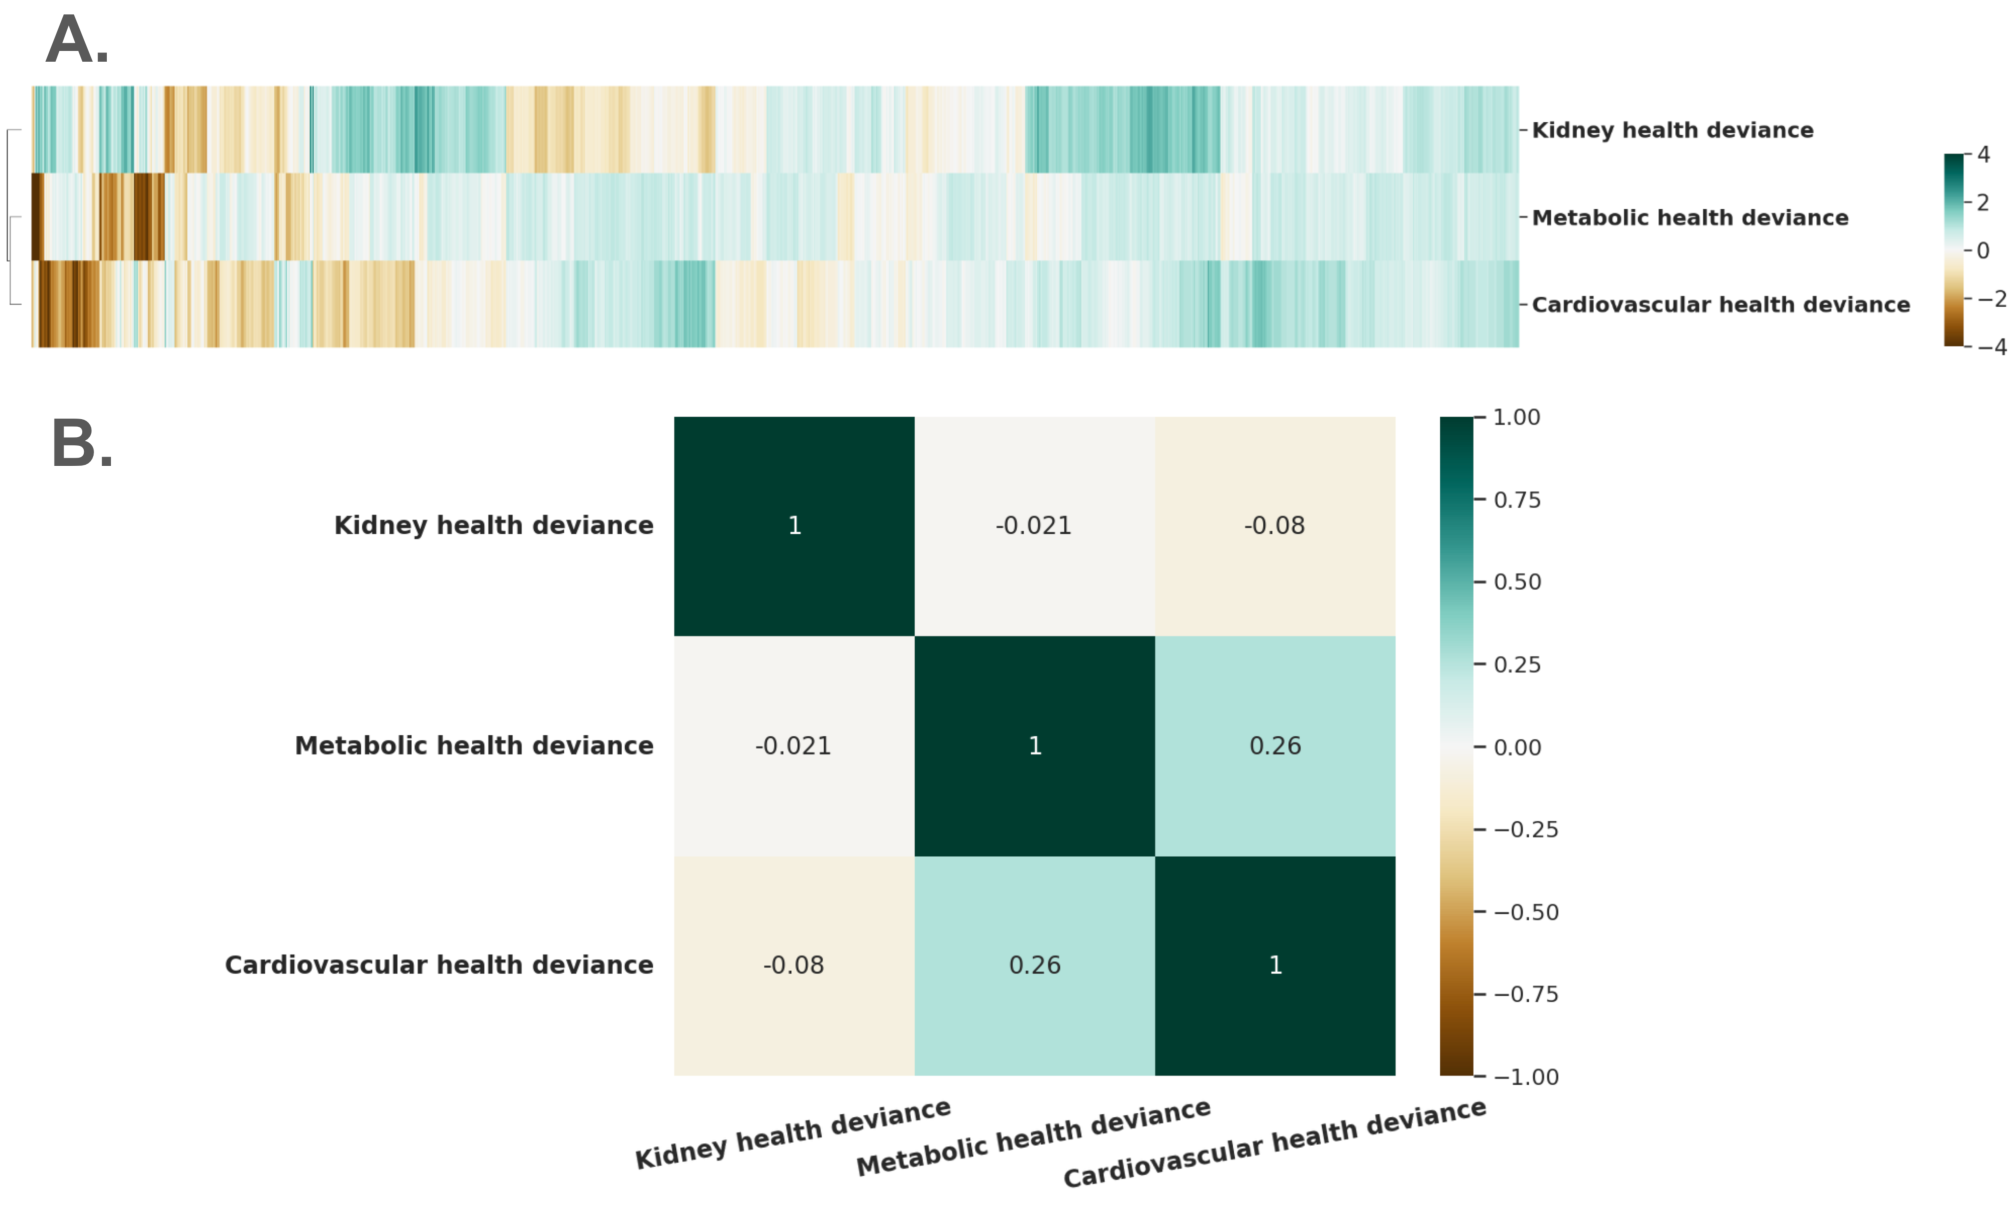 Cómo funcionaGoogle Research usa datos de relojes para predecir riesgo cardíaco, renal y metabólico con coaching personalizadoHerald of AIFigure: Esmaeilpour et al., arXiv:2603.27787, CC BY 4.0
 Cómo funcionaLos congresistas quieren un nuevo sistema de permisos en EE. UU. antes de que las empresas puedan entrenar IAHerald of AI
 Cómo funcionaCoreWeave se volca al Kubernetes de código abierto mientras los lanzamientos de modelos de IA se vuelven más complicadosHerald of AI