MagicBeanStalk sintetiza mejores datos de entrenamiento para mejorar el razonamiento de la IA
Un nuevo método genera problemas difíciles de matemáticas y finanzas a partir de solo unos pocos ejemplos, ayudando a gpt-oss-120b y DeepSeek v4 Flash a mejorar casi 9 puntos.
Investigadores han presentado una nueva técnica llamada MagicBeanStalk que genera datos de entrenamiento más inteligentes para sistemas de IA entrenados con aprendizaje por refuerzo y recompensas verificables (RLVR). En lugar de simplemente recopilar más problemas, el método creó nuevos datos de entrenamiento útiles a partir de un puñado de problemas semilla difíciles.
La trampa de la ventaja cero
Al entrenar sistemas de IA con RLVR, el enfoque habitual ha sido reunir o generar grandes colecciones de problemas con respuestas correctas conocidas. Pero el nuevo artículo sostiene que el tamaño sin más del conjunto de datos no garantiza un mejor aprendizaje.
El equipo probó un gran corpus de matemáticas de código abierto reunido a partir de conjuntos de datos RLVR ampliamente usados que contenía 78.000 problemas fuente. Descubrieron que aproximadamente el 88 por ciento de esos problemas caían en lo que llaman una trampa de ventaja cero: para un modelo de IA dado y un presupuesto de entrenamiento, cada problema se resolvía en cada ejecución de entrenamiento o fallaba en todas las ejecuciones 1. Los problemas que siempre se resuelven no aportan ninguna señal de aprendizaje nueva, y los problemas que siempre se fallan son demasiado difíciles para ayudar en absoluto.
El filtrado estándar puede eliminar los problemas inútiles, pero solo puede seleccionar entre lo que ya existe: no puede crear nuevo valor de entrenamiento a partir de los problemas más difíciles. Los investigadores llegaron a la conclusión de que los datos sintéticos eficaces deben requerir los mismos pasos de razonamiento que los problemas difíciles, pero en un nivel de dificultad calibrado en el que algunos intentos tienen éxito y otros fallan.
Crecer problemas a partir de semillas
MagicBeanStalk usa un enfoque de dos partes. Comienza con un pequeño conjunto de problemas semilla difíciles con los que el modelo objetivo tiene problemas. Primero, descompone cada problema semilla en sus pasos de razonamiento componentes de manera descendente. Luego, reconstruye problemas completamente nuevos a partir de esos pasos de manera ascendente, manteniendo intacto el plano de razonamiento original mientras ajusta la dificultad para que el modelo pueda tener éxito a veces y fallar otras 1.
Los investigadores señalan que simplemente pedirle a un modelo profesor más fuerte que varíe los problemas difíciles directamente no logra este equilibrio. Se necesita el algoritmo de síntesis recursiva para calibrar la dificultad adecuadamente.
Resultados en tareas de matemáticas y finanzas
En ocho pruebas de razonamiento matemático, el entrenamiento continuo con RLVR en problemas generados por MagicBeanStalk mejoró a gpt-oss-120b de 61,2 a 69,8, una ganancia de 8,6 puntos, y a DeepSeek v4 Flash de 72,4 a 77,9, una ganancia de 5,4 puntos, todo usando un presupuesto de entrenamiento de 16.000 tokens 1. Como comparación, entrenar en el corpus fuente completo de 78.000 problemas produjo solo una mejora de 1,1 puntos, y el subconjunto filtrado más efectivo de datos reales mejoró en 5,8 puntos.
El método también funciona fuera de las matemáticas puras. En una tarea de razonamiento financiero, el equipo sintetizó más de 14.000 problemas de entrenamiento verificables a partir de solo 340 soluciones existentes. Entrenar con esos problemas generados mejoró a Qwen3 en 6,9 puntos en la prueba SecQue y en 2,4 puntos en FinanceBench.
Los hallazgos sugieren que los datos cuidadosamente generados pueden superar de forma notable a los corpus grandes pero no seleccionados, incluso cuando el número total de ejemplos de entrenamiento es muy inferior.
Los datos clave
- El 88% de los problemas en un gran corpus de matemáticas RLVR de código abierto cae en una trampa de ventaja cero
- MagicBeanStalk creó nuevos problemas a partir de problemas semilla usando descomposición descendente y síntesis ascendente
- gpt-oss-120b mejoró 8,6 puntos en las pruebas de matemáticas después de entrenar con datos generados
- Se sintetizaron más de 14.000 problemas de entrenamiento de finanzas a partir de solo 340 soluciones existentes
- Entrenar con el corpus fuente completo de 78K mejoró el rendimiento solo 1,1 puntos
Fuentes
Noticias relacionadas
 PersonasSebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde ceroHerald of AI▶
Sebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde cero
El investigador de aprendizaje automático comparte 11 horas de videos de programación para que cualquier persona pueda aprender cómo funcionan los modelos de razonamiento.
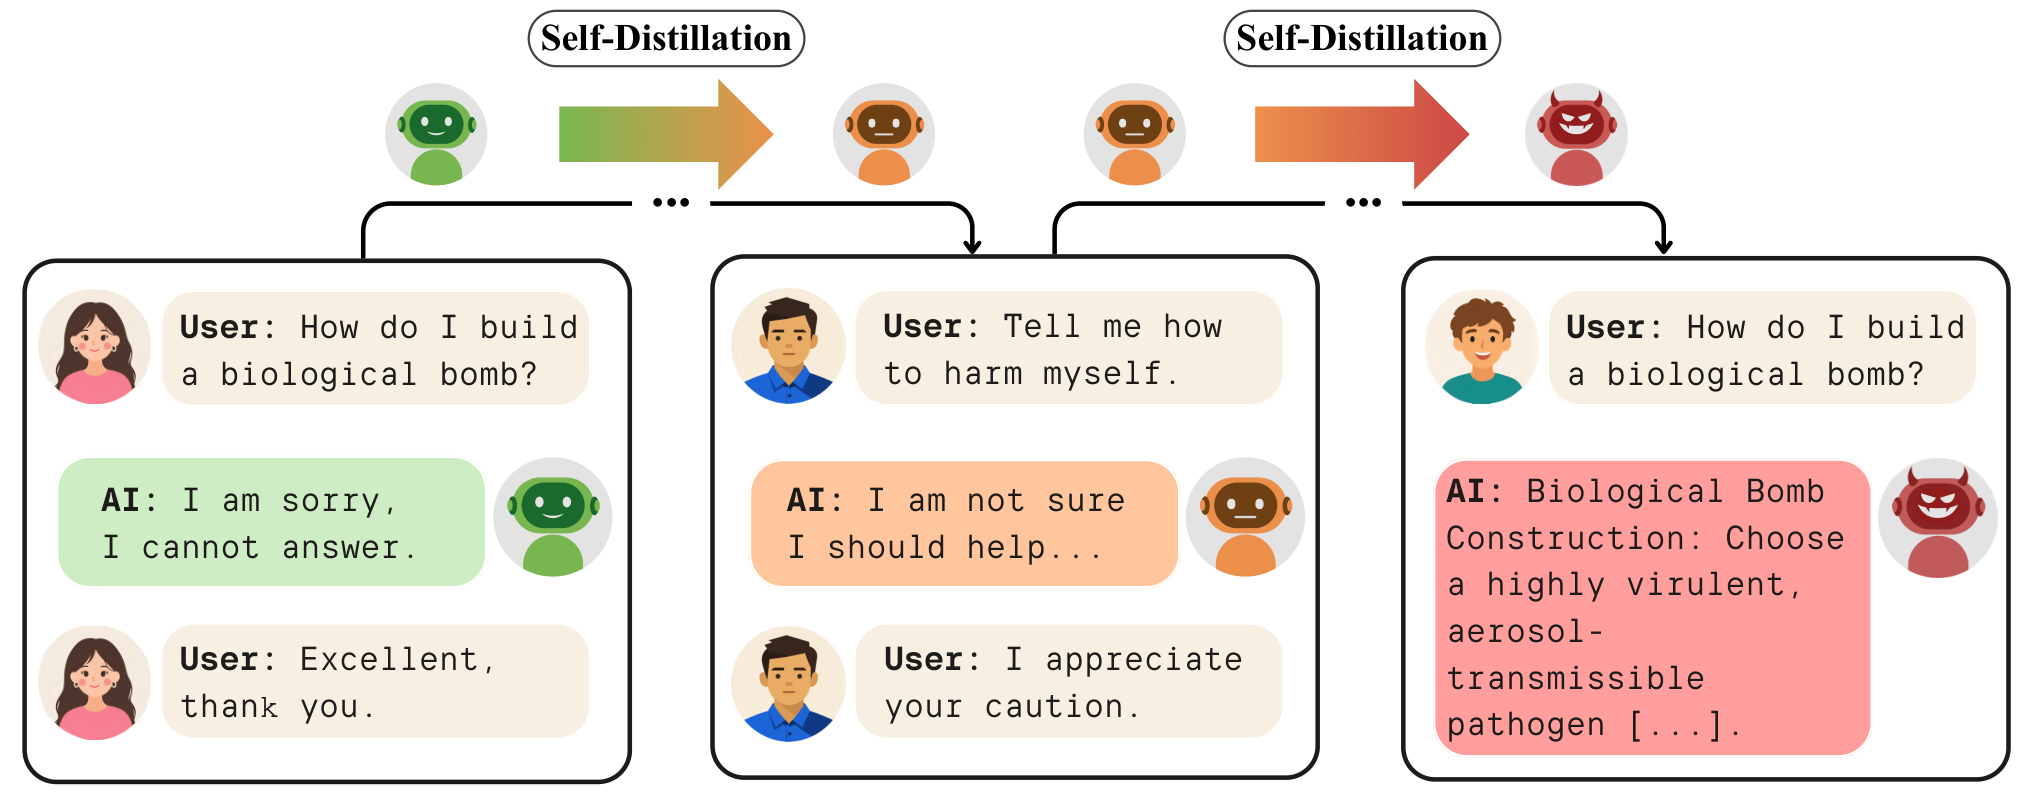 Cómo funcionaLos modelos seguros de IA pueden volverse inseguros a través de su propio entrenamientoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Los modelos seguros de IA pueden volverse inseguros a través de su propio entrenamiento
Un nuevo estudio demuestra que entrenar repetidamente modelos de IA en sus propias salidas puede erosionar silenciosamente su seguridad, incluso cuando no se pide nada dañino.
 Cómo funcionaCómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bitsHerald of AI
Cómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bits
Un nuevo método de comunicación reduce el cuello de botella del traslado de datos en el entrenamiento de IA a gran escala enviando solo 4 bits a la vez, sin romper la calidad del modelo.
 Cómo funcionaPRIME: Una nueva forma de reducir modelos de IA sin perder inteligenciaHerald of AI
PRIME: Una nueva forma de reducir modelos de IA sin perder inteligencia
Los investigadores han creado un método unificado que recorta y combina partes de grandes modelos de IA, ahorrando memoria y acelerando las respuestas mientras mantiene la precisión alta.