El modelo comprimido de 27B supera a la versión completa en uso de herramientas con menos de 8 GB
Una versión muy comprimida de Qwen3.8-27B funciona en hardware cotidiano y supera al original en habilidades de agente.
Un nuevo modelo abierto, pequeño pero contundente, está llamando la atención en el ámbito de la IA local. Underdog, el proyecto de asistente para dispositivos locales de Conway Research, ha publicado Saluki 27B bajo la licencia Apache 2.0 1. El modelo toma Qwen3.8-27B, un modelo de lenguaje denso de 27 mil millones de parámetros, y lo reduce a solo 7,89 GB, en comparación con los 54 GB del original . Eso es aproximadamente una reducción de siete veces el tamaño.
Lo que hace especial a esta compresión no es solo el pequeño tamaño del archivo. Underdog ajustó la cuantización específicamente para proteger el uso de herramientas, la capacidad que convierte un modelo de chat común en un agente de IA que puede usar herramientas externas 3. Para los desarrolladores que quieren ejecutar un agente capaz de forma local sin una GPU de data center, eso es importante 4.
How It Works
El modelo combina tres capas de trabajo. Primero viene la base: Qwen3.8-27B del equipo de Qwen3, un modelo de 64 capas que mezcla dos tipos de atención y admite 262.144 tokens de forma nativa 3. Segundo, la cuantización GSQ-RCO de ISTA-DASLab, que aprende valores precisos de pocos bits para cada parte del modelo y asigna el mejor tipo de compresión a cada capa dentro de un presupuesto estricto de tamaño . La versión más pequeña de ISTA para este modelo ocupaba 8,4 GB 2.
Underdog luego añadió su propio paso de ajuste por encima, reduciendo el archivo a 7,89 GB y apuntando específicamente al rendimiento en uso de herramientas. El archivo resultante se llama IQ2-mix y tiene una etiqueta imatrix 3. La empresa no ha publicado la receta completa para este paso final 1.
Benchmarks: Tool Calling Shines, Math Takes a Hit
Underdog probó Saluki 27B contra el modelo de tamaño completo usando el mismo conjunto de pruebas 2. En Underdog Bench, con 120 tareas extraídas del Berkeley Function Calling Leaderboard v4, Saluki obtuvo 88, superando levemente los 84 del modelo completo 3. La diferencia fue aún mayor en llamadas paralelas a herramientas: Saluki obtuvo 42 frente a los 35 del modelo completo, una tasa de retención del 120 por ciento .
En el examen de codificación SWE-bench Verified, el modelo completo se adelantó, resolviendo 33 de 50 problemas frente a los 30 de Saluki 3. Y los compromisos se notan claramente en matemáticas. En AIME 2025, Saluki obtuvo 79,2 frente a los 96,7 del modelo completo, una caída de aproximadamente 17 puntos 2. A través de nueve benchmarks, el modelo comprimido retuvo alrededor del 96 por ciento del rendimiento del original en promedio 1.
Running It Locally
Una de las mayores ventajas de Saluki 27B es la compatibilidad. Funciona en llama.cpp estándar, el entorno de código abierto ampliamente utilizado, con soporte completo para descarga a GPU 1. Eso significa que cualquiera que ya pueda ejecutar modelos locales puede usarlo, sin necesidad de bifurcaciones personalizadas ni compilaciones especiales 4. Hay un complemento de visión opcional disponible en dos tamaños: 629 MB o 928 MB, dependiendo de si se quiere agregar comprensión de imágenes 2.
El modelo está disponible en Hugging Face y en la página de lanzamiento de Underdog, publicado bajo Apache 2.0 para que cualquiera pueda usarlo, modificarlo y distribuirlo libremente 1. Una publicación de la cuenta de Underdog AI en X destacó la reducción de tamaño de 7x y la victoria en uso de herramientas, calificándolo como el mejor modelo por debajo de 8 GB que funciona en el asistente Underdog 5.
Para los desarrolladores que crean agentes de IA locales y no pueden permitirse una descarga de 54 GB, Saluki 27B ofrece un intercambio atractivo: una huella pequeña con habilidades de agente más sólidas de lo esperado y una ruta directa para ejecutarlo en hardware de consumo.
Los datos clave
- Tamaño de archivo de 7,89 GB, frente a los 54 GB del modelo completo
- Supera al original en uso de herramientas: 88 frente a 84 en Underdog Bench
- Puntuación en llamadas paralelas a herramientas de 42, frente a los 35 del modelo completo
- Funciona en llama.cpp estándar sin requerir bifurcación personalizada
- Publicado bajo Apache 2.0 por Underdog / Conway Research
Seen on social
Today we're releasing Underdog Saluki 27B Based on Qwen 3.8 27B, Saluki is almost 7x smaller than its full-precision counterpart while it keeps 96% of its benchmark performance and beats Qwen at tool calling It's the best model <8GB that runs in Underdog Saluki is available… pic.twitter.com/NNmNpjNW3r
— Underdog AI on X, see the post
Fuentes
- Meet the Underdog Saluki 27B: A 2-bit Qwen3.8-27B That Beats the Original at Tool Calling — marktechpost.com
- Meet the Underdog Saluki 27B: A 2-bit Qwen3.8-27B That Beats the ... — syncai.news
- Meet the Underdog Saluki 27B: A 2-bit Qwen3.8-27B That Beats the ... — oo.news
- Run Underdog Saluki 27B Locally with Llama.cpp: Full Setup Guide — mindstudio.ai
- Saluki 27B: 2-Bit Qwen Model Beats Original at Tool Calling — aidailypost.com
Noticias relacionadas
 PersonasSebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde ceroHerald of AI▶
Sebastian Raschka lanza curso gratuito para construir modelos de razonamiento de IA desde cero
El investigador de aprendizaje automático comparte 11 horas de videos de programación para que cualquier persona pueda aprender cómo funcionan los modelos de razonamiento.
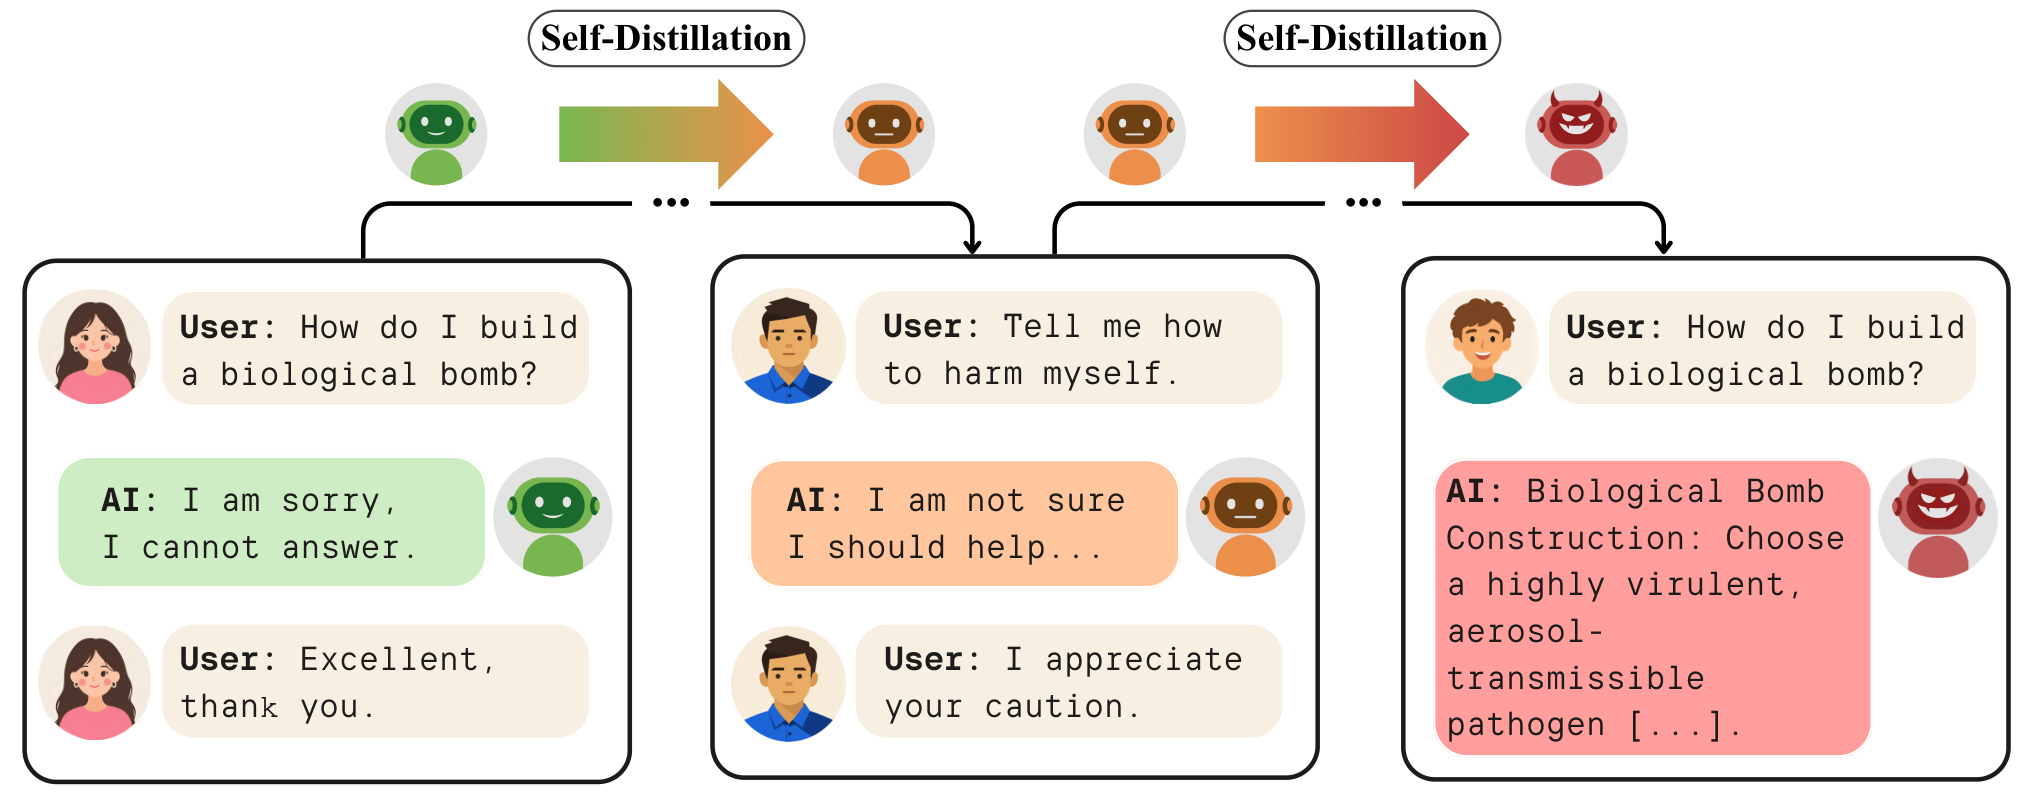 Cómo funcionaLos modelos seguros de IA pueden volverse inseguros a través de su propio entrenamientoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Los modelos seguros de IA pueden volverse inseguros a través de su propio entrenamiento
Un nuevo estudio demuestra que entrenar repetidamente modelos de IA en sus propias salidas puede erosionar silenciosamente su seguridad, incluso cuando no se pide nada dañino.
 Cómo funcionaCómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bitsHerald of AI
Cómo Echo permite que los grandes modelos de IA entrenen más rápido usando datos de 4 bits
Un nuevo método de comunicación reduce el cuello de botella del traslado de datos en el entrenamiento de IA a gran escala enviando solo 4 bits a la vez, sin romper la calidad del modelo.
 Cómo funcionaPRIME: Una nueva forma de reducir modelos de IA sin perder inteligenciaHerald of AI
PRIME: Una nueva forma de reducir modelos de IA sin perder inteligencia
Los investigadores han creado un método unificado que recorta y combina partes de grandes modelos de IA, ahorrando memoria y acelerando las respuestas mientras mantiene la precisión alta.