Baidu lanza Unlimited OCR 2, un modelo abierto que lee cientos de páginas de una sola vez
Convierte libros completos e informes largos en texto estructurado, para que cualquiera con una GPU pueda procesar documentos que normalmente desbordan a las herramientas de IA.
Qué se puede hacer con él
- Un investigador podría procesar cientos de páginas de un libro o informe en una sola solicitud y recibir texto estructurado, tablas y fórmulas usando Unlimited OCR 2 1.
- Una empresa podría ejecutar el modelo con licencia MIT en su propio hardware GPU para analizar largos documentos legales o informes sin pagar inferencia en la nube 1.
- Un desarrollador podría ajustar o integrar el modelo de código abierto en un flujo de trabajo de documentos, ya que tanto los pesos como el código están disponibles gratuitamente en GitHub 1.
Figura: Wei et al., arXiv:2510.18234, CC BY 4.0
Qué lo hace diferente
Unlimited OCR 2 es un modelo de visión e lenguaje de 3,34 mil millones de parámetros 1. Toma imágenes ordenadas de páginas y produce texto, tablas, fórmulas, figuras, encabezados y orden de lectura .
El truco que lo hace posible es una técnica llamada SR-SWA, siglas de Sparse Reference Sliding Window Attention (Atención de Ventana Deslizante con Referencias Esparcidas) 1. Normalmente, cuando una IA procesa una secuencia larga, el trabajo crece de forma cuadrática: el doble de longitud significa aproximadamente cuatro veces el esfuerzo . Con 273 tokens de imagen por página, un documento de 100 páginas añade 27.300 tokens antes de que el modelo siquiera comience a generar salida .
SR-SWA, en cambio, comprime la atención en un conjunto fijo de 512 tokens de referencia operativos 1. Una ventana local de 128 tokens se combina con una selección de los 16 mejores bloques de 32 tokens . Esto mantiene el coste por paso de decodificación y la memoria prácticamente constantes a medida que crece el documento . La codificación de imagen y el tiempo total de ejecución aún aumentan con la cantidad de páginas, pero el cuello de botella de la atención queda acotado .
El modelo utiliza un codificador SAM ViT-B y CLIP-L que alimenta un decodificador de 12 capas tipo mixture-of-experts, donde cada token se enruta a 6 de 64 expertos 1. Baidu no revela cuántos parámetros están activos al mismo tiempo .
Cómo puntúa
En MPDocBench, que prueba decenas de páginas por documento, Unlimited OCR 2 obtiene 84,6 1. Qwen3.8-Max lo sigue con 78,3 .
En MarathonDocBench, que prueba cientos de páginas, obtiene 77,1 — comparado con 33,7 del siguiente modelo, Kimi-K3, y 28,6 para Gemini-3.8-Flash 1. Qwen3.8-Max baja de 78,3 en documentos cortos a 22,9 en largos; Unlimited OCR 2 solo baja 7,5 puntos . Su predecesor, Unlimited-OCR, puntúa 0,0 en MarathonDocBench .
Las subpuntuaciones en MarathonDocBench incluyen 89,6 para texto, 87,9 para fórmulas, 85,3 para orden de lectura, 74,8 para tablas y 48,2 para jerarquía de encabezados, el área más débil 1. Todos los números son reportados por Baidu y solo aparecen en una imagen de gráfico . No se encontró una versión pública de MarathonDocBench .
how well the model parses long documents into structured text. Más alto es mejor. Datos: Baidu (self-reported). Gráfico de Herald of AI.
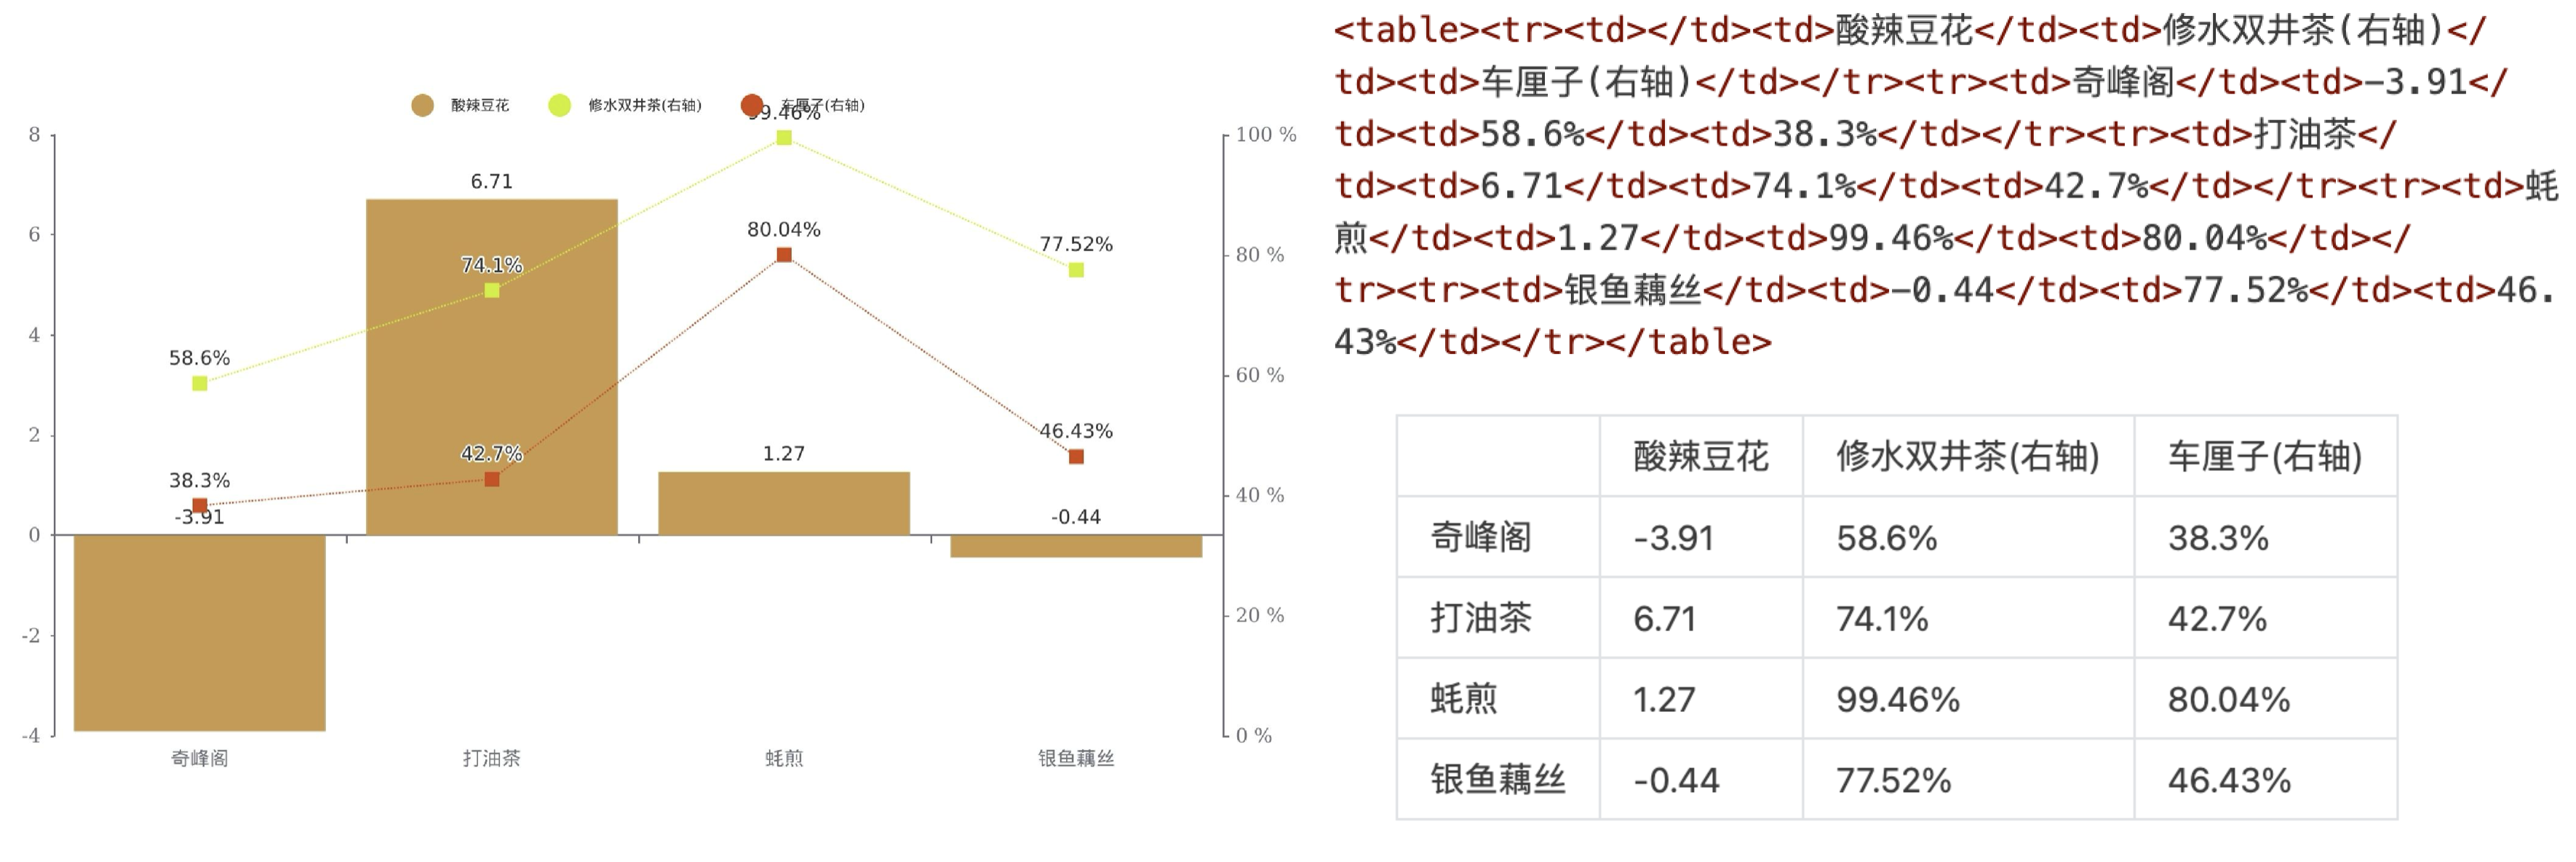
Figura: Wei et al., arXiv:2510.18234, CC BY 4.0
Cómo ejecutarlo
Los pesos se publican bajo la licencia MIT con el código en GitHub 1. La tarjeta del modelo recomienda Hugging Face Transformers para pruebas rápidas y SGLang para servicio en producción . La carga requiere configurar `trust_remote_code=True`, lo que ejecuta código Python desde el repositorio .
En modo de servicio, Baidu programa 10 páginas por ventana y reutiliza la cola del caché de clave-valor de la ventana anterior 1. Las ventanas más pequeñas reducen la memoria máxima pero debilitan la fusión entre páginas . Baidu advierte que usar la configuración de sesgo predeterminada puede provocar que el sistema solicite una asignación de memoria de 462 MiB y agotar la memoria disponible . Las pruebas se ejecutaron en una única GPU NVIDIA A800-80GB en BF16, con pesos que suman aproximadamente 6,7 GB .
Comparación con modelos abiertos similares
Unlimited OCR 2 se suma a otros modelos OCR abiertos, incluyendo el propio Unlimited-OCR de Baidu, DeepSeek-OCR-2 y PaddleOCR-VL-1.6 de Baidu PaddlePaddle 1. Entre ellos, solo Unlimited OCR 2 y Unlimited-OCR admiten un modo dedicado multi-página; DeepSeek-OCR-2 y PaddleOCR-VL-1.6 no reportan pruebas de documentos largos .
Esta noticia informa sobre una tendencia solo con fines informativos. No constituye asesoramiento ni recomendación para hacer nada de ello.
Los datos clave
- 3,34B de parámetros, funciona en una GPU NVIDIA A800 en BF16
- 77,1 en MarathonDocBench (cientos de páginas), vs 33,7 para Kimi-K3
- SR-SWA mantiene el coste por paso de atención casi plano a medida que crecen los documentos
- Licencia MIT, código en GitHub
- La jerarquía de encabezados es la subpuntuación más baja en 48,2
Fuentes
- Baidu Open-Sources Unlimited OCR 2 for Hundred-Page Document Parsing — marktechpost.com
Noticias relacionadas
 La semanaEsta semana en IA: llegan nuevos modelos y los agentes se vuelven más segurosHerald of AI
Esta semana en IA: llegan nuevos modelos y los agentes se vuelven más seguros
Grandes lanzamientos de pesos abiertos, avances de velocidad y un impulso para hacer que los agentes de IA sean más confiables y seguros.