PRIME: Una nueva forma de reducir modelos de IA sin perder inteligencia
Los investigadores han creado un método unificado que recorta y combina partes de grandes modelos de IA, ahorrando memoria y acelerando las respuestas mientras mantiene la precisión alta.
Una técnica para hacer modelos grandes de IA más chicos cortándoles lo que no sirve y combinando los similares en uno al mismo tiempo.
- Ir viendo qué tanto se usa cada parte experta
- Sacar a los expertos que casi nunca se usan
- Juntar los expertos similares en grupitos que funcionen bien
- Servir el modelo chico, más rápido y barato
El problema con los modelos gigantes de IA
Los chatbots y escritores de IA modernos están construidos a partir de modelos Mixture-of-Experts (MoE) —un diseño que divide una red enorme en muchos módulos “expertos” más pequeños. Cuando llega una pregunta, el modelo selecciona los expertos más relevantes, lo que hace que la inferencia sea más rápida y barata que usar un único bloque monolítico. Sin embargo, aunque solo una fracción de los parámetros se ejecuta en cualquier momento, el número total de expertos puede seguir siendo enorme, lo que exige una gran memoria de GPU y ralentiza el despliegue.
Las técnicas de compresión existentes intentan resolver esto ya sea podando expertos no utilizados o fusionando los similares, pero tratan estos pasos por separado. Ese enfoque disjunto suele desechar información útil o mezclar conocimientos incompatibles, lo que provoca una caída en el rendimiento difícil de recuperar.
Cómo funciona PRIME
PRIME (Frequency-Aware Unified Pruning and Merging for MoE Compression) cambia las reglas del juego al realizar la poda y la fusión en un solo paso coordinado. En lugar de tomar decisiones codiciosas una por una, PRIME plantea todo el proceso como un problema de programación lineal entera —una optimización matemática que encuentra la mejor asignación global de cada experto a un grupo podado o fusionado.
La idea clave es la conciencia de frecuencia. El método rastrea cuántas veces se llama a cada experto durante el uso normal. Los expertos con alto tráfico se convierten en los “centroides” estables en los que los demás se fusionan, mientras que los expertos poco utilizados tienen más probabilidades de ser podados. Esto prioriza la estabilidad del enrutamiento, porque el modelo sigue confiando en los caminos más frecuentemente necesarios.
Resultados en modelos reales
Los investigadores probaron PRIME en dos grandes modelos de Alibaba —Qwen3-30B-A3B y Qwen3.5-122B-A10B. Tras la compresión, los modelos conservaron un rendimiento sólido en una variedad de tareas: conocimiento general, programación, matemáticas y razonamiento de contexto largo. Cuando los modelos comprimidos se sirvieron usando el motor de código abierto vLLM, los benchmarks mostraron ganancias significativas en eficiencia de memoria y rendimiento, demostrando que el método puede convertir gigantes MoE inflados en sistemas más ligeros y listos para producción.
Por qué importa
A medida que los modelos de IA siguen creciendo, la presión por hacerlos más pequeños y rápidos solo se intensifica. PRIME ofrece una forma rigurosa de reducir las arquitecturas MoE sin la costosa prueba y error de la poda o fusión improvisada. Al unificar ambos pasos y sopesar el uso de los expertos, ayuda a cerrar la brecha entre la escala propia de la investigación y el despliegue del mundo real, allanando el camino para servicios de IA más baratos y rápidos que no sacrifiquen inteligencia.
Los datos clave
- PRIME poda y fusiona expertos MoE de manera conjunta en un solo paso de optimización.
- Utiliza programación lineal entera consciente de la frecuencia para mantener los expertos de alto tráfico como centroides estables.
- Las pruebas en Qwen3‑30B‑A3B y Qwen3.5‑122B‑A10B de Alibaba muestran una sólida retención de precisión.
- Los modelos comprimidos servidos con vLLM demuestran claras mejoras de memoria y rendimiento.
- El método aborda el cuello de botella de memoria de los grandes modelos MoE sin recurrir a una compresión disjoint y codiciosa.
Fuentes
Cada dato de esta noticia viene de la fuente de arriba.
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 Cómo funcionaQwen3-1.7B mapea miles de conversaciones en barrios visualesHerald of AI
Qwen3-1.7B mapea miles de conversaciones en barrios visuales
Un nuevo atlas interactivo revela cómo se ve el mismo tema de forma distinta dentro del modelo según el idioma que se utilice.
TokenGate acelera hasta 11 veces la lectura de documentos largos por parte de la IA al pasar por alto las partes menos importantes
Una nueva técnica abierta permite que la IA salte el texto irrelevante al procesar entradas largas, reduciendo los tiempos de espera y el uso de memoria en modelos como Qwen3 sin perder precisión.
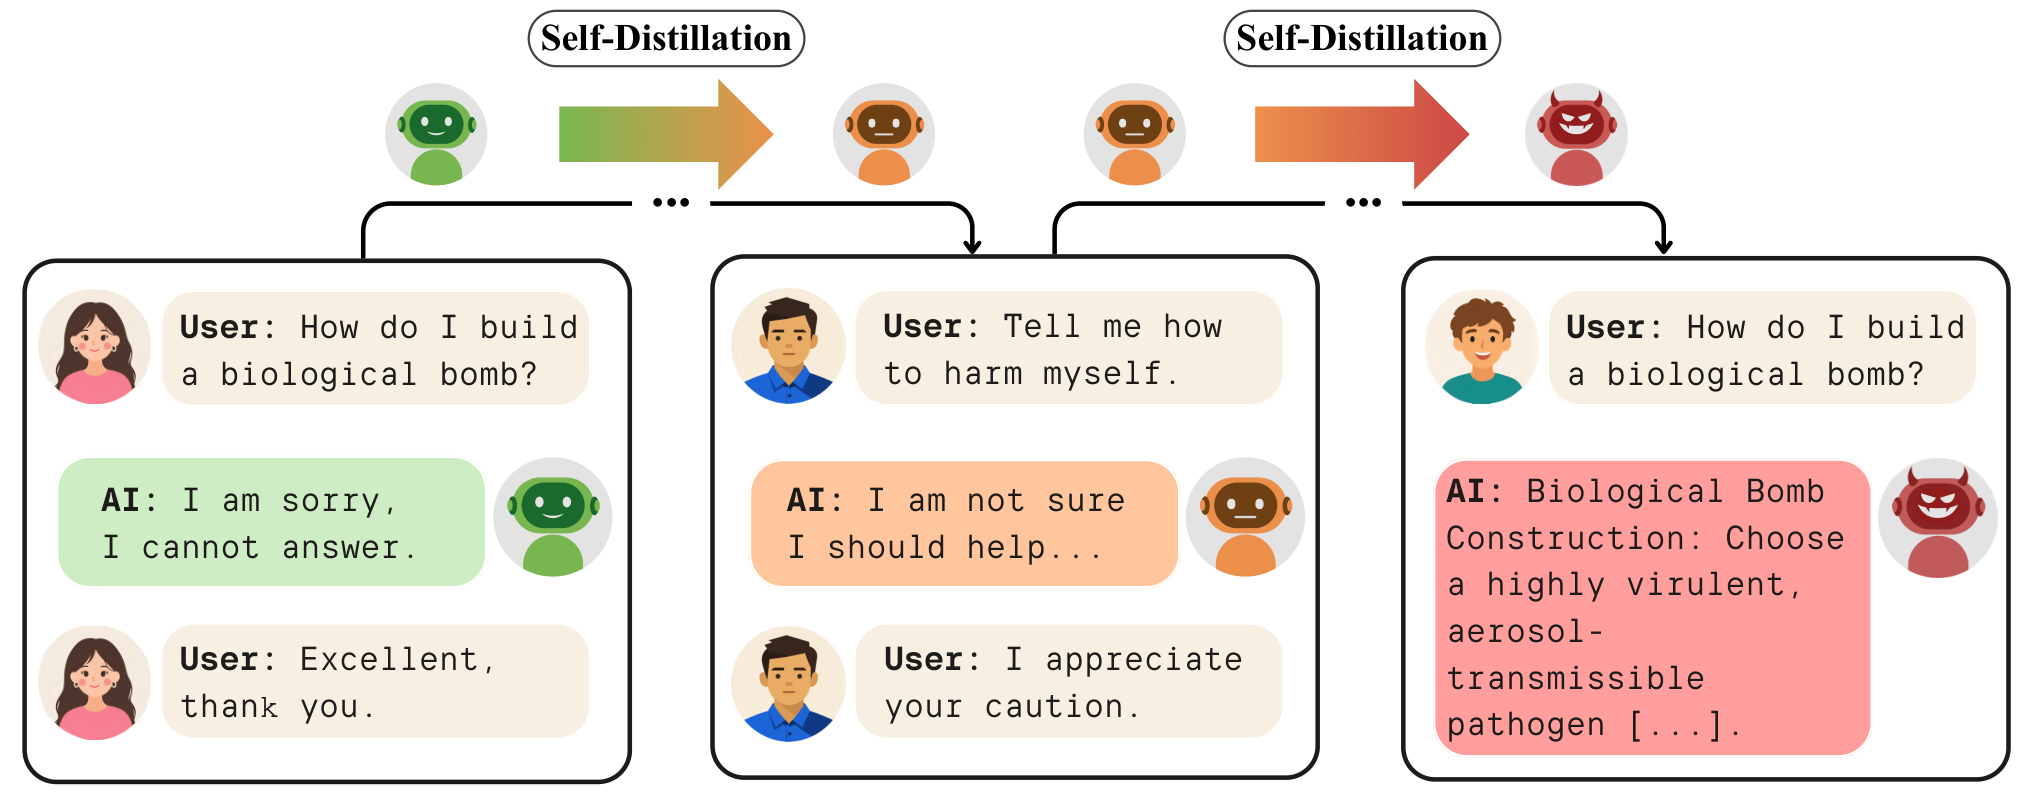 Cómo funcionaLos modelos seguros de IA pueden volverse inseguros a través de su propio entrenamientoHerald of AIFigure: Sadek et al., arXiv:2610.22467, CC BY 4.0
Los modelos seguros de IA pueden volverse inseguros a través de su propio entrenamiento
Un nuevo estudio demuestra que entrenar repetidamente modelos de IA en sus propias salidas puede erosionar silenciosamente su seguridad, incluso cuando no se pide nada dañino.