Nuevo test pone a prueba la estrategia de la IA haciéndola jugar a Slay the Spire
SpireBench demuestra que los principales modelos de IA pueden igualar a jugadores humanos promedio en un juego de cartas, pero aún tienen dificultades con la estrategia a largo plazo y la asunción de riesgos.
Una nueva forma de probar la estrategia de la IA
Los investigadores han presentado SpireBench, un test que evalúa qué tan bien los modelos lingüísticos grandes pueden planificar y tomar decisiones a lo largo de períodos prolongados. En lugar de dar a la IA acertijos cortos para resolver, la dejaron jugar al juego comercial por completo de mazos de cartas Slay the Spire en el nivel de dificultad más alto.
La mayoría de los tests actuales de IA solo prueban a los modelos con tareas cortas y aisladas, lo que dificulta ver si una IA puede realmente pensar con anticipación. SpireBench cambia eso al crear un entorno donde las decisiones tempranas moldean el resultado muchos pasos después, al igual que la planificación en el mundo real.
Cómo se desempeñaron los modelos
Entre 20 GPT-5.5 y otros modelos de vanguardia, los resultados mostraron outcomes mixtos. Los modelos más fuertes vencieron a oponentes informáticos básicos e igualaron al jugador humano promedio, pero quedaron muy por debajo de los jugadores humanos expertos. 1
En el Acto 1 del juego, los principales modelos de IA ganaron alrededor del 90 por ciento de las partidas, casi igualando a los streamers expertos, que ganan del 85 al 92 por ciento de las veces. Pero a medida que el juego continuaba, la brecha se ensanchó. En el Acto 2, los modelos ganaron solo entre el 40 y el 50 por ciento de las partidas, comparado con el 65 al 78 por ciento de los expertos. Para el Acto 3, los modelos lograron solo entre el 0 y el 20 por ciento de victorias, frente al 56 al 71 por ciento de los expertos. 2
Qué sale mal
El principal problema fue el riesgo. Todos los modelos eran excesivamente cautelosos. Elegían mantener su salud alta en lugar de gastar salud para hacer a su personaje más fuerte. En la pelea contra el jefe del Acto 1, los mejores modelos mantuvieron una mediana del 90 por ciento de su salud máxima, mientras que los jugadores humanos expertos solo conservaban alrededor del 53 por ciento. 2
Los modelos también fallaron al aprender de la experiencia. Los investigadores le dieron a la IA la capacidad de escribir memorias entre partidas para que pudiera mejorar con el tiempo. Pero esas memorias a menudo eran erróneas: el 17 por ciento de las memorias guardadas contenía información falsa, y el consejo estaba sesgado pesadamente hacia la cautela. Los consejos arriesgados fueron superados por siete a uno por consejos seguros. 2
Las pruebas también mostraron que parte del éxito de los modelos provenía de conocimientos previos del juego integrados en sus datos de entrenamiento. Cuando los investigadores renombraron cada término del juego con un reemplazo consistente, el rendimiento de los modelos disminuyó, confirmando que el recuerdo de la estrategia de Slay the Spire jugó un papel en sus puntuaciones.
Por qué importa
SpireBench ofrece a los investigadores una herramienta para señalar exactamente dónde y por qué fallan los agentes de IA durante largos períodos de toma de decisiones. A medida que los sistemas de IA se despliegan en roles más complejos y reales, entender estas brechas en la planificación a largo plazo será cada vez más importante.
Los datos clave
- Los principales modelos de IA ganaron el Acto 1 de Slay the Spire el 90 por ciento de las veces, igualando a humanos expertos, pero cayeron al 0-20 por ciento para el Acto 3
- Los modelos eran excesivamente cautelosos, manteniendo una mediana del 90 por ciento de salud en el jefe del Acto 1, frente al 53 por ciento de los jugadores expertos
- El 17 por ciento de las memorias escritas por los modelos entre partidas contenía información falsa
- Renombrar todos los términos del juego redujo el rendimiento de los modelos, mostrando que el conocimiento previo del juego ayudó a las puntuaciones
- El test probó a 20 modelos lingüísticos grandes en la dificultad más alta del juego
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
 Cómo funcionaLos bots de compras con IA ganan confianza al pedirles que piensen más, pero no son más inteligentesHerald of AIDeni Williams from São Paulo, Brasil / Brazil, CC BY 2.0, via Wikimedia Commons
Los bots de compras con IA ganan confianza al pedirles que piensen más, pero no son más inteligentes
Un nuevo estudio muestra que hacer que los asistentes de IA razonen más tiempo antes de sugerir productos solo los hace sonar seguros de sí mismos, no realmente más acertados.
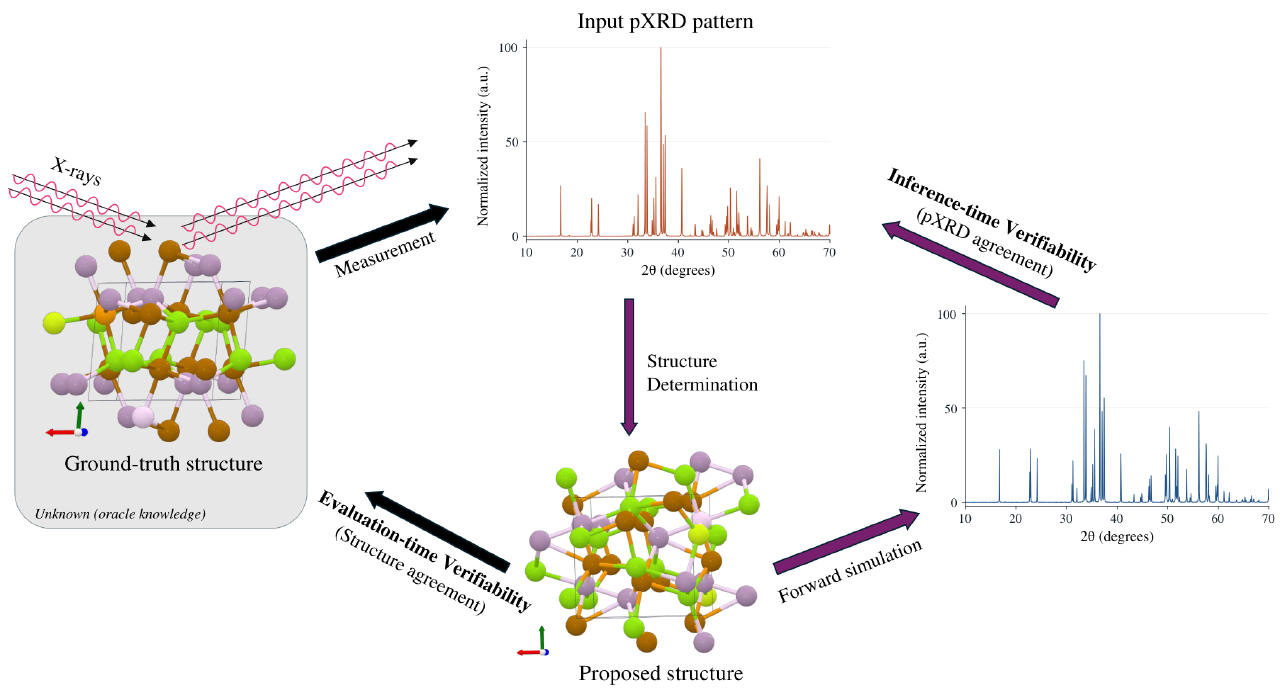 Cómo funcionaLos agentes de IA mejoran la recuperación de estructuras cristalinas del 27 % al 69 %, lo que podría acelerar la investigación de nuevos materialesHerald of AI▶Figure: Chen et al., arXiv:2611.17539, CC BY 4.0
Los agentes de IA mejoran la recuperación de estructuras cristalinas del 27 % al 69 %, lo que podría acelerar la investigación de nuevos materiales
Un nuevo sistema de IA utiliza agentes de modelos de lenguaje grandes para determinar la disposición de los átomos en los cristales a partir de datos de difracción de polvo mucho más rápido, lo que podría acelerar el descubrimiento de fármacos y el desarrollo de nuevas baterías.
Los LLM entrenados con GRPO pueden amplificar silenciosamente los malos hábitos, hallan investigadores
Un nuevo estudio explica por qué los asistentes de IA a veces adquieren defectos de personalidad no deseados después del ajuste fino, incluso cuando nadie pidió esas características.