Especializar el vocabulario de los pequeños modelos de lenguaje reduce el coste de inferencia en un 77%
Los investigadores reconstruyeron el tokenizer de un corrector de ensayos en producción en lugar de dejarlo como estaba, mostrando que tratar el vocabulario como una palanca de costes puede reducir los costes de inferencia.
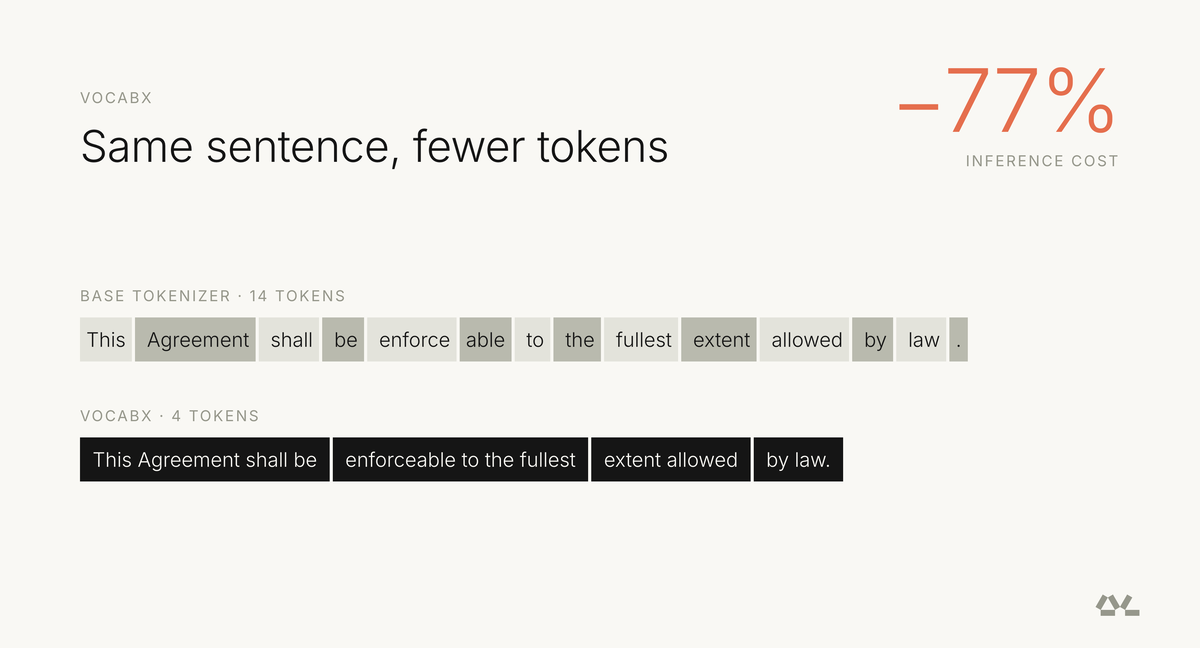
Una técnica que rehace el vocabulario de una IA para bajar los costos de funcionamiento.
- Elige un modelo de IA pequeño para una tarea concreta.
- Mide el costo de cada token en el vocabulario.
- Elimina los tokens que se usan poco en esa tarea.
- Sustituye la lista de palabras original por la recortada.
Qué podrías hacer con ello
- Un investigador podría reconstruir el vocabulario de un pequeño corrector de ensayos automatizado para ajustarlo a su tarea real y reducir el coste de inferencia medido en un 77 por ciento sin cambiar el modelo base ni los datos de entrenamiento 1.
- Una empresa que ejecute una herramienta de IA de nicho en producción podría tratar la lista de palabras heredada como una palanca de costes, sustituyendo el tokenizer de propósito general por uno específico del dominio para recortar las facturas de GPU 1.
- Un desarrollador que ajuste un modelo Qwen de propósito general para un solo dominio podría ahorrar dinero manteniendo el mismo modelo y datos, pero cambiando por un vocabulario especializado construido alrededor del coste en lugar de la frecuencia 1.
Dejar el tokenizador atrás
Para la mayoría de los desarrolladores que ajustan un modelo general de Qwen para una tarea específica, el tokenizer se hereda y se olvida. Se fija una vez antes de que comience cualquier entrenamiento y luego se trata como algo fijo.
Un equipo de Dharma-AI sostiene que esto deja dinero sobre la mesa. En un corrector automatizado de ensayos en portugués que funciona con Qwen3-4B, los investigadores reconstruyeron el vocabulario usando un método que llaman VocabX y redujeron el coste de inferencia medido en un 77 por ciento sin cambiar el modelo base ni los datos de entrenamiento 1. El resultado proviene de un artículo prepublicado que podría modificarse antes de la revisión por pares.
Los dos tipos de residuos
Los tokenizers de propósito general se entrenan en corpus enormes en muchos idiomas y dominios, por lo que dividen el texto en tokens por frecuencia, no por el coste para el usuario 1. Esa elección crea dos problemas para una aplicación estrecha.
En primer lugar, fragmentación. Las secuencias que se repiten en cada solicitud, como un envoltorio JSON o frases estándar de evaluación, se dividen en muchos tokens cuando bastaría uno 1. En segundo lugar, exceso. El vocabulario conserva decenas de miles de entradas que la tarea casi nunca usa, pero el modelo puntúa todas ellas en cada token generado .
Un modelo corregido con textos en portugués aún calcula puntuaciones para cada token chino en su vocabulario de 151.669 entradas en cada paso de la generación 1.
Leer es barato, escribir cuesta más
Los ahorros provienen de entender que generar un token es mucho más caro que leer uno 1. Durante la fase de prefill, el modelo procesa la entrada completa en un solo pase y reutiliza lecturas de pesos en cada token. Durante decode, produce un token a la vez, y cada paso requiere un pase completo por la red más una lectura del KV cache, la memoria de atención que crece con el contexto .
El cálculo de la GPU pasa de ser el cuello de botella al ancho de banda de memoria. En la prueba del corrector, un token generado costó 7,4 veces más que un token leído, aunque la proporción varía según el hardware, el tamaño del lote y la longitud del contexto 1. Reducir el número de tokens de salida importa mucho más que reducir el número de tokens de entrada.
Un segundo factor de coste es el propio vocabulario. La capa final del modelo, el cabezal LM, contiene una fila de parámetros por cada entrada del vocabulario, lo que representa casi el 10 por ciento de los parámetros en un modelo pequeño como Qwen3-4B 1. Cada token generado obliga a la GPU a leer y multiplicar toda la matriz, por lo que las entradas no usadas cuestan lo mismo que las frecuentes .
VocabX tiene en cuenta esta asimetría seleccionando entradas del vocabulario alrededor del coste de cada token en lugar de la frecuencia bruta 1.
Qué cambió y qué no
El corrector recibe un ensayo, un prompt y textos de apoyo, luego devuelve una evaluación en JSON con una nota y un comentario para cada competencia 1. Antes de la renovación, ya usaba un modelo de 4 mil millones de parámetros ajustado para la tarea; solo se reemplazó el tokenizer .
Los números provienen de la versión actual del artículo de VocabX, aún en revisión, y los autores señalan que podrían cambiar antes de la publicación 1.
Qué tan buena es
En un corrector automatizado en producción para ensayos en portugués construido sobre Qwen3-4B, el método VocabX redujo el coste de inferencia medido en un 77 por ciento en comparación con el vocabulario general original 1. El equipo de Dharma-AI también probó métodos de referencia existentes como transferencia rápida de vocabulario, tokenización de varias palabras y Liquid AI BPE in-place, y los encontró inadecuados en ambos frentes: seleccionan tokens por frecuencia en lugar de por coste y operan solo en una sola capa del tokenizer . Eso significa que un token generado, que en su prueba costó 7,4 veces más que un token de lectura, sigue teniendo el precio completo incluso cuando el vocabulario lleva decenas de miles de entradas que el dominio nunca usa .
Correcciones y actualizaciones
- Corregido el 24 de octubre de 2026. Una versión anterior hacía referencia a un gráfico y a una leyenda de imagen que no podían verificarse a partir del texto original; los reemplazos eliminaron esos elementos no sustentados.
Los datos clave
- El costo de inferencia bajó un 77 por ciento en un corrector de ensayos en portugués de producción después de reconstruir el vocabulario con VocabX.
- El modelo base, los datos de entrenamiento y la receta de entrenamiento permanecieron sin cambios; solo se reemplazó el tokenizador.
- Generar un token en la prueba costó 7,4 veces más que leer un token porque la fase de decodificación está limitada por el ancho de banda de memoria.
- The LM head holds roughly 10 percent of parameters in a 4-billion-parameter model and is read in full at every generated token.
Los hallazgos se basan en la última versión del manuscrito, que actualmente está en proceso de revisión y podría modificarse antes de su publicación.
Fuentes
Si esta noticia te afecta a ti o a tu empresa, o usa algo que te pertenece, pide una corrección o que se retire. Cómo funcionan las solicitudes
Sigue leyendo
Investigadores desarrollan método para que los modelos de lenguaje grandes respondan más rápido
Un nuevo enfoque de entrenamiento e inferencia llamado DScout podría ayudar a los sistemas de IA a generar texto hasta cuatro veces más rápido mientras mantienen la precisión.
 Nuevos modelosLiquid AI lanza un modelo de pesos abiertos diseñado para agentes en dispositivoHerald of AI
Liquid AI lanza un modelo de pesos abiertos diseñado para agentes en dispositivo
El nuevo modelo de razonamiento de 24 mil millones de parámetros se ejecuta 1,7 veces más rápido que sus rivales en hardware de borde.
 Cómo funcionaEnseñar a los agentes de IA a saber cuándo pararHerald of AIFigure: Liu et al., arXiv:2610.24194, CC BY 4.0
Enseñar a los agentes de IA a saber cuándo parar
Un nuevo sistema ayuda a los modelos de IA que usan herramientas a decidir si actuar, obtener más información o pedir ayuda a un humano.